
AIGC商务数据分析与应用:教材教会你算数,没教你别信这张表
微信读书《AIGC商务数据分析与应用》· 张珺、刘娟 主编 · 八项目
逐页翻阅 3000 屏 · 8 个项目 · 2026-11-04
说明:这是一本教材(前言列了配套 PPT、教学大纲、教案、课程标准,供用书老师下载),所以它必须照顾零基础,也必须可教可考——这两条约束本身就是它所有长处的来源,也是它所有短处的来源。我抽了九处逐页核对:企业介绍与目录、数据收集与快递价格表、Power Query 合并工作簿、市场容量测算、目标与实际营收差值表、商品结构气泡图、客户画像标签表、透视表与环比增幅、思考题。以下判断都只在抽样范围内成立。
先给结论:这本书把"商务数据分析"写成了一条车间流水线——采集、预处理、分析、报告,四段,每段都细到点哪个按钮、输什么公式。作为入门教材,它合格,甚至比多数同类更老实。但它有一个贯穿全书的默认前提:数据是干净的、口径是对的、结论是算得出来的。而这一行的失败,八成发生在表格之外。
所以我不打算复述它讲了什么。我想说的是:它教会你的那部分,边界在哪;它没教的那部分,代价多大。
一、它的骨架:一条真正的流水线
八个项目,顺序是:AIGC 与商务数据分析概述、数据收集与预处理、分析方法与报告撰写、行业数据分析、商品数据分析、营销推广数据分析、客户数据分析、服务数据分析。每个项目底下二到三个任务,最后必配"综合实训"和"思考题"。
这个顺序是对的,而且不是"看起来对"。采集—清洗—方法—场景,正好是一个人从接到需求到交出报告的实际路径。很多同类书会把它按"工具"来排:Excel 一章、Power BI 一章、Python 一章,学完不知道先干什么。这本书按"活儿"来排,这一点比工具书高一层。
更能说明它自我定位的,是每个任务末尾那段"任务小结"。比如项目二收集数据那一节,小结是这样写的:
本任务围绕商务数据的收集来展开,系统学习了三大核心内容:其一,明确了商务数据收集需遵循的原则,为保证数据质量奠定基础;其二,介绍了多种收集商务数据的方法,为实践操作提供了参考;其三,规范了数据收集的标准流程,确保收集工作有序高效地开展,并介绍了使用爬虫软件和AI工具获取数据的具体操作方法,为运营者精准、合规地获取数据提供了全面指导。
这段话的句式很典型:三个"其一其二其三",三个动词是"明确了""介绍了""规范了"。全是教学过程词,没有一个是结果词——没有"这样收集的数据,误差控制在多少",没有"如果跳过了这一步,后面会出什么错"。
我不认为这是作者偷懒。这是教材这个体裁的必然:它的验收对象是"学生是否学过",不是"读者是否做对"。学过和做对之间,隔着的正好是这门课最难教的部分。
二、最实用的一页:客户画像的五类标签
全书我最想推荐给做运营的人抄走的,是项目七里那张"客户画像常见标签类型"表。它把标签分成五类,我按原表抄下来:
基础属性标签:人口统计学特征,如性别、年龄、地域、职业、家庭角色等。示例:女,25~30岁,广东深圳,白领,单身。
行为标签:客户在平台的行为、动态,如活跃频率、活跃时段、浏览深度、加购-下单转化率、活动参与类型等。示例:近7天浏览美妆5次、活跃时段20:00—22:00、加购后70%以上下单、偏好满减等。
消费标签:反映客户的消费能力与习惯,如客单价、月均消费金额、价格敏感度、支付方式偏好等。示例:客单价200~500元、月均消费金额350元、促销时购买频率较高、通常使用支付宝支付。
偏好标签:对商品或服务的具体倾向,如核心品类偏好、品牌倾向、功能偏好、物流要求、互动偏好等。示例:更喜欢彩妆、喜欢国产品牌、注重彩妆的防水性能、要求次日达、喜欢晒单返现等。
价值标签:客户对店铺的贡献,如最近消费时间、消费频次、累计消费金额、所处生命周期阶段等。示例:最近3天前消费、月消费4次、累计消费金额560元、成熟客户等。
这张表好在哪?好在它把"用户画像"这件长期被讲成玄学的事,变成了五列填空。而且它顺手给出一个判断法:五类标签其实对应五个不同的问题——她是谁、她干了什么、她花了多少、她喜欢什么、她值多少。做运营的人只要有一列填不满,立刻就知道自己缺哪一类数据。
它后面还给了个体画像和群体画像的差别,两个例子写得很具体:个体是"张女士,28岁,上海,白领,近30天购买2次护肤品,客单价600元,偏好保湿类,对赠品敏感";群体是"25~30岁一线城市女性白领,活跃高峰在20:00—22:00,平均浏览3个商品后下单,月均消费2~3次,偏好'满200元减50元'促销,常买品类为护肤品+连衣裙,对物流时效要求高,超过3天易投诉,反感过度推送广告"。
还有一处小的混用,顺手记下来:行为标签里的例子写"加购后70%以上下单"。这其实是个转化率,是"指标",不是"标签"。标签是给人打的一个属性(比如"高意向""只逛不买"),指标是算出来的一个数。两者混在一起,后果是画像建完了,你不知道该拿它做什么——标签可以用来分群投放,指标只能用来做看板。把指标当标签用,是画像项目最常见的死法:做了一百个字段,一个圈都圈不出来。
但这里就是我要提出第一个批评的地方:它把五类标签并列摆出来,好像它们同等重要、同等可得。实际上这五类的获取成本差了一个数量级。
基础属性、行为、消费这三类,自家的订单后台和埋点里直接就有;偏好类要靠问卷、评论挖掘或者模型推断,成本高且不准;价值类要先定义生命周期阶段,而"成熟客户"到底是按累计金额还是按购买频次算,教材没给口径——原表只写了"成熟客户等",这个"等"字后面就是全部工作量。
这个成本差直接决定了一件事:绝大多数中小店铺,实际上只做得到前三类标签。而市面上那些"精准用户画像"的服务,卖的多半是第四、第五类的猜测。教材如果补一句"这五类的获取成本不一样,先从你能拿到的三类开始",这一页的价值会翻倍。它没补。
三、那 162 万:公式很漂亮,依据是空的
项目四讲市场行情分析,给了市场容量的推算法,例子是这样的:
市场容量(销售额)=30 000×12%×1×450=1 620 000(元/年)
拆开看,四个乘数:目标人群 30 000、渗透率 12%、年均购买次数 1、客单价 450 元。
这是个标准公式,骨架是"人群 × 渗透 × 频次 × 单价",没错。问题在第二个乘数上:12% 是从哪来的?书里没有给。没有调研、没有对标、没有历史数据,也没有一句"此处为假设值"。
这一步之差,决定了一个数字是"测算"还是"报价"。测算的特征是可复核:换个人来,用同样的假设,能得到同一个数,并且知道这个数在什么范围内可信。报价的特征是只有一个数,看起来很精确,精确到个位。1 620 000 这个数,精确到了万位以下,而它最关键的假设是个约数——精确的位置放错了,这比不精确更危险,因为它会让人以为已经算过了。
做一个很简单的敏感性检验:渗透率如果是 6%,容量是 81 万;如果是 18%,容量是 243 万。三个数字之间的差距,足以让一份"值得投入"的结论翻成"不值得"。一个只靠单一假设撑起来的结论,等于没结论——它的全部信息量都在那个假设里,而假设没有出处。
有意思的是,这本书自己其实知道要小心。紧接着它就写了"无论采用何种方法推算市场容量,运营者均需明确以下关键维度",列了三条:商品或服务范围(是广义的"女装"还是细分的"大码女装")、地理范围(全球、国家、省、市或特定商圈)、时间范围(当前还是三年五年后)。
这三条都对,但它们全是"界定范围",没有一条是"检验假设"。这就是教材和实战的那道分界线:教材教你如何框定问题,实战要求你证伪假设。框定问题只需要想清楚,证伪假设需要去现场——去问十个客户、去翻竞品的销量、去拿一个月的试投放数据。后者是苦活,也是这门手艺真正的门槛。
如果我要改这一页,会加一个小节,标题就叫"这个 12% 有几种可能错":如果人群基数用的是全市常住人口,会把不可能买的人算进来,渗透率会被摊薄;如果客单价用的是标价不是成交价,会高估三成;如果频次用的是复购客户的数据,会高估整体。三条都是常见错法,每条都能把结论推翻一次。
四、差值表:它教你画图,没教你读图
项目三讲报告撰写,给了一个"营收目标与实际完成对比"的练习:在素材文件里加"差值"列,D2 输 =C2-B2,往下填充,再插入组合图——目标值用柱形,实际营收用折线,差值用带数据标记的折线。
表里十二个月的数字,我抄下来(目标 / 实际 / 差值):1月 140/125/-15,2月 110/120/+10,3月 160/180/+20,4月 210/260/+50,5月 250/270/+20,6月 290/265/-25,7月 330/360/+30,8月 370/420/+50,9月 420/405/-15,10月 480/410/-70,11月 460/410/-50,12月 550/440/-110。
这张表里最值钱的信息,不是"差了多少",是缺口从第 9 个月开始,并且逐月放大:-15、-70、-50、-110。前八个月加起来还是正的(+140),后四个月一口气吐掉 245,全年净差 -105。
一条合格的报告,这一页只需要一句话:"前八个月累计超额 140,9 月起连续四个月缺口扩大,全年差额 -105,其中 12 月单月 -110,需拆分是目标设定问题还是执行问题。"这句话里有两个动作:一是定位拐点,二是提出下一步该查什么。
教材停在了哪一步?它教了公式、教了插入组合图、教了把差值那一条设成带标记的折线,然后在任务小结里写"掌握差值计算与图表呈现"。"呈现"这个词,就是它的天花板——图做出来,任务就算完成;图里那句话读不读得出来,不在考核范围里。
再往下想一层,为什么缺口偏偏在 9 月开始?把两组数分开看就清楚了:目标是 420、480、460、550,一路加码;实际是 405、410、410、440,基本走平。也就是说,不是执行在 9 月崩了,是目标在 9 月脱了轨——实际那条线一直是同一个斜率,目标那条线突然抬了头,两条线才裂开。
这个判断很重要,因为它决定了报告该写什么。如果结论是"执行不力",下一步是问责;如果结论是"目标脱离趋势",下一步是重设目标和补资源。同一张表,两种读法,指向两个完全不同的动作。而教材只教到"算出差值",等于把这张表最关键的判断留在了半路。
这不是苛求。这是数据分析这行最普遍的能力断层:会做图的人很多,能从图里说出一句话的人很少。我给自己的判据很土——一张图如果不能在十秒内说出一句话,就是没做完。这句话必须包含"什么时候"或"哪里"或"谁",而不是"整体向好""略有波动"。差值表的那句话是"拐点在 9 月"。
顺带说一句这张图的画法。目标用柱、实际用折线,是一种常见的做法,但它有个副作用:柱和折线共用纵轴时,折线会贴在柱子顶上,看不出趋势。真正要突出"缺口",应该直接把差值画成柱(正绿负红),目标和实际扔进明细表。图的目的是让人看见差异,不是让人看见数据。教材选了"什么都画上"的方案,稳妥,但也就没有了主张。
五、透视表那串 1.96814E+11
项目四还有一个透视表的例子,做行业交易金额的月度汇总,加了"环比增幅"字段。截图里的表是这样的:
行标签 求和项:交易金额 求和项:交易金额2
1月 20314579782 20314579782
…
总计 1.96814E+11 1.96814E+11
两件事,一件小,一件大。
小的是格式:总计进了科学计数法,1.96814E+11。这个数交到老板手上,他第一眼认不出来这是 1968 亿。教材教了怎么加字段、怎么设值显示方式为"环比增幅",却没教"交出去之前把金额改成万元、或者自定义格式"。这是最不起眼的一道工序,也是"专业"和"学生作业"的分界线。
大的是那两列一模一样的字段。仔细看表头:求和项:交易金额 和 求和项:交易金额2,数值完全相同。这是同一个字段被拖进值区域两次,Excel 自动加了"2"。教材的截图里就摆着这个冗余,而且没有任何一句提示。
这说明什么?说明这些截图是操作过程的截图,不是审校过的成品。做教程最容易被忽略的一点:读者会把你截图里的每一个像素都当成"应该这样"。你随手拖出来的第二列,在读者那里就是"这一步要拖两次"的指令。
我给自己的规矩很朴素:透视表交出去之前,只留三列——口径、金额(万元)、占比;行标签按业务顺序排,不按拼音排;总计行加粗。花两分钟,能省掉三轮来回。数据这门手艺,一半的功夫在交付形态上,因为看的人不会问你算得对不对,他只会问"这个数是多少"。你说"1968 亿",他点头;你说"1.96814E+11",他皱眉头。
六、AI 在这本书里,只是个加速器
项目二预处理里有个很典型的操作:性别列里有些记录把"男"写成"M"、"女"写成"F",先查找替换统一;然后列里还有缺失值,"这里使用性别中的众数填充缺失数据",再用 =COUNTIF(C:C,H2) 统计男女人数。
这个操作本身没毛病,是最常见的入门处理。但我要在这里停下来,因为"众数填充"这四个字,藏着数据分析里最贵的一问:这些值为什么缺?
如果缺失是随机的(比如录入时漏了),填众数只是让分布更尖一点,不影响方向。但如果缺失不是随机的——比如某个渠道的表单根本不采集性别,或者某类用户习惯跳过这一栏——那么填众数就等于把这一部分人全部改写成"多数派",你不仅丢掉了他们的信息,还伪造了一批不存在的人。
而后面所有的分析,都会建立在这批伪造的人身上:性别比例、性别×品类偏好、性别×客单价,一条条往下推,越推越像真的。教材教了怎么填,没教先问一句"为什么缺"。而这一问,决定了你是在补数据,还是在编数据。
这也是我对这本书"AI 部分"的整体评价:它把 AI 放在了正确的位置上——加速器,不是决策者。让 AI 帮忙写清洗公式、帮忙起草报告框架、帮忙把一段话改成书面语,这些它都示范了,而且示范得挺克制,没有吹。
但它缺了另一半:怎么验 AI 给的结论。整本书没有一处讲这个。而在数据分析这个行当,AI 最大的风险不是算错——它算错的概率比人低——是"算对了但你不知道为什么对"。你不知道它的口径,不知道它丢了哪些行,不知道它把"暂无"当成了 0。于是下一次换个数据集,同样的问法,结果就变了,而你没有任何办法判断哪一次是对的。
我自己的四条土办法,写在这儿当补充:一是让它把计算过程逐步写出来,不写过程的结果一律不复用;二是同一件事换三种问法问三遍,答案不一致就说明这个结论不稳;三是抽 5% 的样本手工核,对不上就整批重来;四是所有关键数字必须能追到一行原始记录。报告是要签字的,签字的人只关心一件事:这个数错了,我能不能第一时间知道。
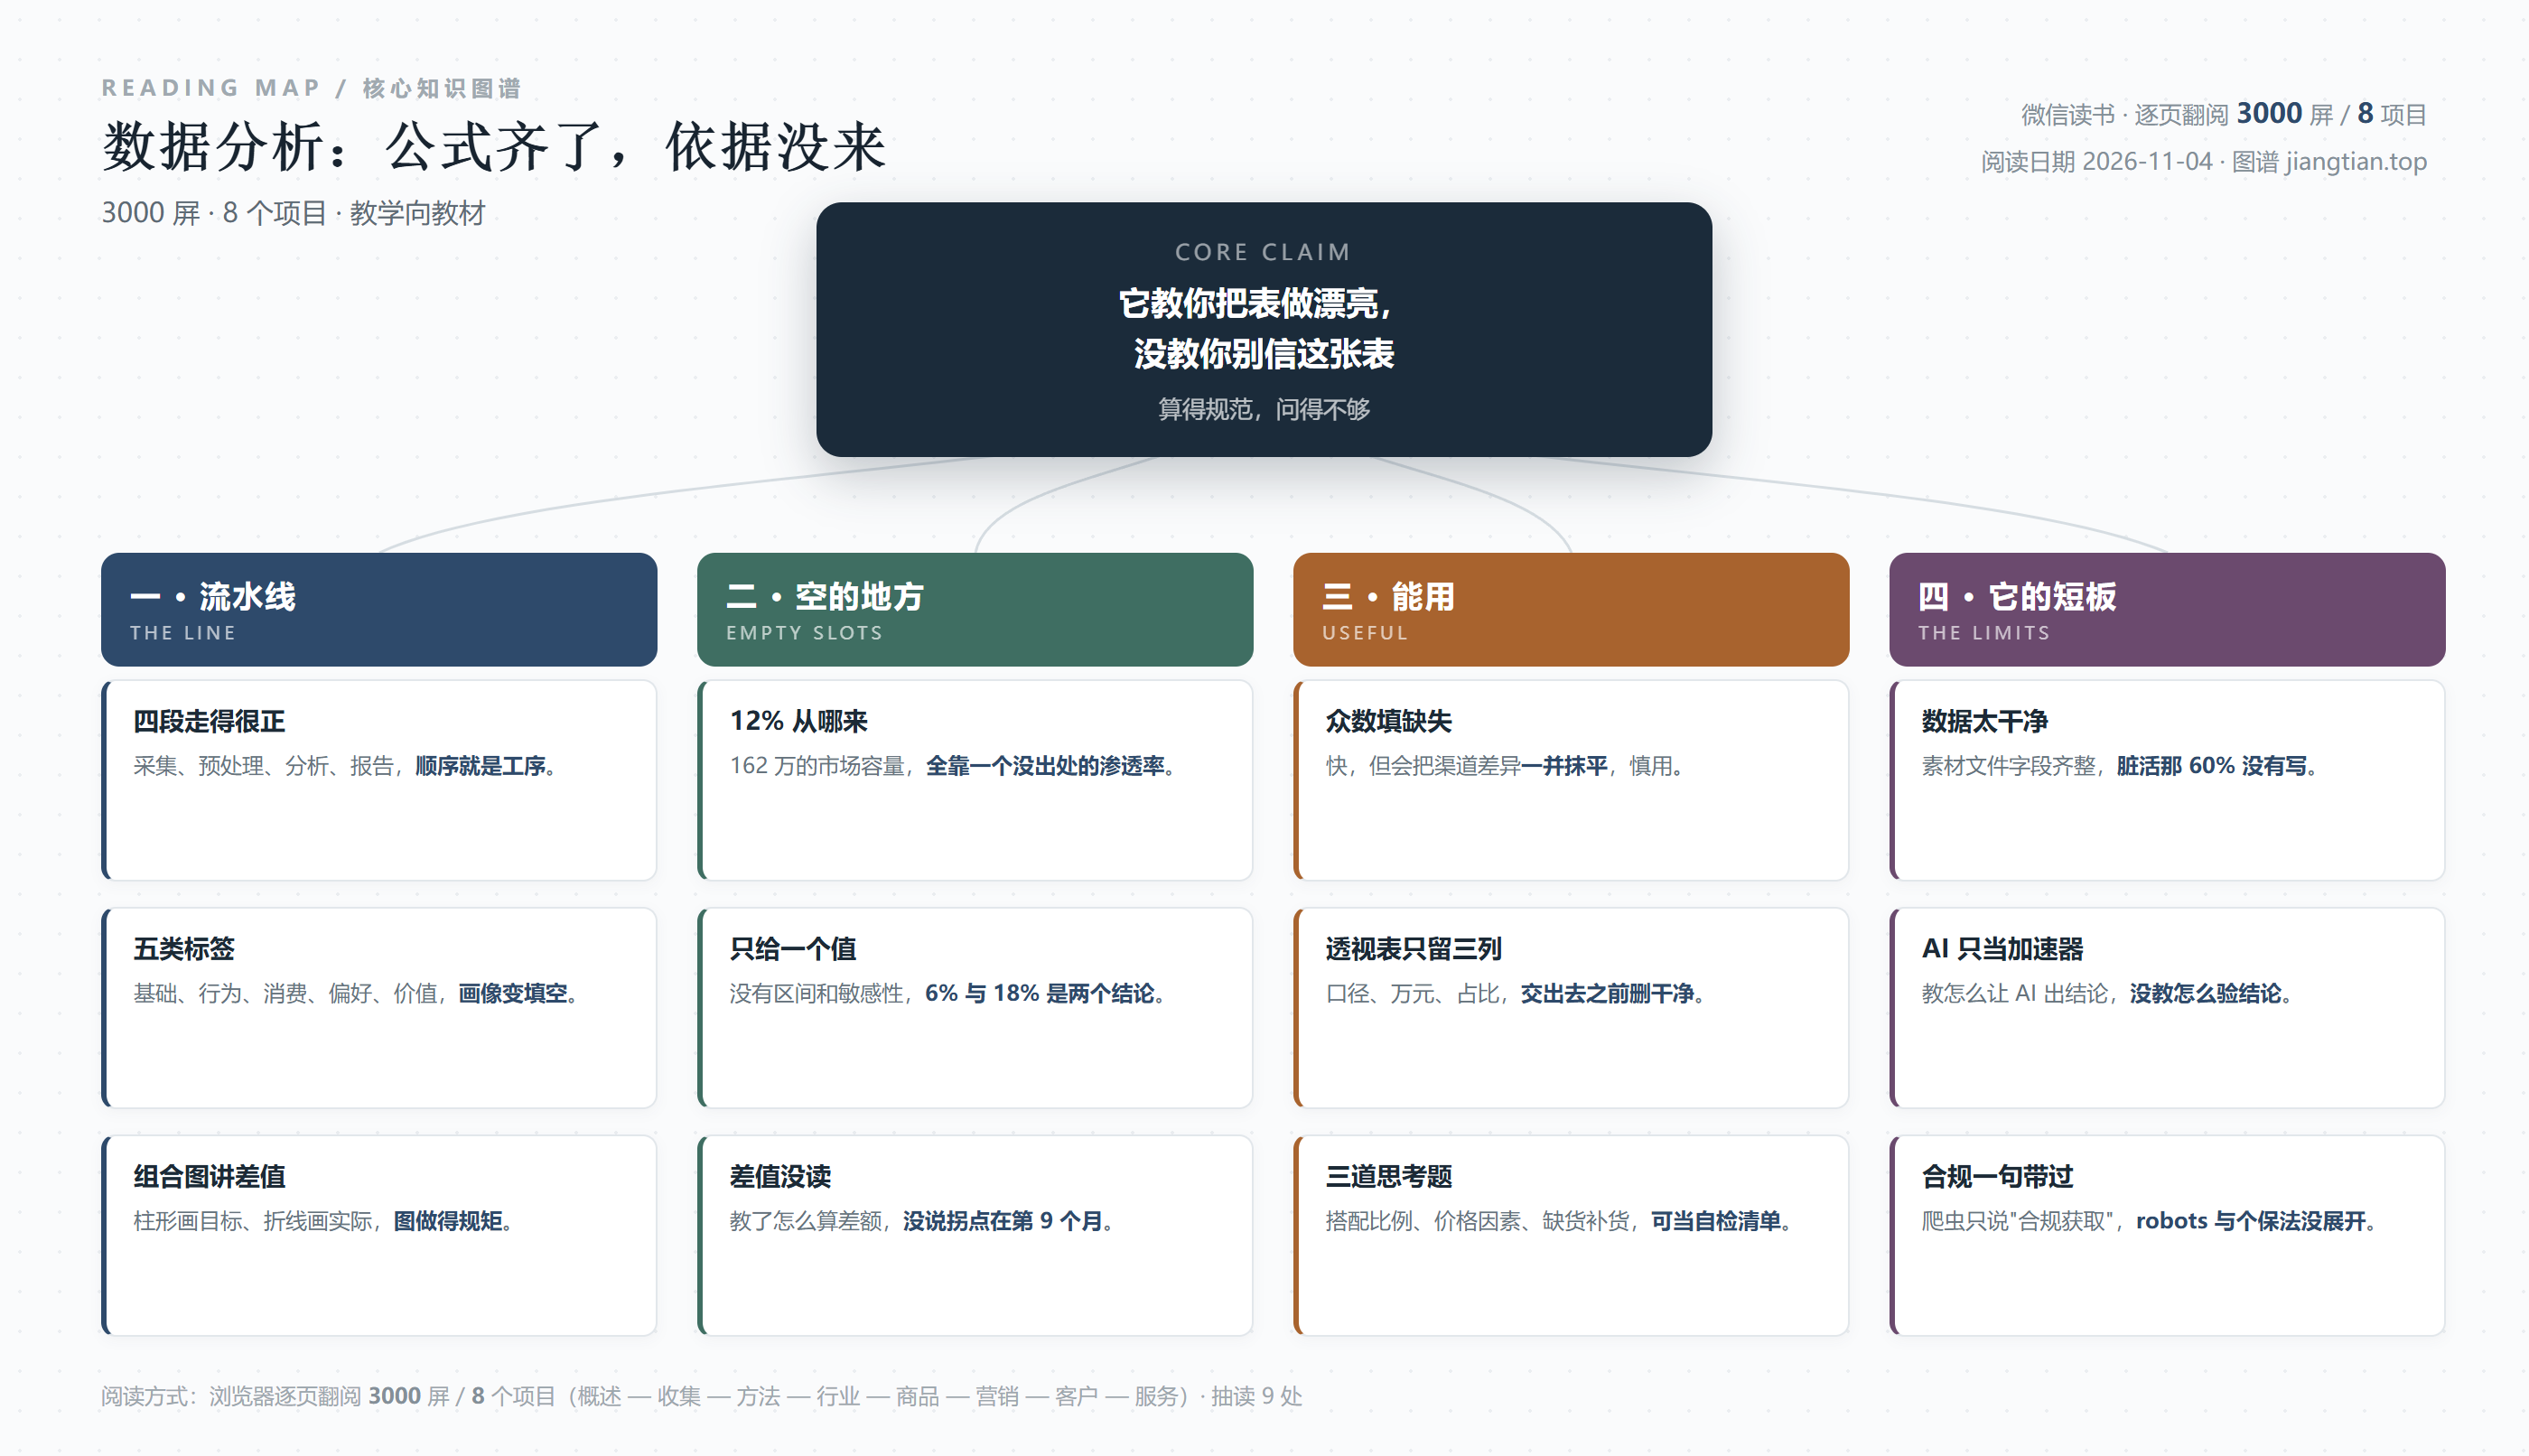
图文对照:这本书的骨架、空档和能抄走的东西
七、它的短板
老实写,五条。
一、数据太干净,脏活那六成没写。每一章都从"打开素材文件\项目X\xxx.xlsx"开始,字段名整齐、没有合并单元格、日期是标准格式、金额是数字。真实后台导出的表,光一列日期就能耗掉半天:2024/1/5、2024.1.5、2024年1月5日、2024-01-05 混着来,还有几个单元格是"1月5日"这种没有年份的。教材教的是分析,跳过的是清洗里最脏、最耗人、也最能看出功底的那六成。学生学完能做对题,第一次接真实数据会懵。
二、没有一处讲"报告错了会怎样"。全书没有讲口径对齐(同一个"销售额",财务按开票算、运营按支付算、商品按出库算,三个数能差 15%),没有讲样本偏差(只统计了有评价的订单),没有讲幸存者偏差(只分析还活着的商品)。这三条是报告被打回的主要原因,也是分析被人质疑时的三个标准攻击点。教材把分析写成了一道有标准答案的题,而真实世界里,一半的争论发生在"你这个数是怎么算的"上,不在"你算得对不对"上。
三、结构模板化得厉害。八个项目,每个都是"任务二到三个 + 综合实训 + 思考题"。翻到第三个项目,你就能预测第八个项目的排版长什么样。模板化的好处是可教、可考、可配课件;坏处是学生学不到"这一行真正的分歧在哪"。比如商品结构分析里,到底是按 GMV 排还是按毛利排,行内一直没有共识,因为两个排法选出的是两批商品——这种真分歧,教材一个字没提。
四、思考题没有判据。项目五的思考题我抄三道:一、在商品结构分析中,如何确定核心商品与辅助商品的最佳搭配比例,以实现销售最大化?二、除了成本、市场需求和竞争状况外,还有哪些因素可能影响商品价格?三、若发现某一细分品类的销售额占比持续上升,但该品类的供应链采购周期较长,运营者应如何制订补货计划以避免"热销但缺货"?
三道题都问得不错,尤其第三道,是个真问题。但教材既不给参考答案,也不给评分点。开放式问题是好的,没有判据的开放式问题,期末只能考背诵。学生最后记住的是"要考虑成本、需求、竞争",而不是"我该怎么在缺货和压货之间选一个"。
五、合规只有一句话。它讲爬虫采集,讲"精准、合规地获取数据",然后就过去了。没有讲 robots 协议、没有讲个人信息保护的红线(哪些字段属于个人信息、抓了算不算处理)、没有讲平台用户协议里那条"禁止自动化访问"。而做数据的人,第一步就会撞上这个。这不是学术问题,是"干不干得下去"的问题。
也得说它的好话。它的步骤写得真的很细——细到"按 Ctrl+F 打开查找和替换""在 D2 单元格输入 =C2-B2 并按 Enter",细到每一张截图都标了图号(图2-19、图3-5、图5-18、图7-3)。这种细,是教材的美德,也是它不能更深的物理原因:一页纸只能放那么多东西,写清了怎么点,就写不下为什么这么点。
八、一句话
如果只带走一句,带走这个顺序:先问这张表是谁填的、什么时候填的、填的时候想让你看到什么,再问它算得对不对。
这本书能教会你算,而且算得挺规范:公式在哪、按钮在哪、图怎么配、报告分几段,全都有。它是一本合格的入门教材,比那些只讲概念的书实在得多。
但它没有教你怀疑。而数据分析这行,怀疑比算重要——因为算错了会被发现,信错了不会。算错的时候,一对账就露馅;信错的时候,你会拿着一张干净的、格式正确的、图表齐全的表,去说服老板做一个错的决定,而且你说得很有底气。
那 12% 的渗透率、那批被众数填掉的性别、那个 1.96814E+11 的总计,都不是技术问题。它们都是"没人多问一句"的结果。
阅读记录:《AIGC商务数据分析与应用》· 张珺、刘娟 主编 · 微信读书逐页翻阅 3000 屏 · 八项目 · 抽读 9 处逐页核对 · 笔记写于 2026-11-04
发表评论: