
多模态AI Agent开发实践:能跑起来,不等于看得懂
微信读书《多模态AI Agent开发实践》· 周驰岷、邓淇文 等 著
逐页翻阅 195 屏 · 13 章 · 2026-11-03
说明:这是一本"教程书"——按它自己的说法,13 章形成"基础—框架—模型—实战—优化"的递进结构。我读完的结论是:它的概念部分比代码部分值钱,而它的代码部分有一处会直接让你跑不起来。下面讲清楚哪一段值得读、哪一段要绕开。
先说一个判断:这本书最有价值的一页,不是任何一段代码,而是第 1 章里对两个词的区分。
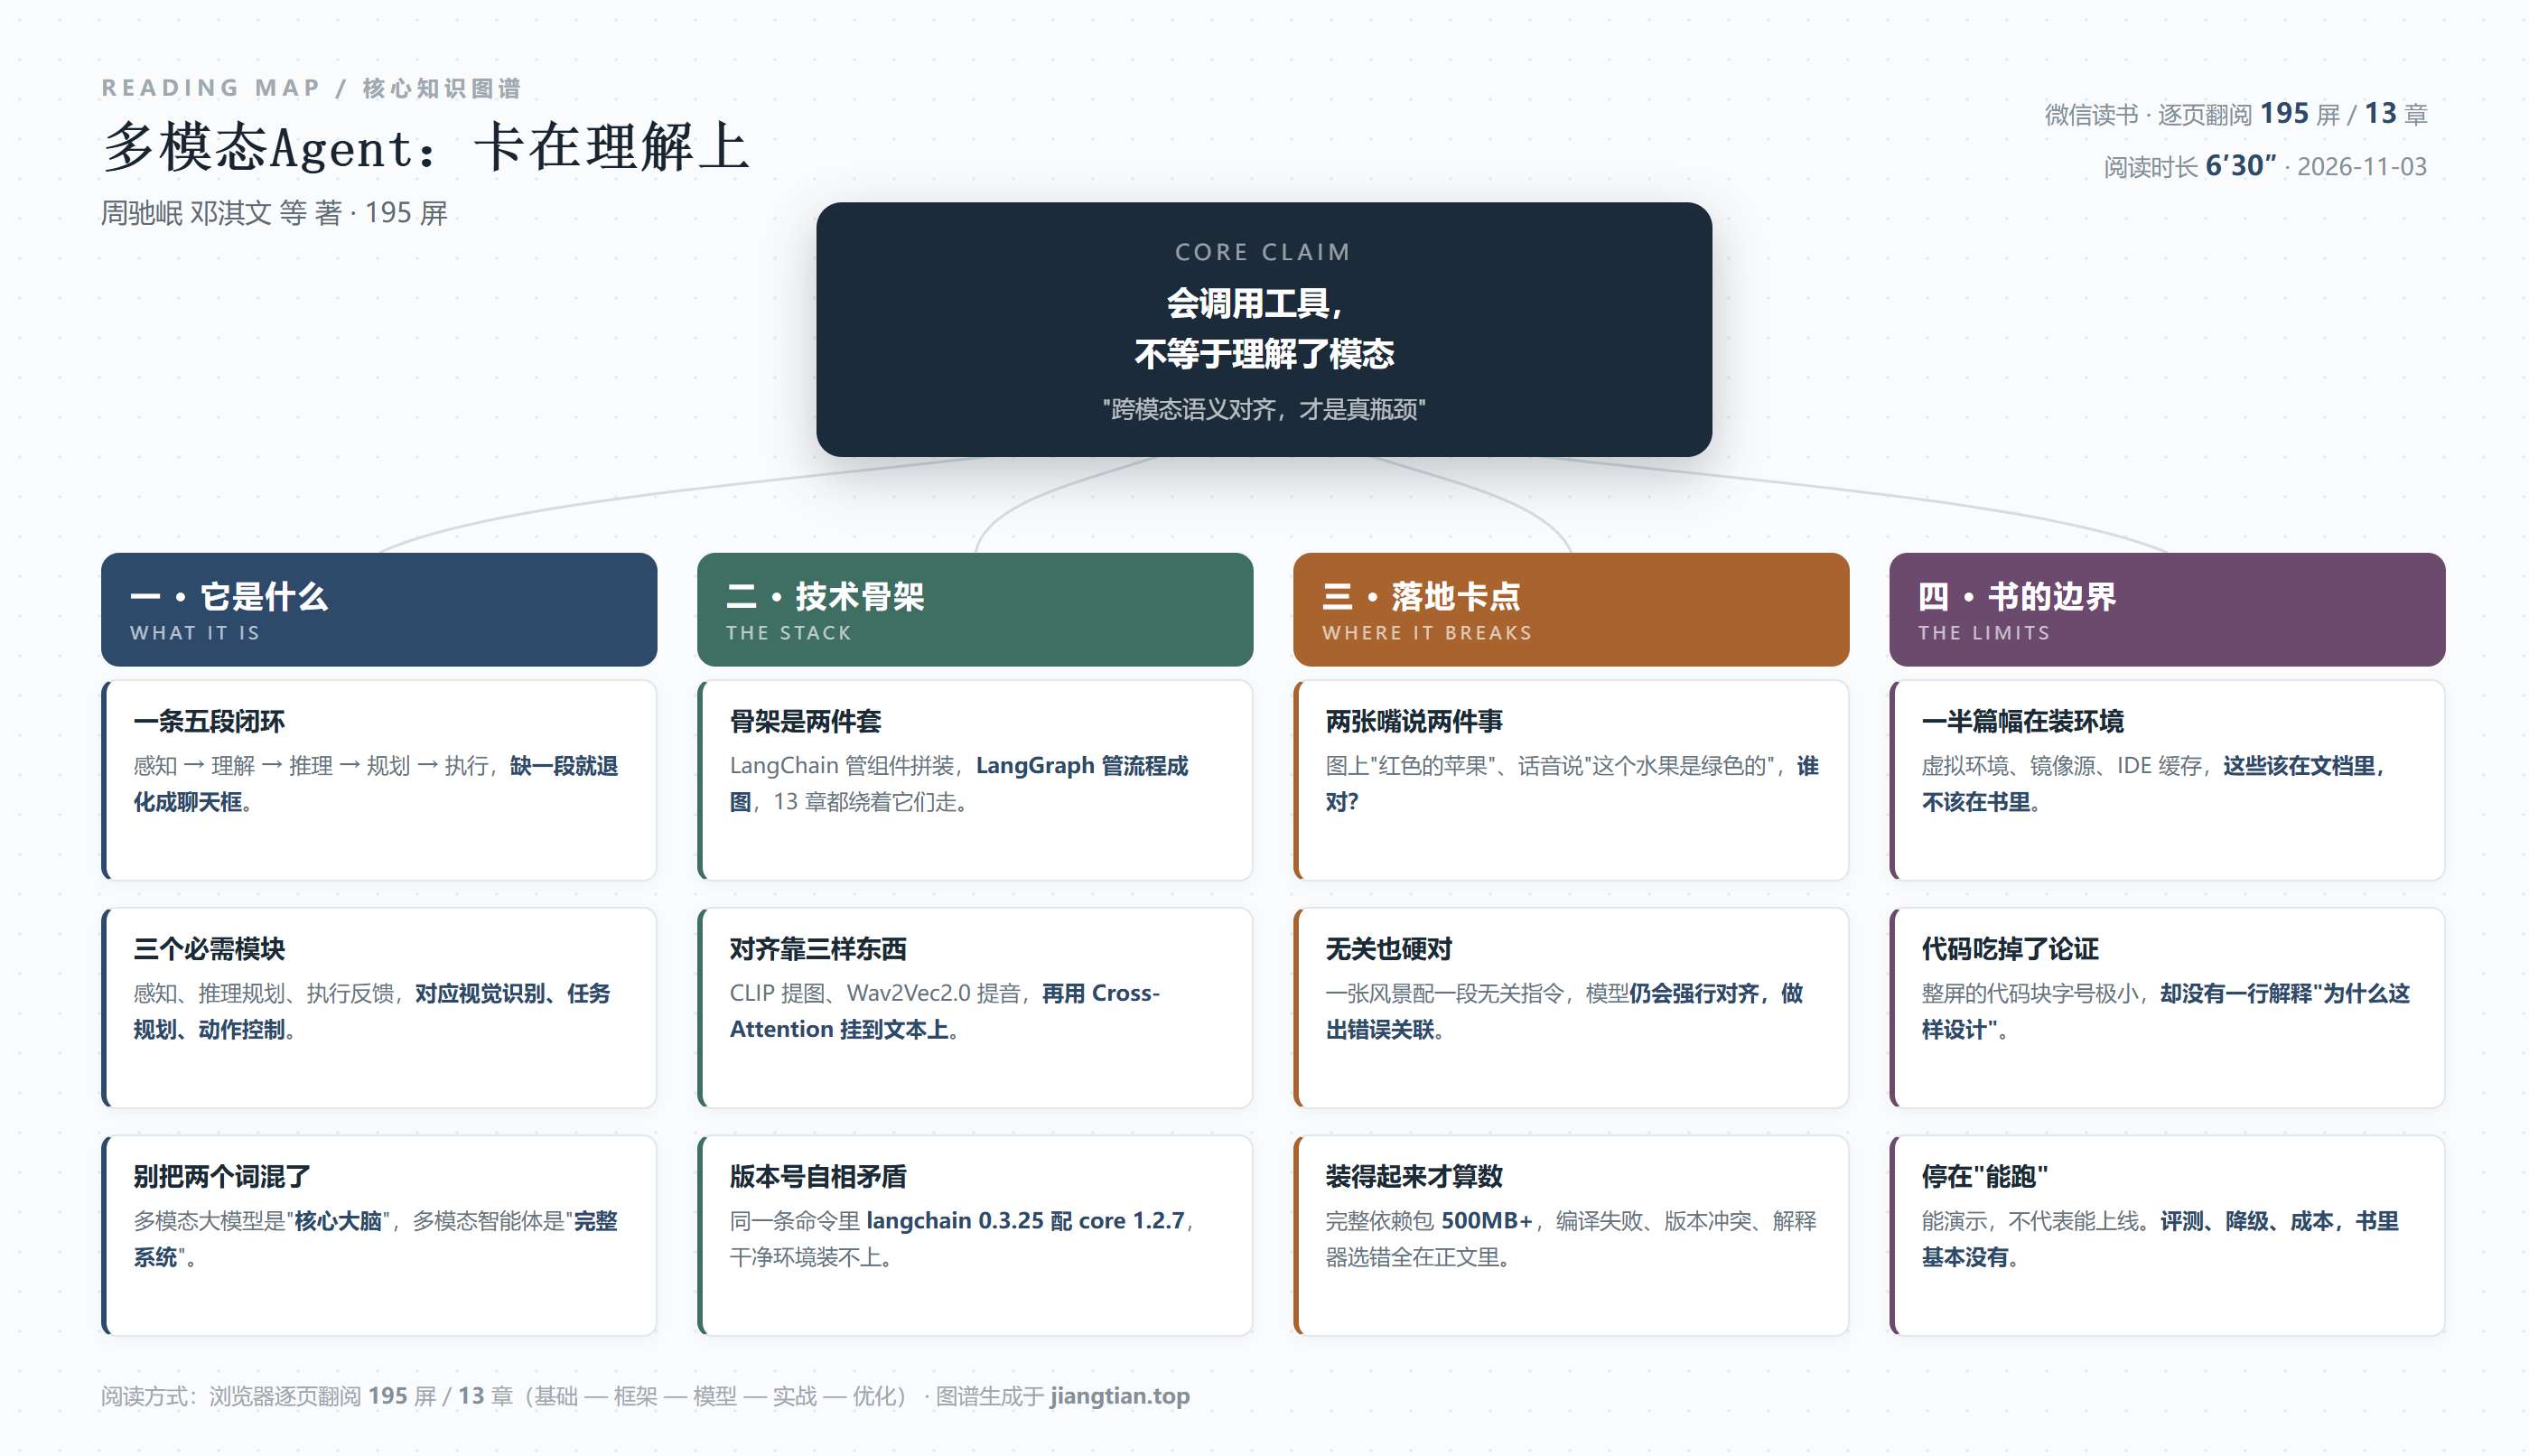
它把"多模态智能体"和"多模态大模型"摆在一起,说得很清楚:多模态大模型是智能体的"核心大脑",提供跨模态理解与生成的基础能力;而多模态智能体是一个"完整系统"。前者是一个模型,后者是模型加上感知、规划、工具、反馈的一整套东西。
这个区分看似只是术语洁癖,其实决定了很多项目的死法。大量"AI 项目"死掉,不是因为模型不够强,是因为团队把模型当成了系统——以为接上一个多模态 API 就有了智能体,结果发现它不会调工具、不会记住上一轮、不会在失败后换一条路。这些都不在模型里,在模型外面。
所以这本书的骨架是立得住的。问题出在它填进骨架的东西。
一、它给的定义,比大多数同题书干净
书里对多模态智能体(MMA)的定义是这样写的:以多模态大模型(MLLM)为核心基座,集成视觉、语音、文本、图像、视频、传感器数据等多种模态信息,具备"感知—理解—推理—规划—执行"闭环能力,能够自主适配复杂场景、响应用户多模态指令,并实现跨模态任务自主完成的智能系统。
然后它专门强调了一句核心区别:与传统单模态智能体、简单多模态拼接系统相比,区别在于"深度模态融合"与"自主智能决策"——并非多种模态的简单叠加,而是通过模态对齐、跨模态推理,实现不同模态信息的互补与协同。
我要为这句话点个赞。"并非简单叠加"这五个字,是这条路线上唯一重要的分界线。把图片转成文字描述喂给文本模型,那是拼接,不是融合。拼接能做出 demo,做不出产品——因为你把图像里所有"没被描述出来"的信息都扔了,而那些信息往往正是关键。
接着它把系统拆成三大模块,这个拆法我认为是对的:
多模态感知模块(负责接收并解析不同模态输入,如视觉识别、语音转写、文本解析、视频帧提取等)、跨模态推理与规划模块(核心,基于多模态大模型实现模态间的语义对齐、逻辑推理与任务规划)、多模态执行与反馈模块(负责输出多模态结果,如文本回复、语音合成、图像生成、动作控制等,并接收环境或用户的反馈进行动态调整)。
注意最后一个模块的措辞——"并接收环境或用户的反馈进行动态调整"。这一句把"智能体"和"工作流"分开了。工作流是单向的,跑完就完;智能体要能回头改主意。很多号称 Agent 的系统,其实只是带了个 if-else 的 pipeline,因为它的"执行"没有回接到"规划"。
所以第 1 章我是认真读完的。它没有堆概念,它把边界划出来了——包括我下面要说的、它自己也没能跨过去的那条边界。
二、它列了四个卡点,第一个才是真的卡
第 1 章的 1.3 节列了"多模态智能体开发的核心挑战",四条:跨模态语义对齐精度不足、多模态工具协同复杂且任务规划能力薄弱、多模态数据处理效率低且质量难保障、工程化部署困难。
这四条里,只有第一条是不可绕过的那种困难,其余三条是工程问题——能靠时间和钱解决。作者大概也知道,所以把第一条单独展开,写得很具体。
它举的第一个例子,我读完就记住了:
当不同模态的信息存在歧义时,智能体无法准确判断核心语义,例如,用户上传一幅"红色的苹果"图像,同时发送语音指令"这个水果是绿色的",智能体无法准确判断哪种模态的信息是正确的,导致推理错误。
这个例子好,好在它很日常。这不是什么高深的对抗样本,就是一个人说错话,或者开个玩笑,或者故意刁难。而系统在这里的"无法判断",本质上是它不知道"该信谁"。
人类处理这种冲突几乎不费力:我会默认图像是客观记录、语音是主观陈述,然后问一句"你是说想把它 P 成绿色?"。这个处理里有三个东西:模态的可信度先验、意图推断、澄清动作。而这三样,书里一样都没给解法。
第二个例子更微妙,也更接近真实系统的病灶:
对于语义关联较弱的多模态信息(如一幅风景图像与一段无关的文本指令),智能体无法准确判断模态间的无关联关系,仍会强行进行对齐,导致任务执行偏差。
"仍会强行进行对齐"——这五个字是全书最锋利的一句,虽然作者可能没意识到它有多锋利。
因为它指出的是一个结构性缺陷:对齐模块的设计目标是"找到对应关系",而不是"判断有没有对应关系"。只要你给它两样东西,它就会想方设法把它们连起来。这在多模态里是普遍现象——你问一个视觉语言模型"图里那个红色的东西是什么",即使图里根本没有红色的东西,它也倾向于给你一个答案,而不是说"没有"。
我在实际用这类系统时踩过很多次这个坑:给它一张表格截图加一段不相干的说明,它会煞有介事地"综合分析",把两件无关的事编成一条因果链。这不是幻觉(hallucination)那么简单,这是"必须对齐"这个机制本身的副作用。而一个能说"这两件事没有关系"的系统,比一个总能给出答案的系统难做得多,也有用得多。
书里给的解法是技术性的:用细粒度模态特征提取(CLIP 提图像、Wav2Vec2.0 提语音)加跨模态注意力(Cross-Attention),把像素级、音素级的特征与文本语义挂起来。
这个方向没错,但它只解决了"对齐得更细",没解决"该不该对齐"。细粒度对齐会让错误的关联变得更精致。这是我读这一节时最大的不满足:它把一个判定问题,当成了一个精度问题。
三、骨架选了 LangChain + LangGraph,稳,但脆
从第 2 章开始,书进入了实操。技术选型是清楚的:LangChain 做组件层(模型、提示、工具、记忆、检索),LangGraph 做流程层(把 Agent 的执行过程画成状态图)。书里有一句话概括得很准:
Agent 是 LangChain 多模态智能体的"大脑",核心价值在于"自主决策、动态调度、灵活适配",区别于 Chain 的固定流程执行,Agent 能够根据多模态输入(图像、音频、文本)自主判断任务需求、选择工具、规划执行步骤。
"区别于 Chain 的固定流程执行"——这个对比很重要。Chain 是你写死的流水线,Agent 是运行时才决定的路径。而这个"运行时决定",正是所有麻烦的来源:路径不定,测试就难写;测试难写,可靠性就没法量化;可靠性没法量化,就没法上线。
书里给了一个我认为写得不错的具体案例:主从协作模式。主 Agent 调度三个从 Agent,分别做图像检测、文件写入、语音生成,三个从 Agent 通过共享 Memory 同步信息,最后由主 Agent 汇总结果。案例的任务是工业巡检——分析 industrial_test.jpg,检测泄漏故障,写入文本文件,再生成语音报告。
这个案例的价值在于它是"多模态"的,而且是"多动作"的:看、写、说,三种输出模态。比那些"上传图片问一句话"的 demo 完整得多。
但它也暴露了一个书里没讨论的问题:三个从 Agent 共享 Memory,冲突了怎么办?图像检测说"有泄漏",语音生成环节要念出结论,如果这中间文件写入失败了,语音还要不要念?主 Agent 汇总时以谁为准?书里只写了"通过共享 Memory 实现信息同步",没写同步失败的路径。
这是教程书的通病:happy path 写得很细,异常路径一句不提。而工程上 80% 的时间花在异常路径上。
四、一条照着抄会失败的安装命令
这是我要重点说的一处硬伤,因为它会直接卡住读者。
第 4 章开头,讲 Agent 依赖配置,给了一条命令(书里写着"本章统一使用,后续案例不再重复"):
pip install langchain==0.3.25 langgraph==1.0.5 langchain-core==1.2.7 langchain-community==0.4.1 python-dotenv
问题出在前三个包的版本组合上。LangChain 0.3.x 主包对 langchain-core 的依赖声明是 0.3 系列(<1.0),而这条命令钉死了 langchain-core==1.2.7。在干净环境里,pip 会在解析依赖时报冲突;就算用 --no-deps 硬装,运行时也会因为接口不匹配而炸。
我不是在挑刺,我是在说一个真实的使用场景:一个读者拿着这本书,照着这条命令敲下去,第一屏就是红色报错。而他没有任何线索知道是版本问题——因为书里前后都写着"langchain 0.3.x",看起来是一致的。
更麻烦的是第 2 章还有另一条命令:
pip install langchain[all]==0.3.25
书里说这条会"自动安装 LangChain 核心依赖包 + 多模态工具(如 OpenCV、Whisper)、大模型 API 客户端(如 openai、baidu-aip)、文档处理工具(如 unstructured)等所有依赖",并提醒"完整版依赖体积较大(约 500MB+)"。
这个提醒很实在。但它没提醒的是:[all] 这种装法会把一堆互相冲突的 extras 一起拉进来,失败率高得惊人。书里确实写了"若出现版本冲突,可执行 pip install --upgrade 冲突依赖包名称,或使用 --force-reinstall 强制重新安装"——这等于告诉读者"撞上了就硬来",而硬来的结果通常是一个更难排查的环境。
我的经验是:教程书里的安装命令,应该给一个 requirements.txt 加一句"已验证于某年某月",而不是给一条 pip 命令加一句"如果报错就重装"。因为前者可复现,后者不可复现。而这本书的定位明明是"实践"。
五、有半本书在教你怎么装环境
第 2 章整章讲环境:Python 版本、conda 与 venv、依赖版本管理、图像/音频/模型调用依赖、API 密钥配置、环境验证。书里自己说这一章的目标是"标准化搭建、多模态适配、高效调试"。
这一章里我读到的最典型的一段,是 IDE 排错:
在 PyCharm 中,通过"File→Settings→Project:xxx→Python Interpreter",选择多模态开发环境;在 VS Code 中,按 Ctrl+Shift+P 组合键,输入"Python: Select Interpreter",切换至对应环境。……在 PyCharm 中执行"File→Invalidate Caches...→Invalidate and Restart",在 VS Code 中按 Ctrl+Shift+P 组合键,输入"Python: Clear Workspace Cache",清除缓存后重启 IDE。
这段写得很清楚,照着做能把问题解决。但它不该出现在一本 2026 年出版的书里。
理由很简单:这类内容的保质期是半年。菜单项会改名,快捷键会变,缓存机制会重写。书一旦印出来就固化了,而 IDE 一直在动。把它写进书里,等于主动给书装上了一个到期日。
我不是说这些知识没用——它对当下的读者非常有用。我是说它放错了地方:它该是一篇可以持续更新的文档、一个 FAQ、一个 issue 模板,而不是占掉一本书的六分之一。
同样的问题也出现在 2.4.3 节"API 密钥安全管理规范":禁止硬编码、最小权限、定期更换(建议每 3–6 个月)、避免公开传播、config.py 加进 .gitignore。
这四条完全正确,而且我很高兴有人写。但它是"工程卫生",不是"多模态"。任何一本书都可以抄这四条,它和本书的主题没有关系。当一本讲多模态智能体的书,用六分之一的篇幅讲虚拟环境、六分之一的篇幅贴代码,真正留给"多模态"的篇幅就只剩三分之一了。
六、代码占了很大篇幅,但"为什么"几乎不在
这本书的代码量很大。我逐页翻过去,印象最深的是第 4 章那段 LangGraph 的实现:定义 StateGraph、写 reason 节点和 act 节点、加边、加条件边(任务完成就 END,否则回到 reason 循环)、编译、运行。
这段代码本身是对的,思路也清楚:思考→行动→观察,观察完再思考,直到任务完成。这是 ReAct 的标准形状。
问题是——书里把这段代码贴出来了,却没有一句话解释"为什么这里要用图,而不是 while 循环"。
而这个问题恰恰是关键。用 while 循环写 ReAct,五行就能写完,为什么还要引入一个 StateGraph?我的理解是三个原因:一是可观测(每一步状态都能被记录和回放,出问题能定位到哪个节点);二是可中断(可以在某个节点插入人工确认,这在企业场景里是刚需);三是可组合(多个子图可以拼成一个大图,主从协作才落得下去)。
这三条才是"为什么要用 LangGraph"的答案,而书里一句都没说。它只是把 API 用给你看。
这也是我对这类"实战书"最普遍的不满:它们把"怎么写"写到了极致,把"为什么这么写"压缩到零。读者抄完之后能跑起来,但一旦要改需求——比如把串行改成并行、把固定路由改成动态路由——就完全不知道该动哪里,因为他只知道形状,不知道形状背后的约束。
顺带说一句版式:书里的代码块是整屏贴的,字号被压得很小,在微信读书里几乎要放大才能看清。这不是内容问题,但它实实在在地降低了可读性——一本要边看边敲的书,代码看不清等于废掉一半。
七、它的短板
下面这几条,是我认为买这本书的人必须提前知道的。
第一,那条安装命令是真的会失败。前面已经说了,langchain 0.3.25 配 langchain-core 1.2.7 是自相矛盾的组合。这不是"版本可能有点旧",是"照抄必然报错"。一本实践书的开篇命令跑不通,读者对后面所有内容的信任都会打折。如果只能改一处,就改这一处:给一份锁定版本的 requirements.txt,并注明验证日期。
第二,章节编号是断的,说明成书很赶。看目录就知道:第 1 章里有 1.6,然后直接跳到 2.1;第 3 章之后直接出现 4.3;有的章有小结、有的没有;前言里说"共 13 章",目录里能对上的编号却跳来跳去。这是典型的"多人分头写、事后拼装"的痕迹。它不影响你读某一节,但影响你把它当体系来学——因为你不知道哪一节是主干、哪一节是补丁。
第三,"多模态"实际上偏"图 + 文"。书名叫多模态,但真正的多模态内容(音频、视频、传感器)占比不高。语音部分主要集中在"用 Wav2Vec2.0 提特征"和"调用 TTS 生成语音",视频基本停在"抽帧"这一步。真正难的部分——时序对齐(声音和画面对不上)、多流融合(三路信号同时进来)、跨模态检索(用文字搜视频片段)——基本没有展开。如果冲着"多模态"三个字来的读者,会觉得单薄。
第四,只到"能跑",没到"能上线"。全书没有一个章节讲评测。多模态系统的评测是最难的:你怎么衡量"这个描述准不准"?用什么指标?人工评还是模型评?样本怎么造?还有成本(一次多模态调用的 token 消耗是纯文本的几倍到几十倍)、延迟(图像编码比文本慢一个量级)、降级(模型超时了退回什么)。这些是决定一个系统能不能上生产的东西,书里一条都没有。它停在"案例执行成功,输出文件已生成"。
第五,关键概念给了术语,没给判据。"语义对齐"这个词在书里出现了几十次,但读者读完仍然不知道:对齐到什么程度算好?有没有一个可以量的指标?书里说"提升细粒度对齐精度",可精度怎么算?是检索召回率,还是人工打分?没有答案。一个不能被测量的概念,在工程上等于不存在。这是我认为这本书最需要补的一章,也是它最难补的一章。
说完这些,我的结论其实不复杂:把它当前两章读,值;把它当工程手册用,会踩坑。
第 1 章那套"感知—理解—推理—规划—执行"的拆解,加上"智能体是系统、模型是大脑"的区分,是我见过的同题书里讲得最干净的。它帮你建立的是一个判断框架:当你看到某个"AI 产品"时,你能一眼看出它缺的是哪一段。这个能力比会写 StateGraph 值钱得多。
而第 2 章之后,它的价值更像"一个跑通过的样例",而不是"一套可复用的方法"。样例的价值在于给你一个起点,让你不用从零搭环境;但它的保质期短,而且已经被那条版本命令打了个折。
一句话总结:这本书把"多模态智能体是一个系统而不是一个模型"讲明白了,却没有回答系统最难的那一问——它凭什么知道自己看对了?
阅读记录:《多模态AI Agent开发实践》,周驰岷、邓淇文 等 著,微信读书逐页翻阅 195 屏,十三章按"基础—框架—模型—实战—优化"通读,从多模态智能体的定义、LangChain 与 LangGraph 的技术栈,读到多模态数据处理、ReAct Agent、自定义 Tool 与主从协作案例。2026-11-03。
发表评论: