
AI 项目实录:项目上线那天不是终点,是第一次被真实世界打分的开始
微信读书《AI 项目实录:大模型时代的职场生存局》· 若思
逐页翻阅 259 屏 · 26 章 · 2026-11-03
说明:这是小说,不是技术书。但它是我读过的、把"AI 项目在真实公司里怎么死怎么活"写得最不粉饰的一本。技术细节只出现在第七章和第四部分,其余全是人。
必须先说清楚这本书的体裁:它是一部职场小说。主人公李可,一家叫蓝煌的钢铁企业的数据工程师,被半推半就推上了"做大模型"这个任务。
所以它没有"十大技巧""五大框架"。它有的是:立项会上的推诿、评审会上的质疑、 Deployment 那天的干等、上线三周后没人用的沉默。
我把它读完,最大的感受是——市面上缺的从来不是"怎么做 RAG"的书,缺的是"做 RAG 会遇到什么"的书。这本书补的正是后者。
一、新人问的那个问题,是全书最好的开场
第七章,李可终于有了第一个团队成员——名校毕业的薇薇安。她坐在小圆桌前,看李可在白板上画 RAG 流程图,看了好一会儿,忍不住问:
"现在大模型这么强,为什么我们不能直接用大模型,而一定要做 RAG?"
这个问题问得太好了,好到我觉得它应该印在封面上。
因为它是所有 AI 项目的第一个分水岭:如果你答不出"为什么不能直接用",你的项目从一开始就没有必要存在。
书里给出的答案不是抽象的。它落在具体的人身上:维修部的老师傅。
系统给出答案,他会问"这个结论哪来的"。你告诉他还原自某份分析报告,他说不对,维修现场我们更愿意看维修手册。你翻给他看,他说手册上其实没有直接回答,得靠经验推。
这些对话在书里出现了好几段,读起来琐碎,但每一段都在讲同一件事:真实工作里,"答案"和"可核对的答案"是两回事。而大模型天生只擅长前者。
二、知识库的第一天:先定义"什么不算"
第四部分讲 RAG 项目的完整流程,第一步是"收集与选材",书里叫 Corpus 定义。
它做的第一件事不是收,是划界:先决定"哪些资料算知识库的一部分",同时也要决定"哪些不纳入"——比如高度敏感、未经审核、不相关的内容;或者只纳入摘要、脱敏版本。
这个顺序很反直觉。多数人做知识库是"能捞的都捞进来,反正向量库大"。但书里这个做法才是对的:知识库的边界不是容量问题,是责任问题。一份未经审核的内部文档进了库,它被检索出来当依据,出事算谁的?
第二步是数据处理,书里列得极其实在:
去重/版本粗筛(同名多份、明显重复文件);统一文件编码、修复损坏文件;格式转换。
同时为数据添加标签/元数据,让后续检索可过滤、权限可控制。常见标签包括:来源系统与路径(SharePoint/FTP/邮件附件等)、文件名;创建/修改时间、作者、所属部门/团队;文档类型(分析报告/模板/模型说明等)。
看到这段的时候我笑了一下——这就是真实项目的工期所在。没有一行是"AI",全是脏活。但恰恰是这些元数据,决定了这个系统能不能按部门隔离权限、能不能按时间过滤过期版本、能不能在回答里标出处。
书里没明说,但意思很清楚:RAG 的效果上限,在数据准备这一步就基本定死了。后面调模型、调提示词,都是在这个上限下面腾挪。
三、那个 0.4 分的第一名
全书我最喜欢的一段,是评估阶段的一场对话。
老师傅一哥试用系统,指着一条结果问:这几个文档回答的内容一样,为什么维修手册排在后面?李可解释是按相关性排序的。
一哥听完,接着问了第二个问题,这个问题直接把系统的问题掀开了:
"这个问题比较复杂,维修手册上其实没有直接回答,需要维修人员根据很多信息自己来推测,所以这里列出的答案其实都是不准确的。"顿了顿,他问道:"这个文档并不相关,为什么会排在第一?"
工程师去后台查了,回答得很诚实:这次检索到的所有文档相关性都不高,最高的只有 0.4,就是排第一的那个。
一哥皱眉:"也就是说,如果所有答案其实都不太相关,系统也不会告诉我们'找不到答案',而是一定会给一个排第一的结果?"
答案是:只有当相关系数小于 0.3 才会不予显示。
这段对话值得所有做 RAG 的人读三遍。它揭示的是一个产品层面的结构性问题:排序系统永远会给你一个第一名,而用户会默认第一名就是答案。
模型的"不知道"在向量检索里没有对应物。它不会说"这题我不会",它只会把最不烂的那个端上来。而 0.4 分和 0.9 分在界面上长得一模一样。
后面一哥提的要求特别朴素:能不能把相关性分数直接显示出来。
我看到这里停了一下。这个要求不高明,甚至有点土。但它是用户自己找到的信任机制——你不给我确定性,至少给我一个数,让我自己判断。
很多 AI 产品就死在这一步:不是答错,是不肯暴露自己有多不确定。
四、上线那天:技术活干完了,剩下全是等别人
第二十二章"上线时刻",写得非常真实。
没有倒计时,没有掌声。只有:凯琳在跟进。十点半。十一点。终于等来更新——他们马上开始部署,应该在一点以前完成。
中午,团队一起去楼下咖啡厅,话题自然滑向维修智助。有人忍不住问:"大概什么时候上线啊?"
然后是一句让人心里一紧的话:团队充满希望:"希望下午可以直接看到用户涌进来。"
读到这句我就知道后面要坏事了。因为真实的系统上线,从来没有"用户涌进来"这回事。真实的版本是:上线第一周,日活个位数;第二周,有人试了一次,说"还不如我自己翻手册快"。
这本书诚实的地方就在于,它写了这个。
五、"胜利的褪色"与尾声那句话
第二十三章的标题叫"胜利的褪色"。这个标题本身就把话说完了。
技术上线只是把一个东西放到那里。它有没有被用、用得对不对、有没有改变任何人的工作方式——这些都不在发布清单上。
而全书最后,作者把镜头拉到更远的地方。尾声里有一段,我认为是这本书真正的核心:
在叙事的一端,它是效率工具,是知识助手,是降低成本的技术跃迁。但在另一端,它也开始被用作一种更现实的东西——裁撤与重组的依据。同一套系统,既在提升生产力,也在改变"谁需要留在系统里"。
这段话说得克制,但很重。它没有喊"AI 要取代人",也没有说"AI 只是工具"。它指出了一个更难受的事实:同一件东西可以同时是好用的帮手和裁人的理由,而且这两件事并不矛盾。
接下来那句更狠:
她无法确定组织是否真的会改变,也无法确认自己是否站在正确的位置上。但她至少已经看清了一件事:技术的路该怎么走不好说,而组织的路,从来不取决于她。
这句话是整本书的落点,也是它区别于所有"AI 技术书"的地方。技术书教你优化系统,这本书让你看清你在系统里的位置。
六、它的短板
技术细节偏浅且集中。全书的技术内容基本挤在第七章和第四部分,且多是流程和概念层面的描述,没有可复用的代码。想学实现的人会觉得不够。
人物线有些理想化。李可遇到的阻力——上级的怀疑、跨部门的推诿、用户的挑剔——写得很真,但她本人的应对几乎每一次都恰到好处。真实的项目经理,多半会在某个环节崩一次。
它把结局留白了。系统到底活下来没有,组织到底变了没有,书里没有给答案。这在文学上是克制,在实用上是遗憾——读者最想知道的恰恰是"后来呢"。
但它做成了一件很难的事:它把 AI 项目写成了一个有人、有政治、有疲惫的过程,而不是一条从需求到上线的直线。
如果你正在公司里推一个 AI 项目,这本书比十本技术手册有用。因为它提前告诉你,你会在哪个环节被卡住,以及卡住你的通常不是模型。
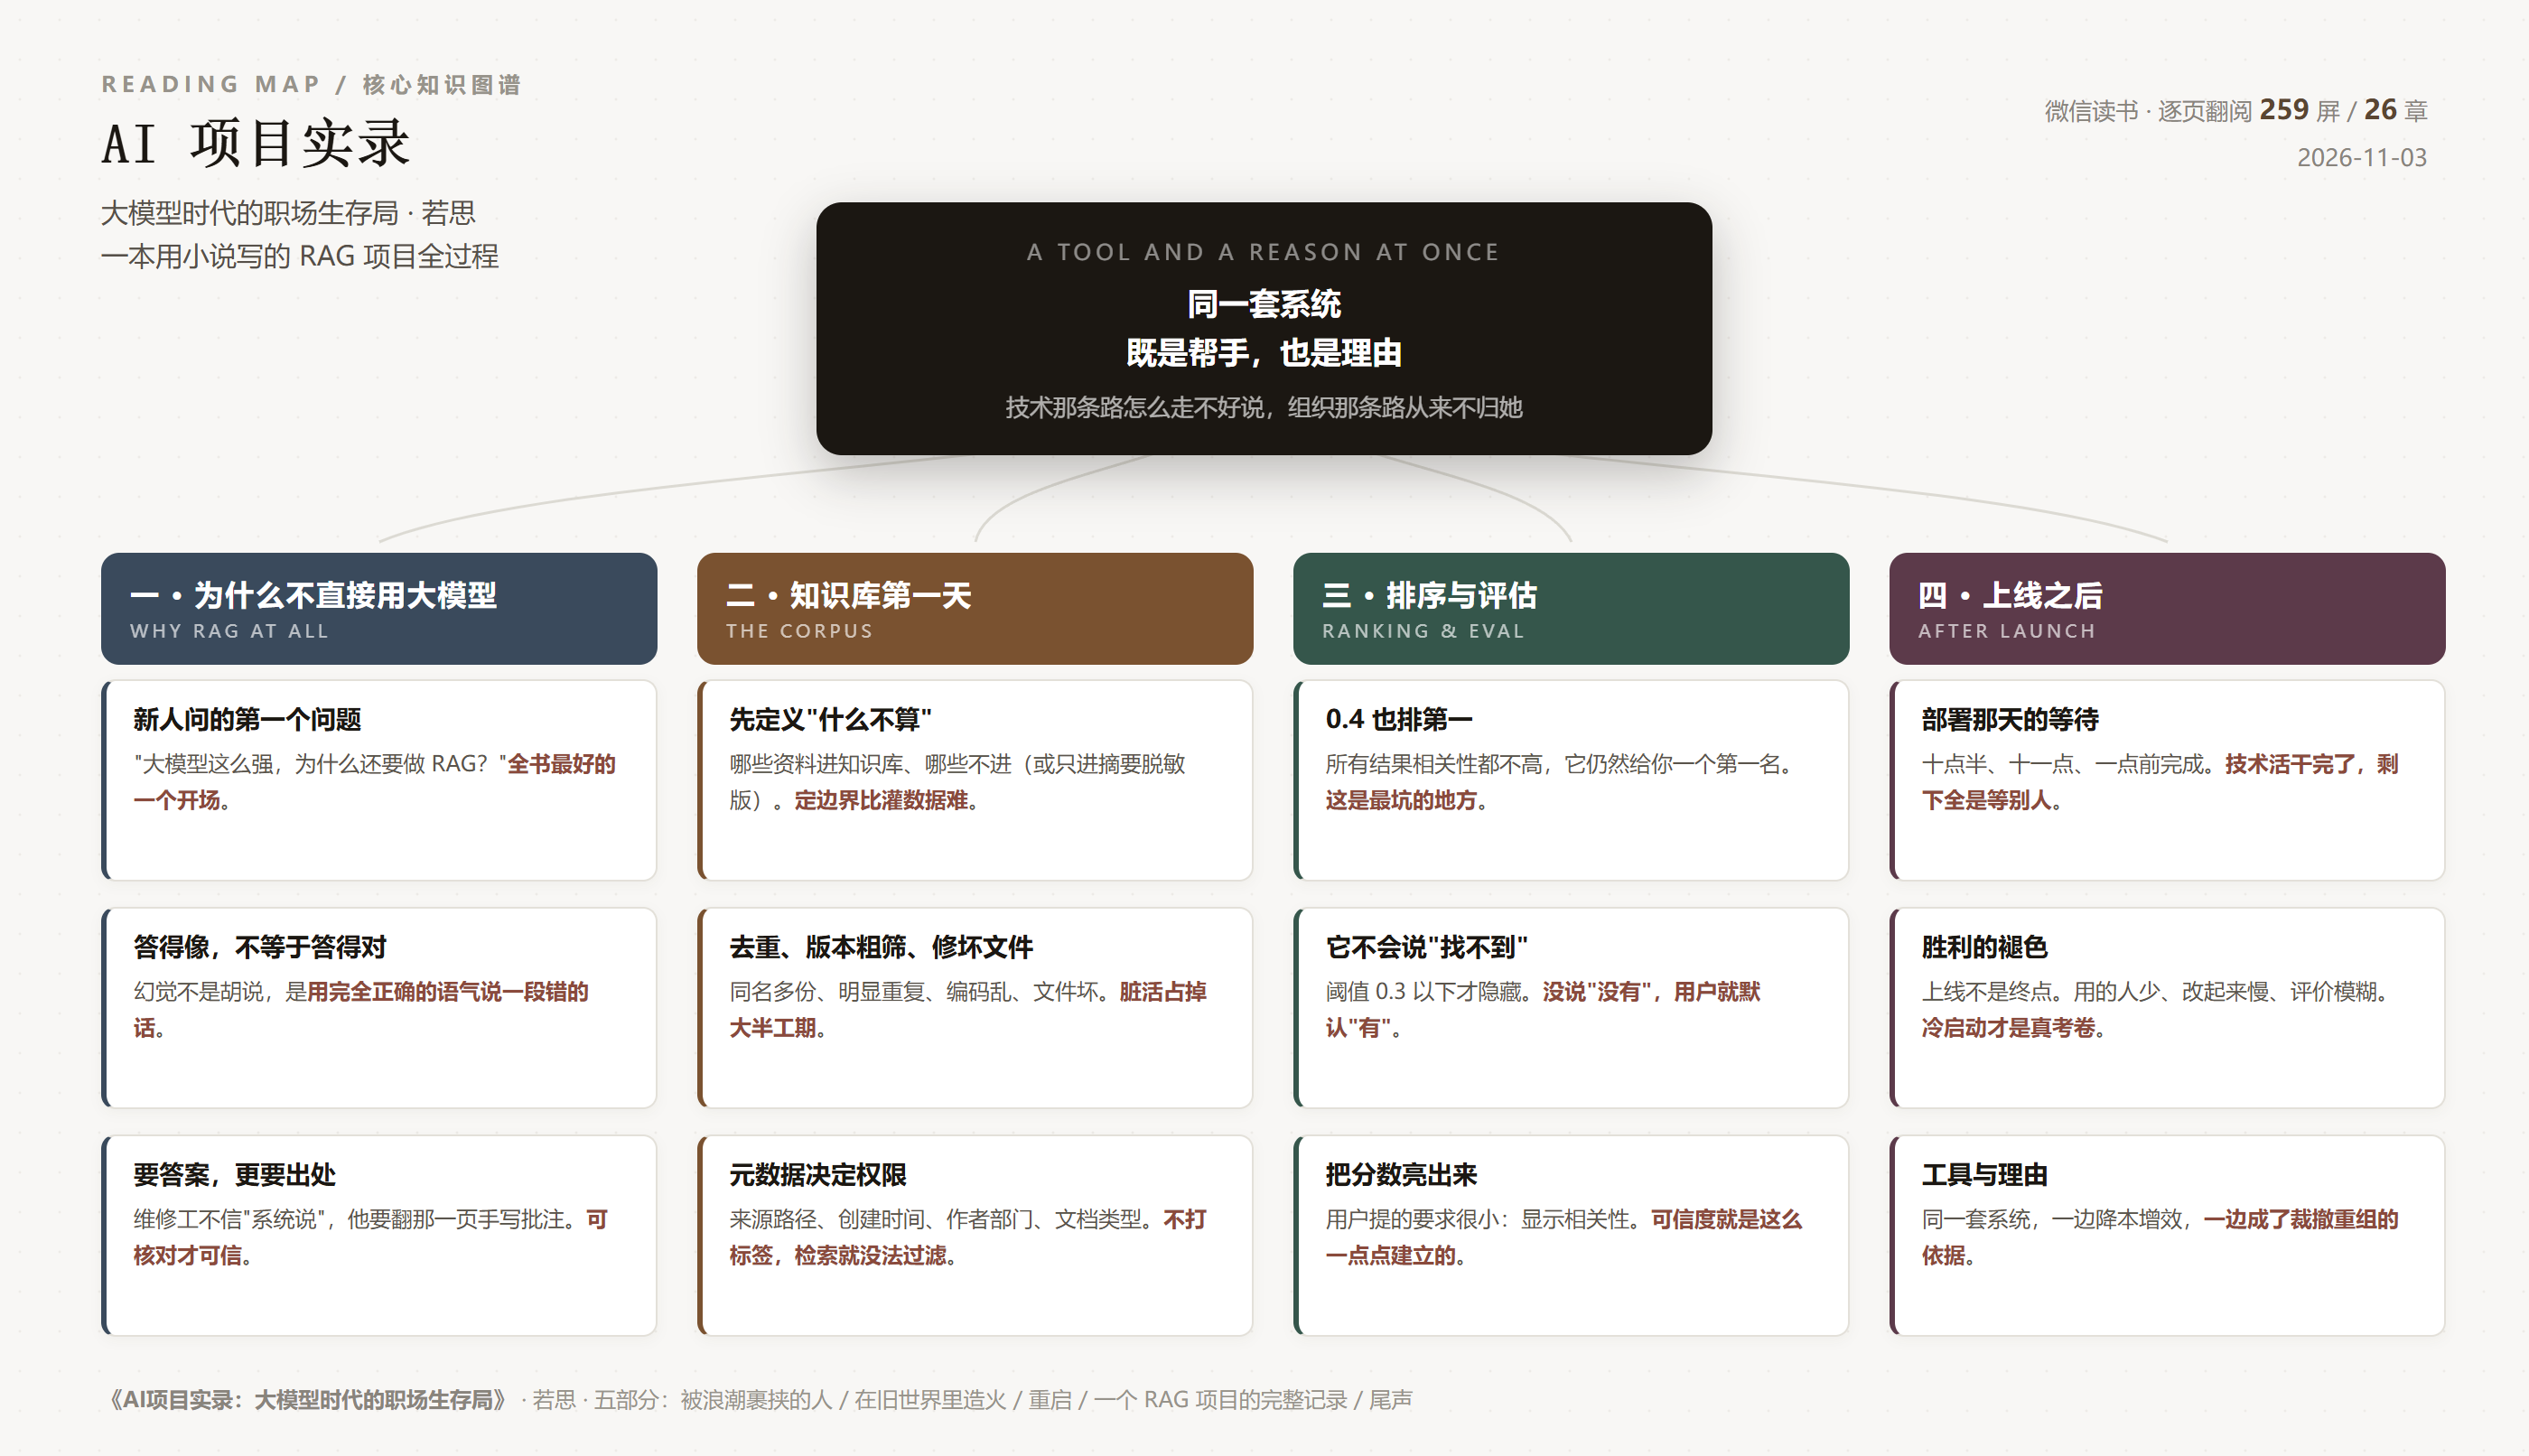
一句话总结:项目上线那天不是终点,是第一次被真实世界打分的开始。
阅读记录:《AI 项目实录:大模型时代的职场生存局》(若思),微信读书逐页翻阅 259 屏,二十六章读完,读至尾声"她会继续向前"。2026-11-03。
发表评论: