
多智能体协同:拆开任务很容易,让它自己排队、商量、善后才难
微信读书《多智能体协同:基于大语言模型的工程实践与系统构建》
逐页翻阅 487 屏 · 10 章 · 2026-11-03
说明:这本书是标准的"原理—方法—应用—保障"四段式教材写法,案例密度高。我把重点放在它敢讲代价的那部分。
多智能体这个题目,市面上大多数内容都在讲"怎么让几个 Agent 一起干活",讲得像变魔术:拆成三个角色,各司其职,问题就解决了。
这本书难得的地方在于,它没有停在"拆开就好"。
前言里有一句话把问题摆得很准:
当尝试让这个"全能选手"独自完成一项真正复杂的任务时,局限性便开始显现:它会遗忘先前的指令,会在专业领域产生幻觉,会在多步骤推理中迷失方向。这不禁让人思考:如果一个智能体不够,那么一群智能体呢?
但整本书读下来,我的感受是:它给出的答案是"一群可以,但代价不小"。
一、为什么"一群"这件事突然可行了
第 1 章讲了个关键前提:基于大模型的 Agent 群落,和传统多智能体系统不是一回事。
传统的多智能体系统,通信要靠精心设计的协议、消息格式、本体对齐,一个系统做下来,协议设计占掉大半工作量。而大模型 Agent 之间,可以直接用自然语言沟通。
书里的例子很具体:产品经理 Agent 可以用人类能理解的语言向工程师 Agent 描述需求,测试专家 Agent 可以和开发人员 Agent 就缺陷修复方案展开讨论,项目总监 Agent 可以协调整个团队的工作节奏。
这段描述听起来像拟人化修辞,但它其实点出了一件工程上的大事:协议设计这道门槛被绕过去了。
这也是为什么第一章就花篇幅讲 MCP 和 A2A。前者管 Agent 与工具之间的标准接口,后者管 Agent 与 Agent 之间。作者还提了 IBM 的 ACP 和开源社区的 ANP——前者专注 BeeAI 生态内部,后者用分层协议架构、融合 W3C DID 去中心化身份和语义 Web 原则,给开放互联网上的跨平台协作提供方案。
他的判断是:这些协议的并行发展和可能的融合,会深刻影响多 Agent 技术的未来走向。
我认同这个判断,而且觉得它比"模型会更强"更值得关注。模型强弱是渐变,协议定下来是阶跃——定完了,后来者只能适配。
二、全书最好的一个案例:动态重规划
第 3 章讲协同策略,其中"执行异常时的动态重规划"这个案例,我认为是全书写得最扎实的一处。
任务是这样的:从 CRM 导出客户数据 → 数据清洗与标准化 → 客户群分析 → 生成营销策略报告。四个子任务串行。
跑到 T2 出了问题:数据清洗 Agent 报告 35% 的记录缺少关键字段。
注意这里出错的方式——T2 本身执行成功了,是产出不满足 T3 的输入要求。书里管这叫"结果偏离触发",区别于执行失败触发。
然后重规划引擎做了三件事:
第一,评估影响。T3 依赖完整数据,当前数据质量会导致分群结果偏差。
第二,修订策略。插入数据补全与质量验证子任务,尝试从备用数据源获取缺失信息;调整 T3 的分析范围,仅基于完整记录进行分群;在 T4 中标注数据覆盖率,提示策略适用范围。
第三,改计划。T1 → T2 → T2.1(数据补全)→ T2.2(质量验证)→ T3' → T4'。
这个案例之所以值得反复看,是因为它同时展示了两件事:一是"重规划"不是"重跑",二是一个好系统必须能区分"错了"和"不够好"。
绝大多数 Agent 编排框架,只处理前者。报错就重试,超时就降级。但真实工作里,出问题的往往不是报错,是"跑通了但结果不能用"。这类失败最贵,因为它安静。
三、代价一:上下文会滚雪球
第 5 章讲生产级设计,其中对话历史压缩那一节,给了四种策略的对比,这是全书最实用的一张表。
全量保留:五千 Token 起步,随对话增长持续累积。优点是信息完整,缺点是不用多久就爆。
LLM 摘要:全部历史压成一段摘要,压缩比约 10:1,五百 Token 左右。省,但细节全丢。
最近对话缓冲:只留最近几轮完整内容,七百 Token 上下。保真,但忘事。
混合策略:历史摘要五百 + 最近对话七百,合计一千 Token,相比原始五千 Token 压缩 80%,且保留关键信息。
书里给的实现叫 SummaryBufferMemory,维护两个结构:summary 存历史摘要,buffer 存最近完整对话。新消息进来先查 Token 是否超阈值,超了就把超出部分里较早的对话交给 LLM 生成摘要,与已有摘要合并;最近三轮保持完整。
这套东西看着平常,但它解决的问题很硬:多 Agent 系统里,上下文膨胀不是线性的。三个 Agent 互相传话,每传一轮,每个人的历史都在长;传五轮,光历史就吃掉大部分窗口。
而且这里有个容易被忽略的点:压缩是有损的,损在哪必须你自己定。摘要策略默认"重要信息会被保留",但什么是重要,模型不知道你的业务。所以书里那个"最近三轮保完整"的设计很关键——它把"当前正在讨论什么"这块保住了,剩下的才交给摘要。
四、代价二:会打架,会死锁
第 6 章讲规模化,有一节专讲跨团队协作里的资源竞争。它说得很直白:当多个团队同时请求同一资源时,可能出现冲突和死锁。
给的策略有四条,我原样记下来,因为这四条基本可以直接搬到任何并发系统里:
一、实施资源预约机制,团队在使用共享资源前先申请时间窗口,避免同时访问造成冲突
二、采用乐观锁策略处理并发写入,检测到冲突时自动重试而非阻塞等待
三、为高频访问资源建立多级缓存,减少对原始资源的直接竞争
四、设置资源访问优先级,紧急任务可获得更高的资源分配权重
第一条和第二条的组合很有意思:预约是悲观策略,乐观锁是乐观策略,两个都用。这不是矛盾,是分层——计划层面悲观(先排期,避免撞车),执行层面乐观(真撞了再重试,别提前加锁拖慢全局)。
这套思路,做过分布式系统的人会觉得很熟悉。这本书的一个隐藏价值就在这:它讲的很多"AI 系统问题",其实是分布式系统的老问题换了个外壳。Agent 就是一种有网络延迟、会失败、状态不一致的服务。
五、三个递进案例:20 → 50 → 100+
第三部分用三个案例撑起"应用"这一块,规模是递进的:
20 个 Agent 的智能客服——讲任务流转、冲突消解、效果优化。这个规模的核心问题是"话术一致性":二十个 Agent 对同一个问题不能给出二十种答案。
50 个 Agent 的智慧医疗平台——讲多学科会诊、急诊协同、安全合规。这个规模的核心问题变成"责任归属":会诊结论是谁下的?出了事谁担?
100+ Agent 的智慧城市——讲分层架构、交通与 AIoT 协同、大规模性能优化。这里有个具体场景我印象很深:相邻路口的信号配时互相影响,绿波协调(Green Wave Coordination)是提升干道通行效率的核心技术,传统方案靠离线计算加人工调整,而多 Agent 系统可以做实时协商、动态优化配时。
这个递进安排是有讲究的。每一级翻倍,瓶颈就换一个位置:20 个的时候是内容一致性,50 个的时候是责任与合规,100 个以上是性能与降级。
书里对"降级"讲得比多数书实在:大规模系统必须支持分组,出事只降一组,不能让一个路口的 Agent 挂掉导致全网重算。
六、它的短板
教材腔重,重复度高。每章都有"学习目标""本章小结",同一组概念(协同价值、通信机制、分层架构)在不同章节反复出现。作为教材这是好事,作为读物会觉得注水。
案例偏"应该怎样",少"我们踩了什么坑"。三个大案例的场景设计都很完整,但读起来更像方案书,不像复盘。真实的坑——比如某个 Agent 因为提示词里一句话理解偏差,导致整条链全错——这类细节很少。
代码是演示级的。框架章节(AutoGen、LangGraph、CrewAI)的示例能跑,但离生产还有距离。书里也没回避这点,它把生产级内容放在第 5 章单独讲。
但它做对了一件重要的事:把"多智能体"从概念拉回到了工程账本上。
它一直在算账:多一个 Agent,多一份上下文开销;多一层协作,多一类冲突可能;多一倍规模,多一种失效模式。读完不会让你更想堆 Agent,会让你更谨慎地决定什么时候不该堆。
而这恰恰是这类书最该起的作用。
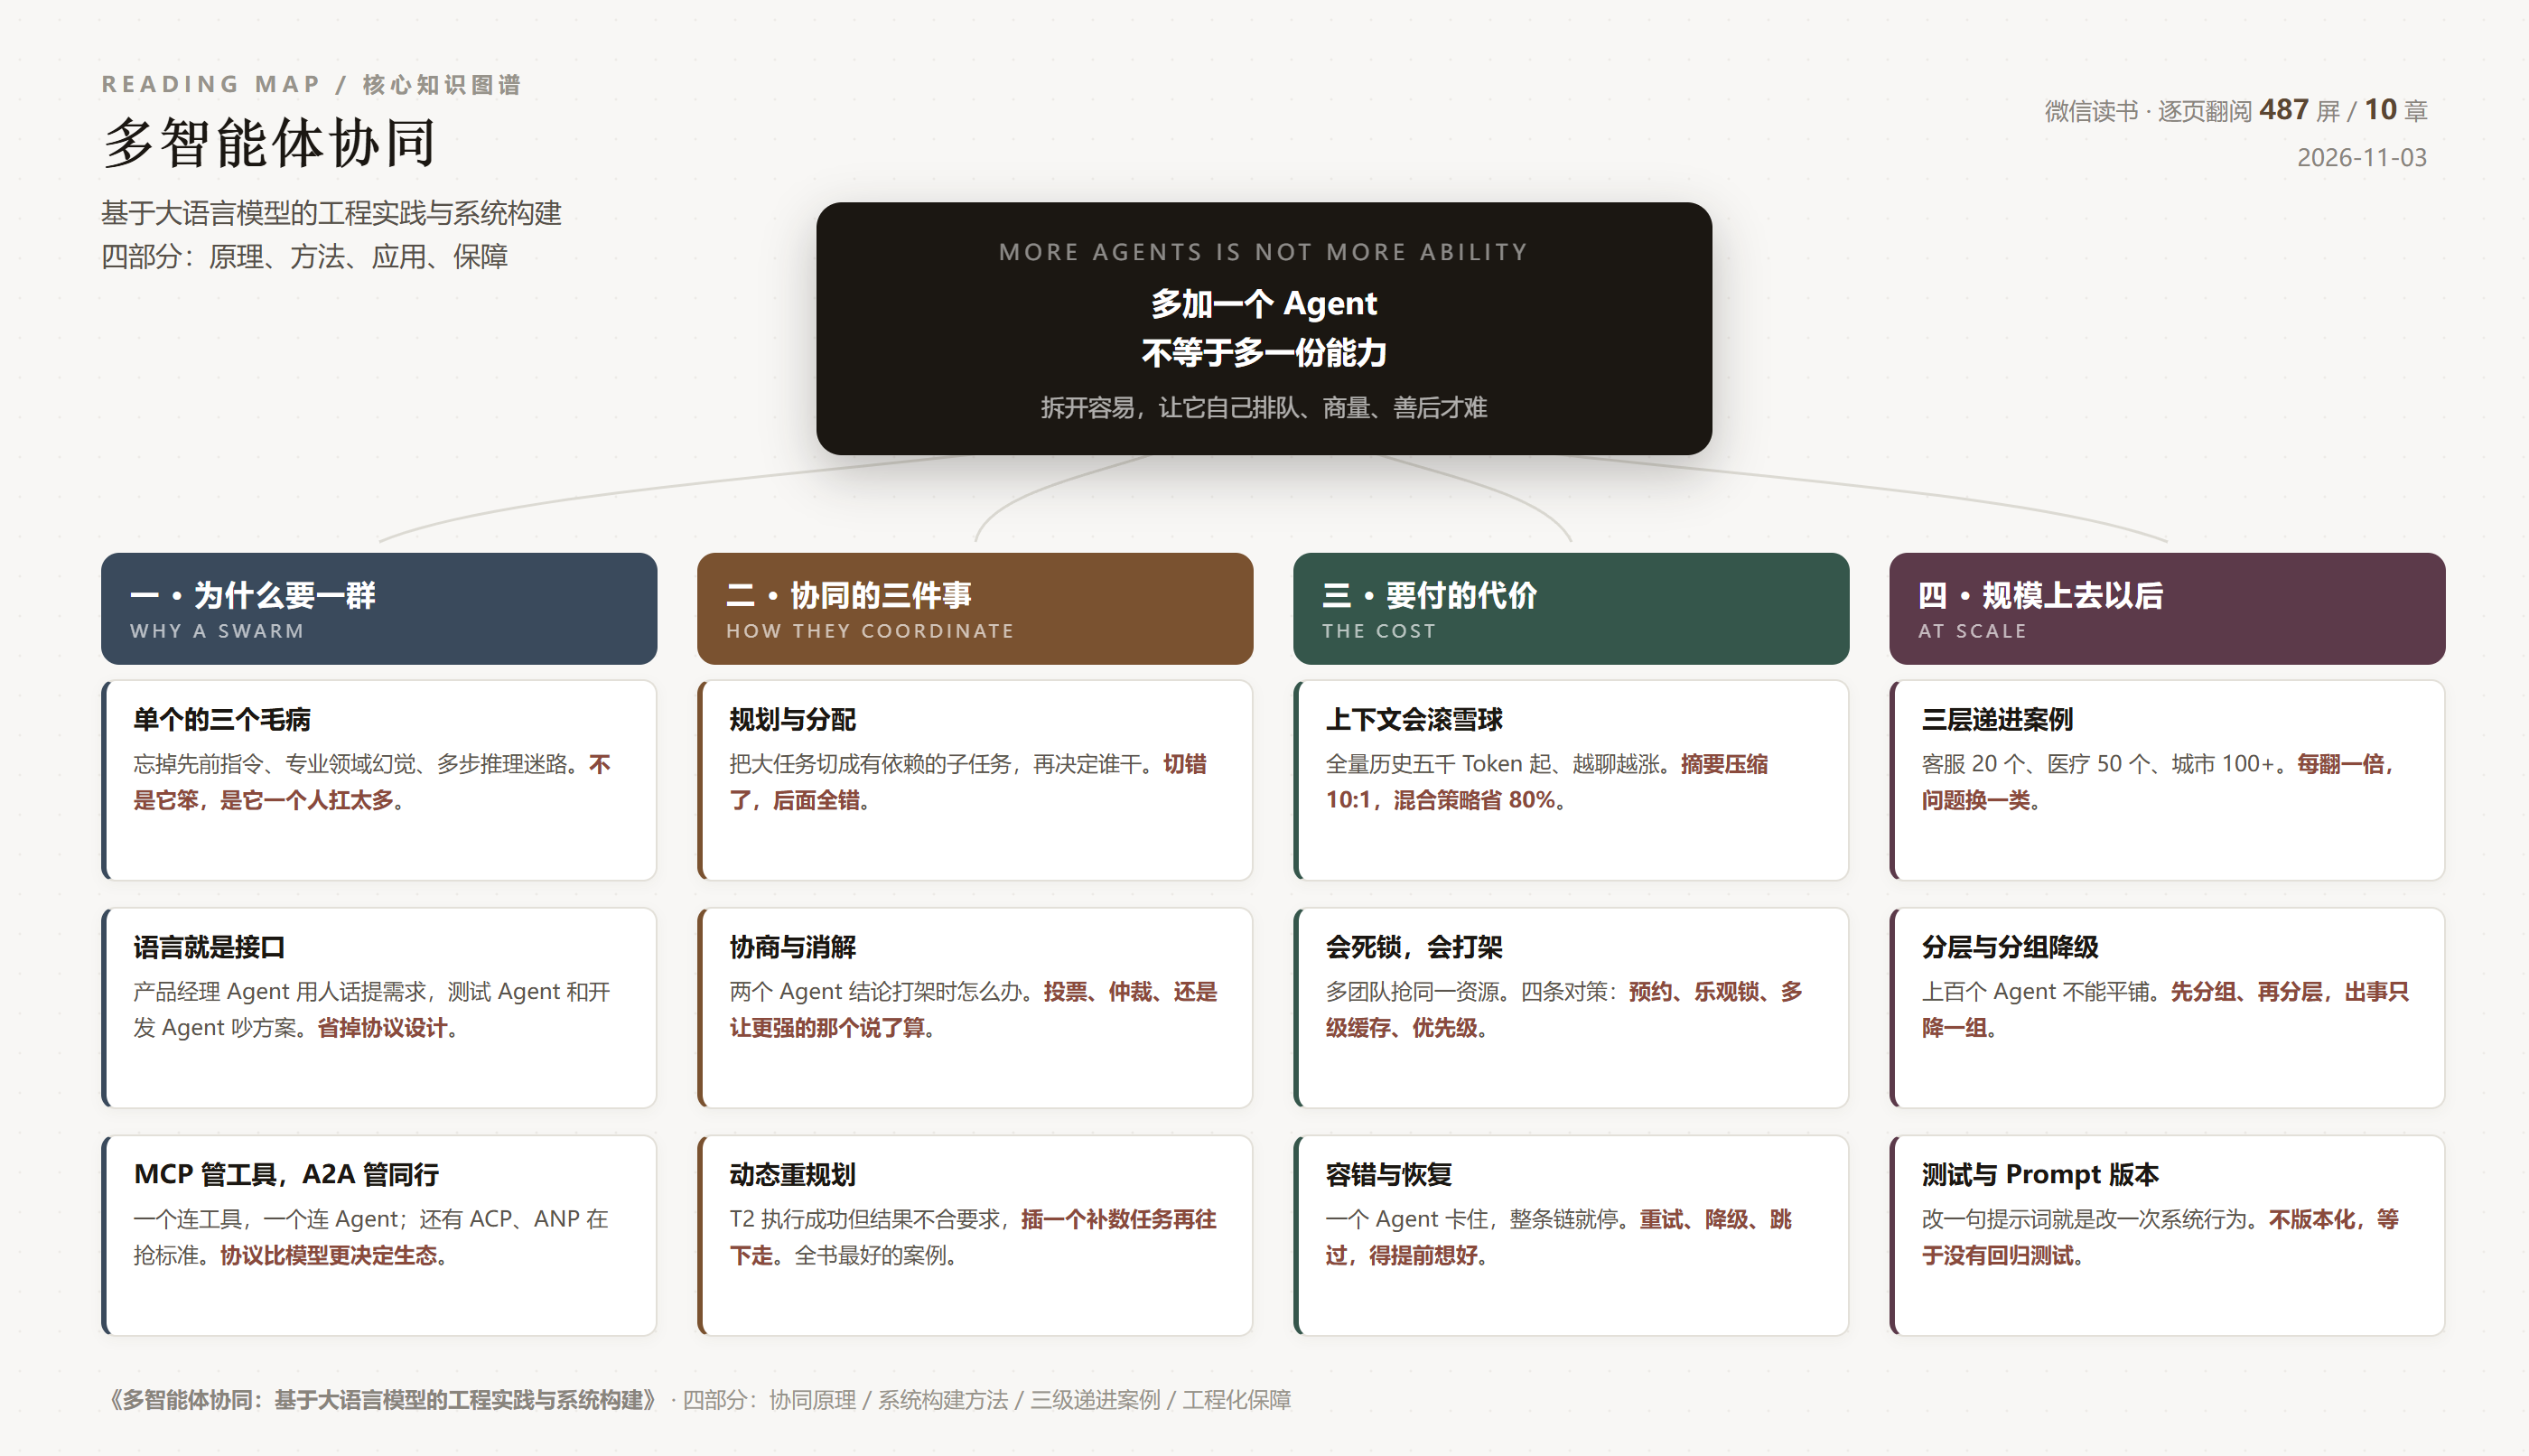
一句话总结:拆开一个任务很容易,难的是让拆开的那些部分自己排队、商量、善后。
阅读记录:《多智能体协同:基于大语言模型的工程实践与系统构建》,微信读书逐页翻阅 487 屏,十章读完,读至第 10 章安全合规与运维保障。2026-11-03。
发表评论: