
框架能替你装零件,替你选不了机器
阅读方式:微信读书网页版,从第 1 章翻到第 7 章末,共 282 屏、6 分 30 秒。
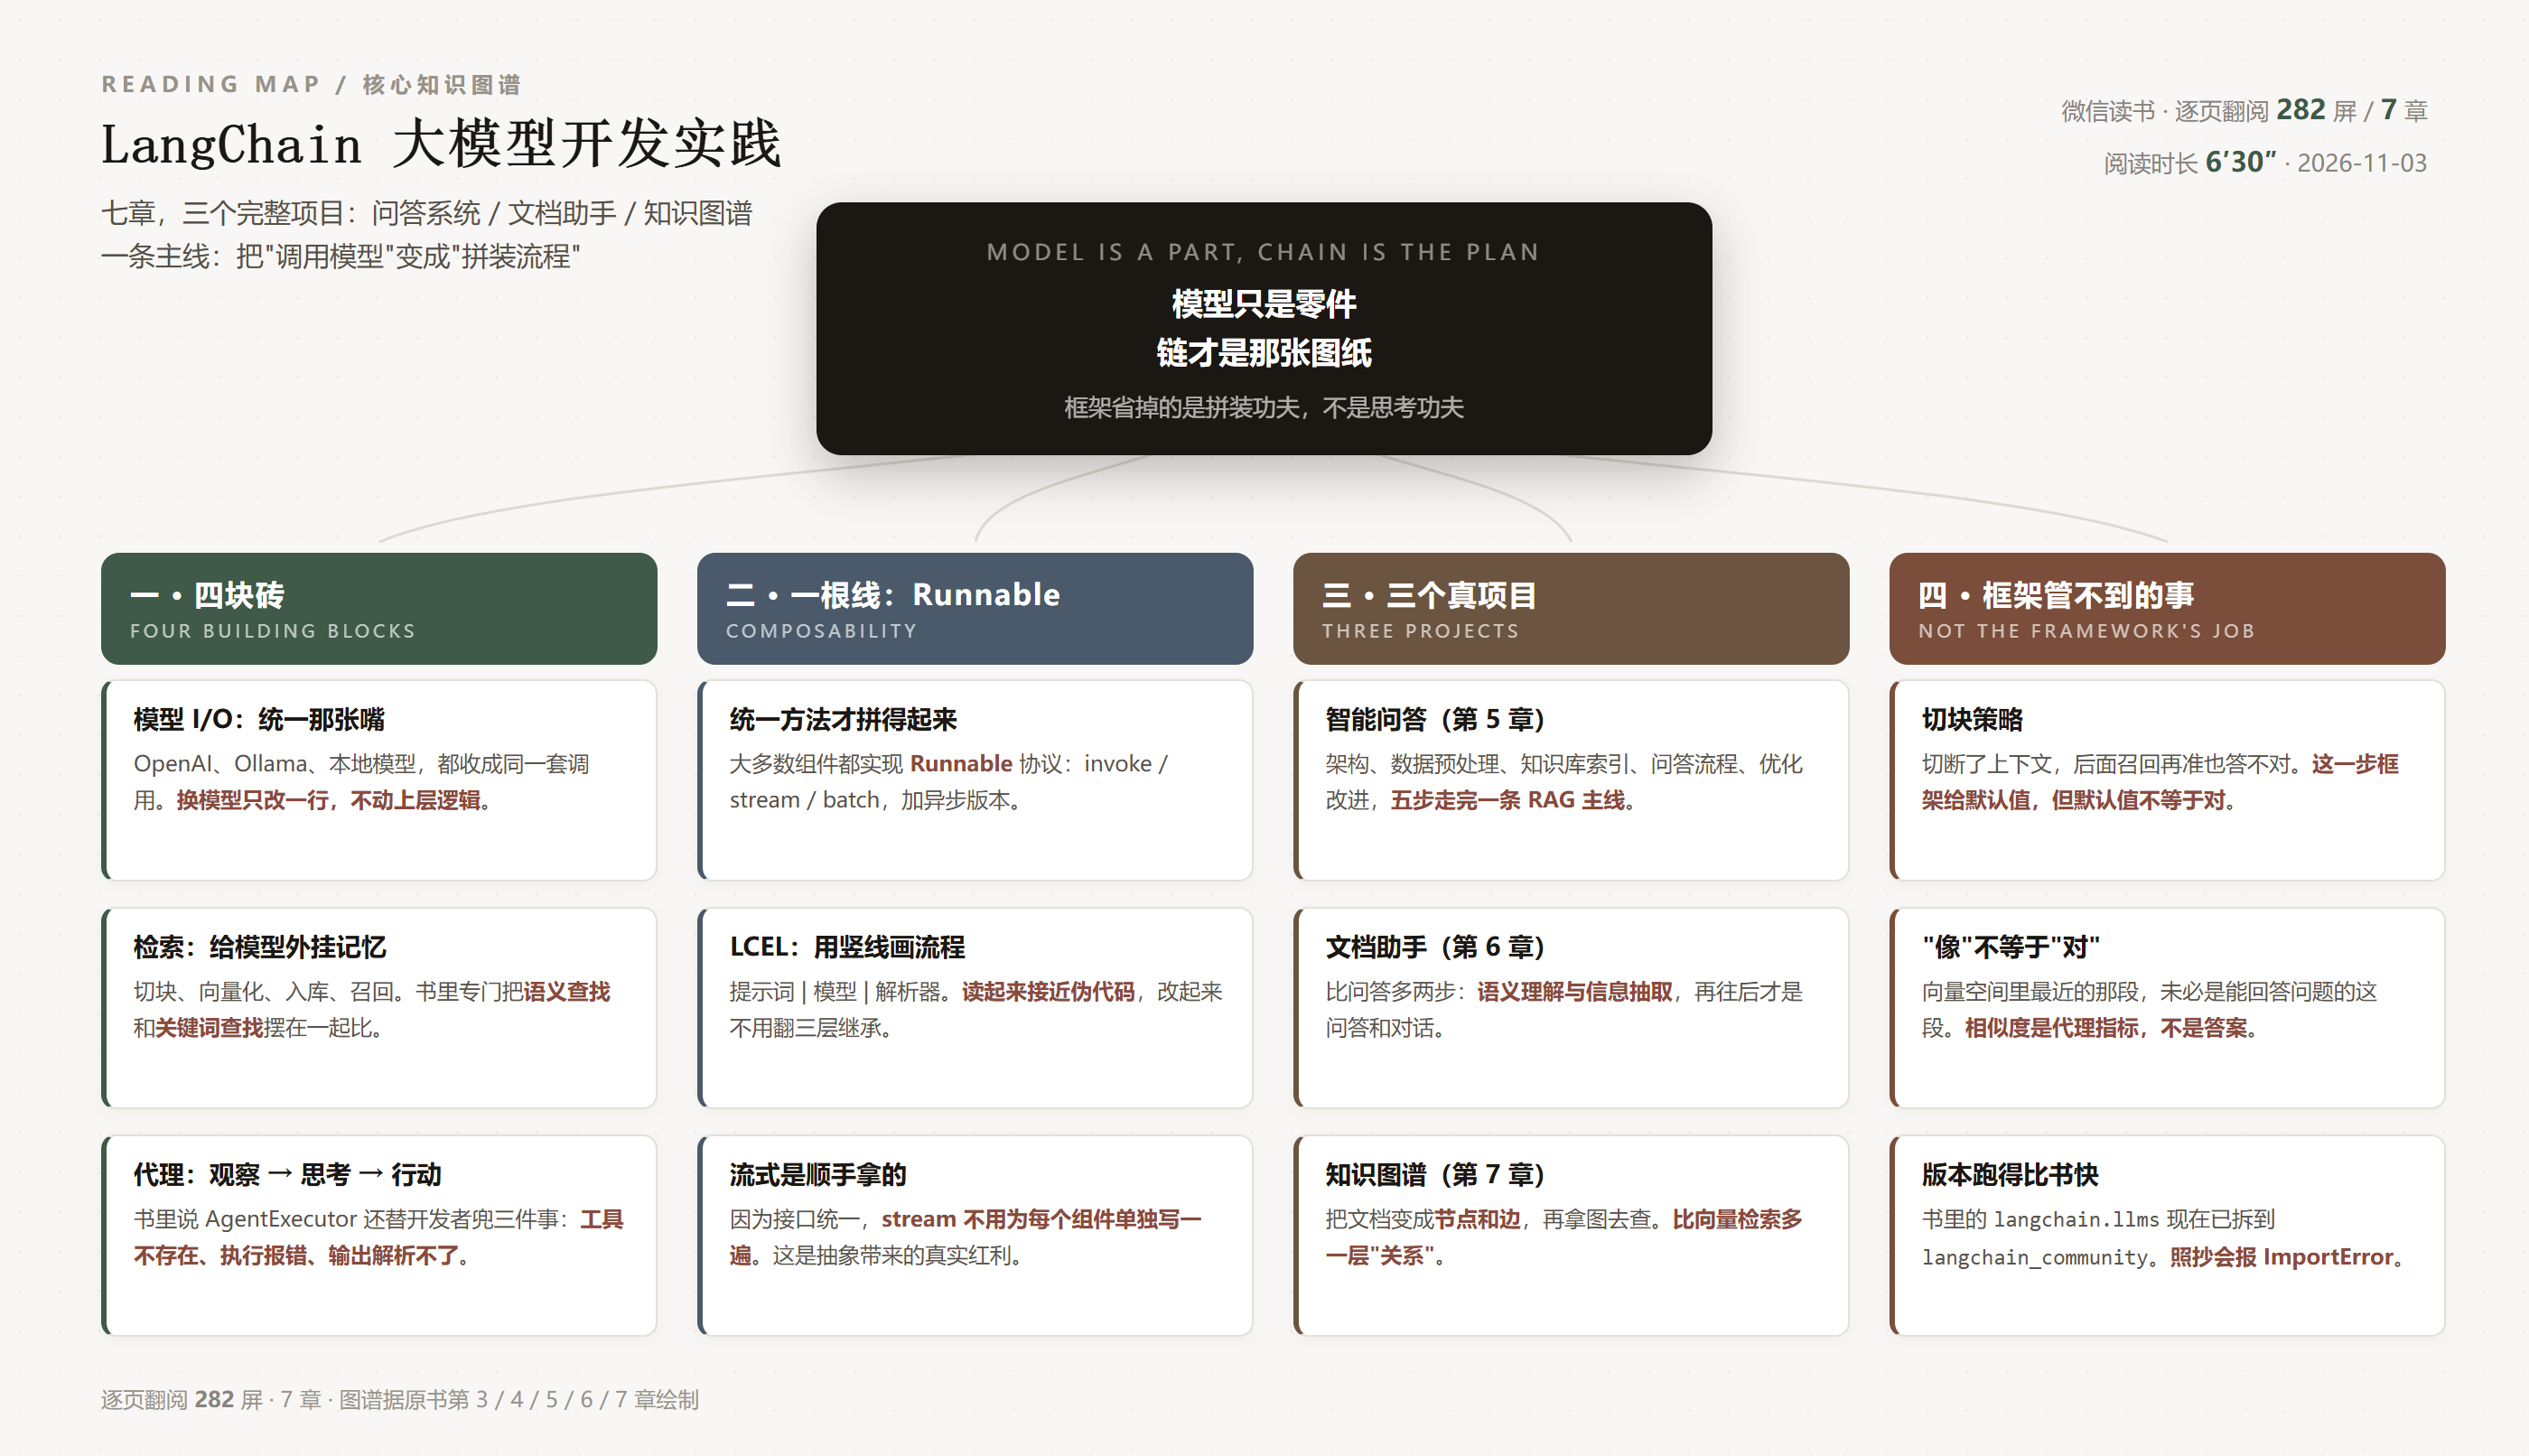
结构:基础(框架与组件)→ 表达式语言(LCEL / Runnable)→ 三个实战项目(问答系统、文档助手、知识图谱应用)。
先说结论:这本书不是教你用 LangChain,是教你把一个 LLM 应用拆成能动手术的零件。
因为框架本身没什么神秘的。调用一次模型是三行代码,加个提示词模板是五行,接个知识库也就几十行。真正难的是这东西长到两千行以后,你还敢不敢改。
书里第 1 章给 LangChain 下的定义,恰好点在这个位置:
"LangChain 是一个用于开发由语言模型驱动的应用程序的开源框架。它提供了一套工具和组件,帮助开发者将语言模型链接到上下文源,如提示指令、少量示例、内容等,以使其响应更准确、更贴合上下文。"
注意"链接到上下文源"这几个字。它没说"帮你调模型",说的是"帮你把模型和资料接起来"。 这个定位决定了全书的重心:模型 I/O 只占一节,检索和链占了整整两章。
一、四块砖:模型、检索、链、代理
第 3 章叫"基础组件",四节分别是 模型(Model I/O)、文档检索、代理、链。
我一开始觉得这个顺序有点怪——链应该放前面才对,它才是骨架。但读下去发现,这个顺序其实是"从零件到装配":
模型 I/O——怎么把话说给模型,怎么把话接回来。所有上层都建在这个接口上。
文档检索——模型不知道你的资料,得先找出来再塞给它。
链——一步不够就串三步,前一步的输出正好是后一步的输入。
代理——不预设串哪几步,让模型自己决定下一步干什么。
这四块的分界线,其实是"决定权在谁手里":前三块的决定权在你(写代码的人),第四块的决定权交给了模型。 代理之所以复杂,就是因为把决定权让出去之后,你得替它兜底。
书里对这件事说得很实在。它讲 AgentExecutor 的时候,列出的不是"它能自动规划"这种漂亮话,而是三个具体要处理的问题:
"AgentExecutor 为开发者处理了诸多复杂问题,如处理不存在的工具、工具执行错误、输出无法解析为工具调用等情况,同时在所有级别(包括代理决策和工具调用)提供日志记录和可观测性。"
这三件事,恰好就是"把决定权让给模型"的代价清单。模型会调一个你没注册的工具,会把参数写错,会输出一段根本不像工具调用的自然语言。 框架能做的是不让程序崩掉,不能做的是让它别犯。
二、真正的主角是 Runnable
第 4 章讲 LCEL(LangChain 表达式语言),标题里有两个词:简化 LLM 的开发、Runnable 接口。
很多人把 LCEL 理解成"管道语法糖",就是 prompt | model | parser 那根竖线。这是个误解。竖线本身没有价值,有价值的是竖线两边的东西凭什么能拼。
书里 4.3.1 节给了解释:大多数组件都实现了 Runnable 协议,这个协议定义了一系列标准方法——invoke()、stream()、batch(),以及对应的异步版本。
关键在于"标准"这两个字。因为接口一样,所以任意两个组件都能串;因为能串,流程才写成一行而不是嵌套十层回调。
这里有个容易被忽略的红利:流式输出。 如果你的组件各自为政,每个都得单独实现一遍"边生成边吐字";但接口统一以后,stream() 是白送的。抽象做对了,很多功能不用写就有了——这是我读这一章最大的收获。
顺带说一句我的判断:LCEL 的价值不在省代码,在省"读代码的时间"。 一个 prompt | model | parser 摆在眼前,你不用翻实现就知道数据怎么流。这在三个月后回来改自己的代码时,比什么都值钱。
三、向量检索不是"更聪明的搜索"
第 5 章 5.4 节讲知识库索引,里面有一张图叫"语义查找和关键词查找"。这张图值得单独说。
书里的解释是:
"在语义搜索中,文档的潜在向量表示会在训练过程中被推断出来,并投影到潜在空间。在推理时,传入的查询也会转换成相同的潜在空间表示……空间中与查询最近的点会被检索为与查询相似的文档。"
这段话技术上讲得没错,但它容易让人产生一个错误直觉:以为"向量近"等于"内容对"。
不是的。向量空间里的距离衡量的是"表达相似",不是"能回答问题"。 你问"这个接口报 401 怎么处理",检索回来的可能是三段同样在讲"401 是什么"的文档,而真正管用的那段"在 token 过期时刷新凭证"因为用词完全不同,排在了第十位。
所以这一节真正的工程含义是:语义检索解决的是"字面不匹配",没解决"答非所问"。 后者要靠重排(rerank)、要靠查询改写、要靠把切块切得合适——而这些,框架只能给你默认值。
书里也承认这一点,它在 5.6 节专门写了"优化和改进问答系统"。但说实话,这一节是全书最薄的地方。 五页讲完,而实际项目里 80% 的时间都花在这儿。
四、代理那三段循环,书里画得最清楚
第 3 章 3.4 节讲代理,给了一张执行流程图。这张图把 agent 讲成三个阶段:
观察(Observation)——接收外部触发,解析输入,提取关键信息。
思考(Thought)——用预设规则、知识库或模型分析观察到的信息,确定怎么响应。这里面包含"理解意图、推断所需工具、提取运行工具所需的参数"。
行动(Action)——执行具体动作:填充参数、执行工具、生成响应。结果回到观察,循环。
我见过很多讲 agent 的文章,把这三段说成"感知—决策—执行",听着高级但不落地。书里这段好在它把"思考"拆开了:理解意图、推断工具、提取参数。
拆开之后问题就清楚了:这三件事里最容易错的是第三件。 意图常能听懂,工具常能选对,但参数经常填错——日期格式、ID 拼写、单位。而参数错一个,整条链就白跑。
这也解释了为什么"工具描述"要写得那么细。模型选工具靠的是描述,填参数靠的也是描述。 你写"查询天气",它就只敢传城市名;你写"查询天气,参数 city 为城市中文名,date 为 YYYY-MM-DD",它才可能填对。
五、三个项目,是三种"记忆方式"
第 5、6、7 章是三个完整项目。乍看是三套代码,读下来我觉得它们是三种不同的"让模型记住东西"的办法:
问答系统(第 5 章)——把资料切块存进向量库,用到时捞出来。记的是片段。
文档助手(第 6 章)——多了一步"信息抽取",先把文档变成结构化字段,再问答。记的是字段。
知识图谱(第 7 章)——把文档变成节点和边,用关系去查。记的是结构。
这个递进很有意思:片段 → 字段 → 结构,越往后越贵,也越能回答"关系类"的问题。
举个具体的:问"张三和李四是什么关系",向量检索大概率给你两段分别介绍张三、李四的文字,然后模型自己猜;知识图谱则直接沿着边走过去,一步到位。但建图的成本,可能是建向量库的十倍。
所以选型不看哪个先进,看你的问题里"关系"占多大比重。大部分客服问答,片段够了;一旦开始问"谁影响了谁""这个改动牵连哪些模块",就得上结构。
第 6 章还有个细节值得记:它用 ConversationChain 加一个带 {history} 和 {input} 的模板实现多轮对话。书里写这个模板的用意是"让 AI 助手在回答问题的同时,也主动提出后续问题,引导多轮对话"。这是把"多轮"当成提示词工程来做,而不是当成状态管理来做。 便宜,但也脆——history 一长就塞不下。
六、这本书的三个短板
第一,版本跑得比书快。 书里的示例写 from langchain.llms import ...,现在的 LangChain 已经把这些实现拆到 langchain_community、langchain_openai 里了。照抄一定报 ImportError。 这不是书的错,是这类技术书的宿命——但读的时候必须知道,代码是"示意",不是"可运行"。
第二,深度偏"能用"。 全书最厚的是三个项目的流程,最薄的是"为什么这么设计"。比如切块策略,书里给了默认参数,但没讲"切多大合适、为什么"。而这恰恰是 RAG 效果的头号变量。
第三,评估几乎没讲。 一个 RAG 系统上线以后,怎么知道它答得好不好?召回率怎么测?幻觉率怎么测?书里没有专门章节。 这可能是这类实践书共同的缺口——它们教你怎么搭起来,不教你怎么知道搭对了。
七、一句话收尾
框架能替你做的,是把零件装成机器;
不能替你做的,是判断该装哪台机器。
如果只带走一句:学 LangChain,别学它的 API,学它把流程切成"可替换零件"的那个习惯。 API 半年就变一次,这个习惯能用十年。
阅读记录:微信读书网页版逐页翻阅,282 屏 / 390 秒 / 7 章,2026-11-03。
提示:书中代码依赖较旧版本的 langchain,直接运行前请先对照官方文档调整导入路径。
发表评论: