
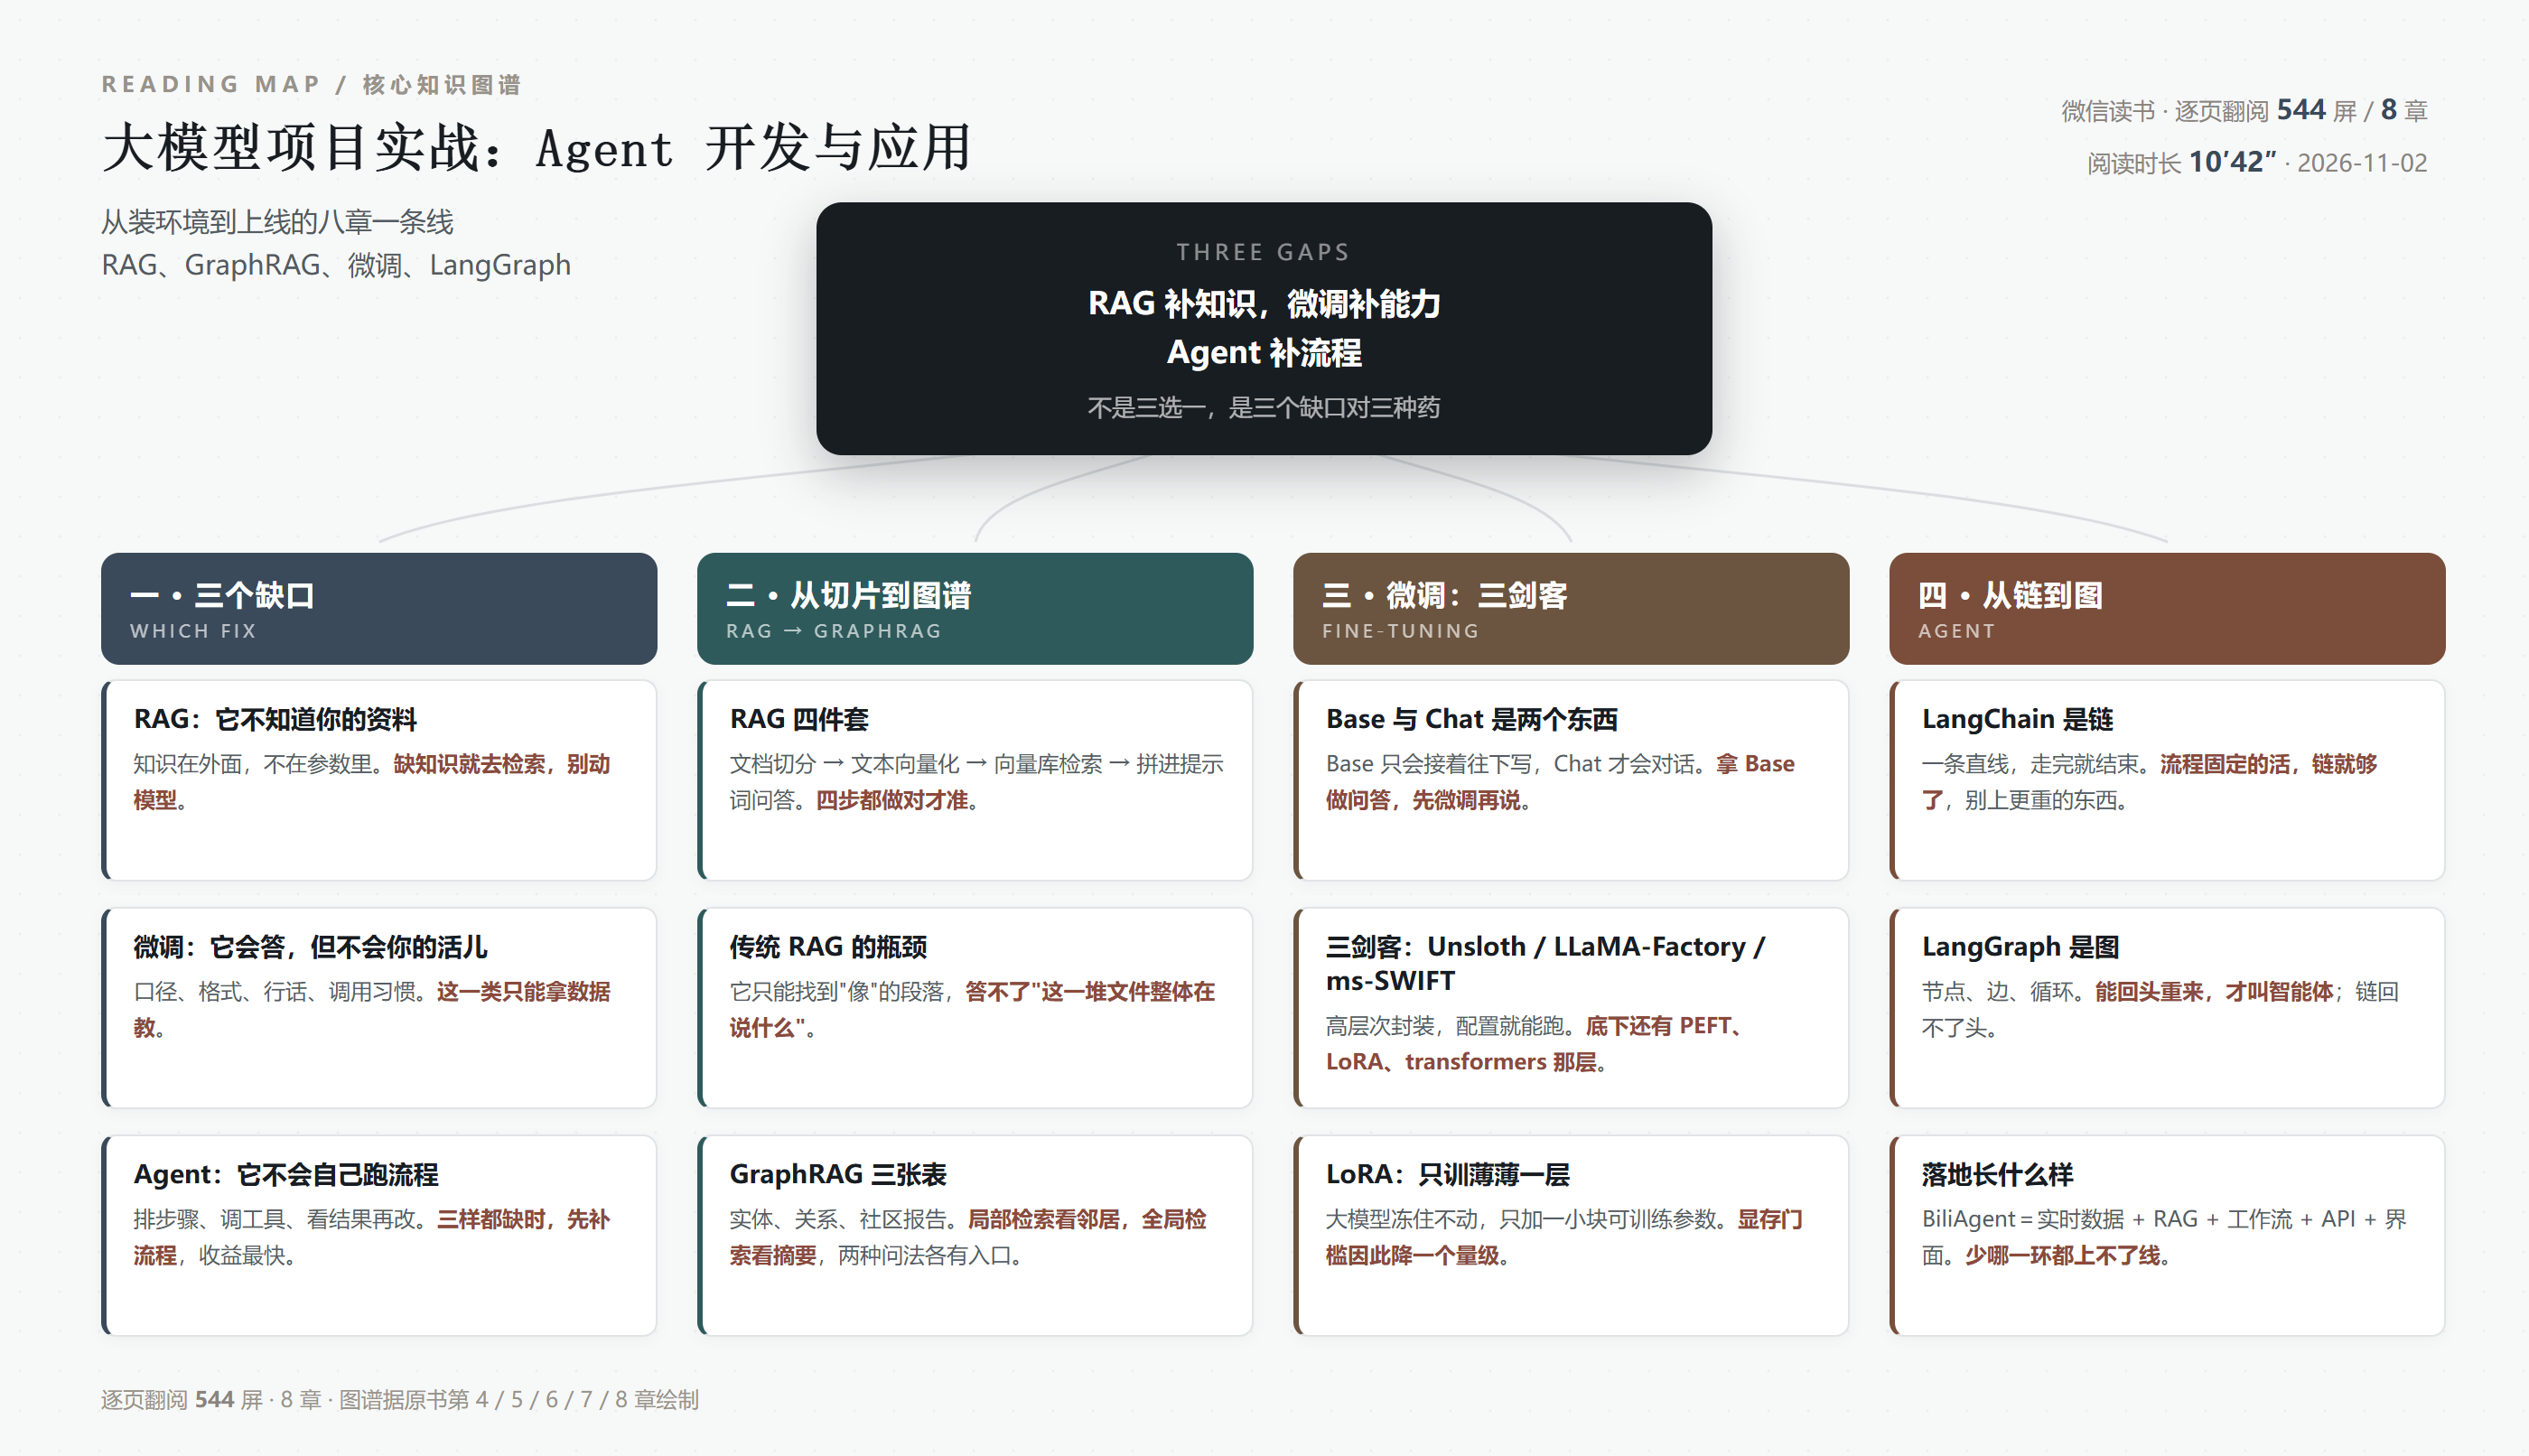
缺知识补知识,缺能力补能力,缺流程补流程
阅读方式:微信读书网页版,从版权页翻到第 8 章末,共 544 屏、10 分 42 秒。
结构:八章一条线——Agent 基础、模型接入与本地部署、DeepSeek 双模型、RAG、GraphRAG 实战、微调、LangChain/CrewAI、BiliAgent 企业项目。
先说结论:这本书不聪明,但它完整。
"不聪明"是指它没有提出什么新观点,绝大多数篇幅是"打开记事本,把这段代码抄进去"。"完整"是指它把一个真实项目从装驱动到出界面,全走了一遍,而且没跳步。
在这类书里,完整比聪明稀缺得多。大部分教程停在"跑通一个 demo",读者真正的坑在 demo 之后。
一、它最好的一处,是把三种"不行"分开了
全书 544 屏,我认为最有价值的是一个分辨:模型答不好,是三种完全不同的病,得吃三种不同的药。
缺知识——它不知道你公司的文档 → 用 RAG
缺能力——它会答,但不会你的口径、格式、行话 → 用微调
缺流程——它不会自己排步骤、调工具、看结果 → 用 Agent
这三条正好对应书中三个技术块的位置:第 4、5 章讲 RAG,第 6 章讲微调,第 7、8 章讲 Agent。章节顺序本身就是一张诊断表。
为什么这个分辨重要?因为最常见的失败是拿一种药治三种病:知识库不够就跑去微调(想让模型背下你的文档),流程没设计就先换更大的模型(指望它自己会规划)。钱花了,问题还在。
书里没有把这条判据写成一句漂亮话,是我从它的目录结构里读出来的——但目录结构比正文更诚实。
二、RAG 的天花板,与 GraphRAG 补的那块
第 4 章前半是标准 RAG 四件套:文档切分、文本向量化、向量库检索、拼进提示词问答。这四步任何教程都讲,不算这本书的功劳。
真正的信息量在 4.2 节——传统 RAG 的瓶颈。
一句话概括:向量检索只能找到"相似"的段落,它答不了"这一大堆文件整体在说什么"。
你问"这份年报里客户的抱怨主要集中在哪三类问题",向量检索会捞回三段都带"抱怨"字样的文字,然后模型拿这三段编一个分类。它没有读过全局,它只是在相似度最高的几段里凑答案。
GraphRAG 补的就是这块。书里讲了它的索引产出,落到三张表上:
实体表(知识图谱的节点:人、地点、组织)
关系表(实体之间的边)
社区报告表(基于知识图谱生成的、每个"社区"的摘要)
"社区报告"这个概念是 GraphRAG 的关键:它把图聚成一群一群的社区,先给每群写一份摘要,再让摘要往上汇总成更高层的摘要。于是"整体在讲什么"这个问题,第一次有了能查的东西。
对应两种问法,两个入口:局部检索(LocalSearch)看某个实体的邻居,全局检索(GlobalSearch)看社区摘要。问细节用前者,问大势用后者。
第 5 章还留了一个特别真实的坑:想让 GraphRAG 用本地 Ollama 的模型,得改它的源码——重写 OpenAIEmbedding 类里的 embed 方法,把对 OpenAI 接口的依赖去掉,换成 Ollama 的 embeddings 接口。这种"官方还没支持,你自己动手"的段落,才是实战书该有的样子。
三、微调那章:一个被忽略的常识
第 6 章开头讲了一件很多人不知道的事,我照抄:
绝大多数开源模型都会公布两个版本:Base 模型只经过预训练,没有经过全量指令微调;Chat 模型(或带 instruct 后缀的)是在预训练模型基础上做过指令微调的。
这句话解决一个很常见的困惑:为什么我下的模型只会"接着往下写",不回答我的问题?
因为你下的是 Base。Base 的本能是续写,Chat 的本能才是对话。 拿 Base 做问答,要么换模型,要么先微调——而很多人以为是自己的提示词写得不对。
然后是工具。书里把微调工具分成两层,分得很干脆:
上层是"三剑客"——Unsloth、LLaMA-Factory、ms-SWIFT。高层次封装,写个配置文件就能跑。作者建议初学者从这三个里挑一个入手。
下层是库——PEFT、LoRA、transformers。想搞明白"到底改了什么",才需要往下看。
而 LoRA 之所以是现在的主流,理由朴素得不像技术:大模型冻住不动,只在旁边加一小块可训练的参数。 于是显存门槛直接降一个量级,一张消费级卡也能做实验。
书里第 6 章的实验选得也聪明:拿一个医疗问答数据集去微调 DeepSeek-R1 的蒸馏版。 先跑原模型问同一个医疗问题,再做最小可行实验,最后完整微调,三步对比。有没有效果,一眼能看出来。
四、从链到图:那条分界线在哪
第 7、8 章讲 Agent。这里有一条我认为值得单独拎出来的分界线:LangChain 是链,LangGraph 是图。
链是一条直线:A 完了到 B,B 完了到 C,走完就结束。流程固定、步骤已知的活,链就够了,而且更便宜、更好排查。
图有节点、有边、还能循环:走错了可以回头,可以重新规划,可以在某个条件满足前一直绕。能回头,才叫智能体。
书里第 8 章的 BiliAgent 项目,正好把这条演进走了一遍:先用 LangChain 做生成链(抓 B 站动态、处理实时数据、做 RAG 封装),再把同样的逻辑迁到 LangGraph 做工作流,最后用 LangServe 加 FastAPI 包成 RESTful 接口,用 Streamlit 做界面。
这个顺序其实是一份上线清单:能跑(链)→ 能纠错(图)→ 能被调用(API)→ 能被人用(界面)。 少哪一环,都停在"我这里能跑"的阶段。
五、这本书的短板
一是绑死版本。 DeepSeek-V3、R1 蒸馏版、GLM、Qwen 的具体型号,SGLang/LMDeploy/vLLM/Ollama 的部署命令,全绑在具体版本上。书里给的命令,半年后基本要改。
二是代码占比过高,解释太少。 很多段落是"核心代码如下"接三十行代码,读者知道怎么做,但不知道为什么要这么设计。想理解原理的人会失望。
三是有些内容注定过期。 第 5 章改 GraphRAG 源码适配 Ollama 那种段落,等官方支持本地 embedding 之后就作废了。这不是作者的错,是这类书的宿命。
四是广而不深。 微调只做了一个最小可行实验,Agent 只到 BiliAgent 一个项目,每一块都能再写一本书。想深入任何一块,都得另找资料。
它的价值因此很具体:它替你走了一遍那条路,并把路上的坑标出来了。 你未必需要它的代码,但你确实需要知道"这里会卡住"。
六、一句话
这类实战书的价值不在"教会你",在"让你少走一遍他走过的路"。它最该被记住的不是某段代码,而是那张诊断表:缺知识补知识,缺能力补能力,缺流程补流程——三样混着补,等于三样都没补。 把这句话贴在项目开头,能省掉一半返工。
阅读记录:微信读书网页版逐页翻阅,544 屏 / 10 分 42 秒,8 章。
本书知识图谱见文中配图,原图地址:https://www.jiangtian.top/zb_users/upload/kg/llm-agent-project-map.png
发表评论: