
智能体不缺框架,缺的是一套说得清的话
阅读方式:微信读书网页版,从推荐语翻到第 7 章末,共 296 屏、6 分 53 秒。
结构:上篇(为什么需要一场"再发明"、从对象到 Agent 的地基、Agent 时代)+ 下篇(感知、记忆、推理、行动四族共 13 个模式)。
这本书干的是一件很硬的事:它想把 GoF 那套"设计模式"的传统,重新焊到智能体上。
1994 年那本《设计模式》给了软件业 23 个名字。名字的作用被严重低估了——有了"观察者模式"这个词,一个团队才能在五分钟内对齐一件本来要画三页图的事。
智能体这一代的问题恰恰相反:框架一堆(LangChain、LangGraph、Coze、Dify),词却没有。 你说不清"这块该归记忆还是归推理",最后的结果就是同一段逻辑反复重写。
这本书就是在补这套词。作者王常圣,296 屏,一半在讲为什么,一半在给模式。
一、"诸神的黄昏":确定性遇上不确定性
上篇三个小标题,我照抄,因为它们本身就是论证:
1.1 GoF 的贡献:秩序的承诺
1.2 黄金时代:设计模式的繁荣与边界
1.3 诸神的黄昏:当确定性遇到不确定性
这个三段式很省字。"秩序的承诺"是说 GoF 那 23 个模式成立的前提——代码的行为是确定的。同一个输入,永远同一个输出,所以你才敢把结构抽象出来复用。
而大模型把这条前提抽掉了。第 2 章最后一节叫"软件 2.0:当概率遇见代码",讲的就是这件事:一段可能给出不同答案的逻辑,没法用"输入—处理—输出"的老办法切分。
"诸神的黄昏"这个说法有点文艺,但意思很硬:不是设计模式没用了,是它赖以成立的确定性没了。 所以需要一场"再发明",而不是一次升级。
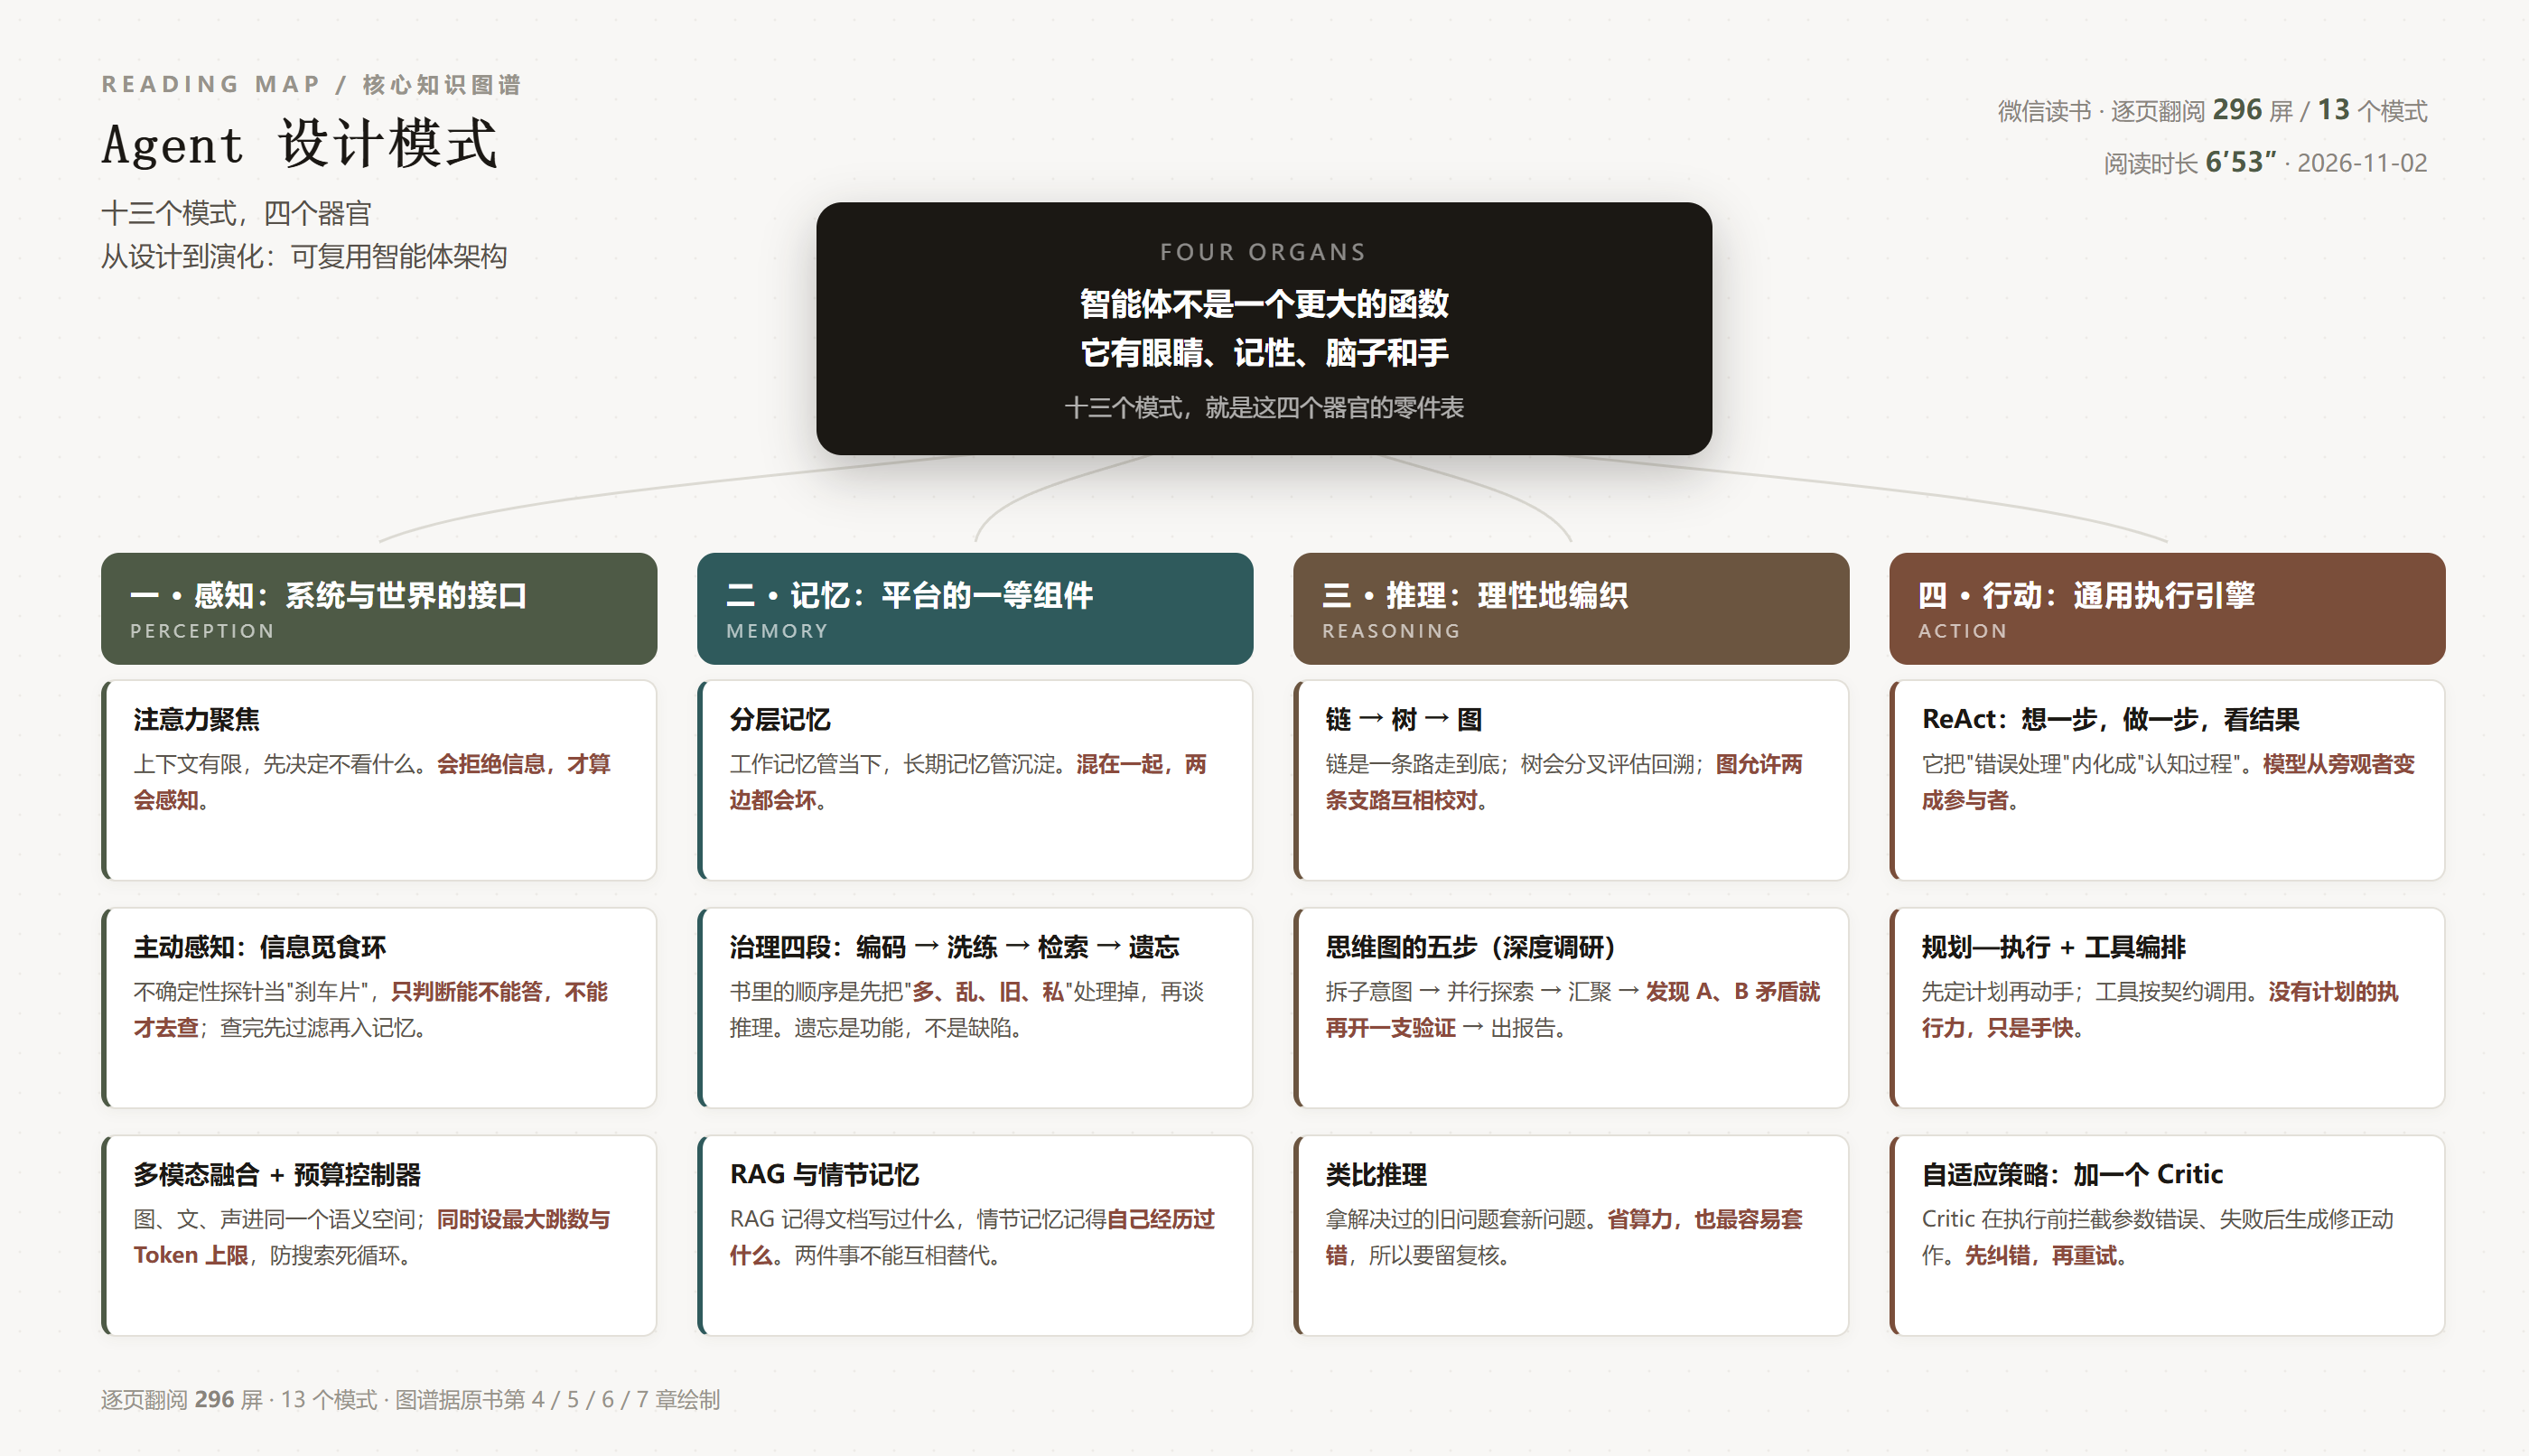
二、四个器官:13 个模式怎么分的
下篇的结构干净得让人舒服——四章,四个功能族:
感知(第 4 章):注意力聚焦、多模态融合、主动感知。记忆(第 5 章):分层记忆、RAG、情节记忆。推理(第 6 章):思维链、思维树、思维图、类比推理。行动(第 7 章):ReAct、规划—执行、工具编排、自适应策略。
翻译成一句人话:眼睛、记性、脑子、手。
这个分法最实用的地方在于,它能当排错表用。智能体答得不好,先别急着换模型,先问:是没看见(感知)、忘了(记忆)、想错(推理),还是做错(行动)? 四个器官对应四类病,四类病对应四组药。
下面挑三个我认为最有信息量的细节。
细节一:主动感知里那个"刹车片"
第 4 章讲主动感知的工程架构,给了四个组件。第一个叫不确定性探针(Uncertainty Probe),书里对它的定位写得特别准:
系统的"刹车片",不负责生成内容,只负责判断"能不能回答"。
大部分智能体是"先答,再露馅"。这个组件的思路是反过来:先判断自己会不会,不会才去查。
后面三个组件补上了剩下的环节——查询生成器把模糊的"知识缺口"翻译成具体的工具指令,书里的例子是:把"分析这家公司的财务风险"拆成 search_engine("2023财报") 加 code_interpreter("计算流动比率");信息过滤器把搜回来的噪声挡在记忆之外;预算控制器专门防一件事——
防止 Agent 陷入"搜索—失败—再搜索"的死循环,
必须设置最大跳数或 Token 消耗上限。
"工业级系统最容易忽视的组件"——这句评价我信。自己搭过就知道,一次跑飞的智能体烧掉的不是电,是钱。
细节二:记忆要治理,遗忘是功能
第 5 章说记忆正在变成"AI 应用基础设施",并给了一张表(表 5-1),把记忆治理拆成四段:编码、洗练、检索、遗忘。
书里那句话是整章的核心:只有将"多、乱、旧、私"的问题前置解决,才能为推理提供可靠的输入。
四个字,四个病:多(上下文塞满)、乱(结构混乱)、旧(过期信息)、私(隐私不能进库)。而"遗忘"被当成一个正式环节写进表里——这是我在这类书里少见的态度。多数教程只教你怎么存,不教你怎么删。
还有一个很实在的观察:企业里最大的痛点是"数据孤岛",客服 Agent 不知道代码助手 Agent 已经了解到的用户偏好。 所以记忆不该是每个 Agent 自己揣着的一份,而该是中间件——书里点了 Mem0 和 MaaS 这类做法。
细节三:思维图的第五步,才是它值钱的地方
推理那一章,链、树、图三个模式层层递进。真正把"图"和"树"区分开的,是书里给的深度调研例子,五步:
1. Branching:拆出 3 个子搜索意图
2. Exploration:各分支并行浏览网页,独立收集信息
3. Aggregation:汇总三个分支
4. Loop:发现"分支 A 与分支 B 的数据存在矛盾",触发一个新的"验证分支",专门核查该矛盾
5. Final:生成一份逻辑自洽的调研报告
前三步思维树也能做。第四步不行。
第四步的意思是:矛盾不是错误,是一条新的搜索指令。 两条支路打架,说明某处有事实没查清,于是专门开一支去查它。这就是 Perplexity、DeepSeek 那类深度调研背后真实的骨架——不是"想得更多",是"让想法互相校对"。
第 7 章的 ReAct 那节,有全书我认为写得最好的一段。标题叫"设计的哲学:认知的具身化":
模型从"缸中之脑"迈向"具身智能"。
在此之前,模型仅仅是旁观者;此后,模型成为参与者。
ReAct 模式是所有 Agent 的基本功能,它将"错误处理"内化为"认知过程"的一部分。
"错误处理内化为认知过程"——这句话把 ReAct 和"普通的函数调用"彻底分开了。函数出错要抛异常,Agent 出错要长记性。
三、它给的到底是结构,不是代码
这一点得提前说清楚,不然会失望。
13 个模式,每一个都给了"问题—结构—组件—适用场景",但没有给能直接跑的完整工程。 书里出现的图以流程图(图 4-8、图 6-13 这类)和表格(表 5-1)为主,代码是片段式的。
换句话说:它是一本"词汇表 + 装配图",不是一本"照着抄的食谱"。
这也决定了它该怎么读。不要按顺序读。 先跳到你要解决的那一章,找到对应的模式名,看看它拆成哪几个组件——然后回你自己的代码里,把缺的那个组件补上。
我用这个读法试了一次,很有效:把手上那个"搜不到就反复重试"的智能体,按第 4 章补了个预算控制器(最大跳数 + Token 上限),行为立刻从"偶尔跑飞"变成"稳定失败"——能稳定失败,才谈得上修。
四、这本书的短板
一是上篇太厚。 第 1 到 3 章占了近四成篇幅讲"为什么需要再发明",论述扎实但重复,想直接抄模式的人会觉得慢。
二是"图解"二字有点过。 书名带"图解",实际是以文字讲结构为主,图是流程图和表,不是那种一页一个示意画的图解书。
三是术语没统一。 Uncertainty Probe、Critic、Loop 这些词前后英中混用,对不熟英文术语的读者不友好,也没给统一的译名表。
四是模式之间没有"什么时候用哪个"的判据。 思维链、思维树、思维图都讲了,但没说清一个具体任务该选哪个、成本差多少。这部分得自己踩坑总结。
它的价值也因此很明确:它是这个领域里少有的、试图给混乱命名的书。 命名本身就是进步——你没法优化一个叫不出名字的东西。
五、一句话
设计模式从来不是教你写代码,是给你一套词。智能体这一代最缺的不是框架,恰恰是词。 说不清"这块该归记忆还是归推理",就只能一遍遍重写;说得出"我这里缺一个预算控制器",问题就已经解了一半。这本书 296 屏,最大的用处不是那 13 个模式,是让你在讨论自己的智能体时,有话可说。
阅读记录:微信读书网页版逐页翻阅,296 屏 / 6 分 53 秒,4 章 / 13 个模式。
本书知识图谱见文中配图,原图地址:https://www.jiangtian.top/zb_users/upload/kg/agent-design-patterns-map.png
发表评论: