
三个AI干活,是吵架、流水线,还是开公司
阅读方式:微信读书网页版,从版权页翻到第 16 章末,共 766 屏、16 章、15 分 06 秒。 十六章:基础、感知、记忆、知识、情感、推理、工具、多智能体协同、开发流程、参考架构、设计模式、深度研究、数据分析、数据科学、决策优化、机器视觉。
这本书的目录,是我读的这一批书里最有条理的一份。
第 2 到第 8 章,一章一个能力:感知、记忆、知识、情感、推理、工具、协同。
七章排下来,等于给"智能体该会什么"列了一张清单。
而清单里有一项,让我停了一下——第 5 章,情感能力。
一、七种能力,一章一个
前六项的分工很清楚:
感知——看得见。文字、图像、语音,先得进得来。
记忆——记得住。上下文、历史、用户偏好。
知识——查得到。外挂知识库,不靠模型自己背。
推理——想得清。下一步做什么。
工具——动得了手。真的去调接口、跑脚本。
这五项,任何一本讲智能体的书都会讲。真正少见的是"情感"这一章的存在。
我读过的技术书里,绝大多数会把"情绪"归到"话术"或"语气"里去写,不单独设一章。这本书把它当成一种能力来对待,等于承认了一件事:很多智能体的成败,不在它对不对,在它让人舒不舒服。
这个判断我觉得是对的。客服、陪伴、教育、医疗问诊——这些场景里,答案正确只是及格线,语气和分寸才决定用户还用不用第二次。
二、三个 AI 怎么分工:吵架、流水线、还是开公司
第 8 章讲多智能体协同,把主流框架分成三种组织方式。这一段是全书信息密度最高的地方,我几乎逐条抄了下来。
第一种:辩论会 —— AutoGen
支持多样化的会话模式,如"双人辩论"或"圆桌会议",这种对抗性或协作性的交互能够有效消除单体模型的认知幻觉。开发者通过"对话编程"(Conversation Programming)定义智能体之间的交互行为。
关键在"有效消除认知幻觉"这七个字。它的思路不是让一个模型更聪明,是让两个模型对着干——你说东,我说西,谁站不住脚谁就输了。
第二种:流水线 —— MetaGPT
将人类的标准作业程序(SOP)固化为智能体的协作流程。核心理念 Code=SOP(Team),强调将复杂任务拆解为产品经理、架构师、工程师等角色的原子化推理步骤。通过强制执行标准化的输出接口(如 PRD 文档、API 接口定义),实现推理过程的流水线化……并通过角色间的相互校验(Cross-check),构建了工程层面的逻辑纠错机制。
这个理念的名字起得很妙:Code = SOP(Team)。
意思是——你不需要发明一套"AI 团队"的新规矩,直接把人公司里那套流程搬过来就行。 产品经理写 PRD,架构师出接口定义,工程师照着实现。谁交给谁什么东西,全是现成的。
而"强制执行标准化输出接口"这一句,是它能跑通的原因:每一棒交接的东西格式是定死的,下一棒才接得住。
第三种:开公司 —— CrewAI
引入层级化(Hierarchical)和顺序化(Sequential)的流程管理。通过 Crew(团队)与 Flow(流)的结合,定义明确的汇报关系和任务委派逻辑。在这种模式下,高级智能体(Manager Agent)负责分解与质量审核,执行智能体专注于具体任务。
这一种最像真实的组织:有 Manager,有执行者,有汇报线。
它的好处是可管——你能看出哪一步卡住了,哪个角色在摸鱼。代价是多了一层,也就多了一次失真。
三种方式,我用一句话概括:
AutoGen 让它们吵,MetaGPT 让它们排队交活,CrewAI 让它们上下级汇报。
三、拆开之后,好在哪
三种方式各不相同,但它们解决的是同一个毛病:单个模型自己检查自己,是查不出错的。
你让它写完再"检查一遍",它往往会说"检查过了,没问题"——因为它是用同一套判断标准在检查同一套输出。它的盲区和它的错误是同一个来源。
而拆成多个角色之后,最起码发生了一件事:检查的人和写的人不是同一个。
MetaGPT 那句"角色间的相互校验(Cross-check),构建了工程层面的逻辑纠错机制",说的就是这个。它把质检从"自己再看一眼"变成了"别人来挑刺"。
这也是我在别处看到的一个规律:AI 最难的是发现自己错了,最容易的是发现别人错了。 多智能体之所以有用,不是因为"人多力量大",是因为它给模型创造了一个"别人"。
不过这里有一个前提,书里也点到了:分工的依据是接口。
MetaGPT 能跑,靠的是 PRD、API 定义这些强制格式。如果每一棒的交付物格式不定死,拆得越多越乱——你得到的不是团队,是三个各说各话的人。
四、五个现成智能体
第 12 到 16 章,给了五类具体的智能体:深度研究、数据分析、数据科学、决策优化、机器视觉。
这五类选得挺准,它们有个共同点:都是"过程比答案重要"的活。
深度研究要能说清资料从哪来;数据分析要能复现每一步;数据科学要能交代建模选择;决策优化要能摆出约束条件。这几类工作里,只给结论不给过程,等于没做。
而机器视觉是另一路——它把"看见"直接变成动作,最接近"具身"的那一端。
五、这本书的短板
一是能力分章有重复。 记忆、知识、感知三章有大量交叉,"记住一段对话"和"从知识库检索"在实现上高度重合,分成三章反而让人分不清边界。
二是框架部分绑版本。 AutoGen、MetaGPT、CrewAI 的接口都在快速变,书里给的代码示例过一阵就跑不通。
三是五个应用停在"结构说明"。 每章都讲了这类智能体由哪些模块组成,但很少给一条能跑通的完整链路。读完你知道它分几层,但还是不知道第一步该写什么。
它的优点是:它把"能力"当成组织全书的骨架。 这个选择比按技术栈分章聪明——因为技术栈三年一换,而"一个智能体得会什么"这个问题,是相对稳定的。
六、一句话
这本书讲了很多技术,但最值得带走的是那个观察:单个模型查不出自己的错,因为它用同一套标准检查同一套输出。 所以多智能体的真正价值不是"人多好办事",是给模型造一个"别人"——一个会挑刺、会追问、会拿不同标准来量它的角色。至于用吵架、用流水线、还是用上下级,反倒次要:先想清楚每一棒交什么东西,再决定要不要拆。
阅读记录:微信读书网页版逐页翻阅,766 屏 / 16 章 / 15 分 06 秒。
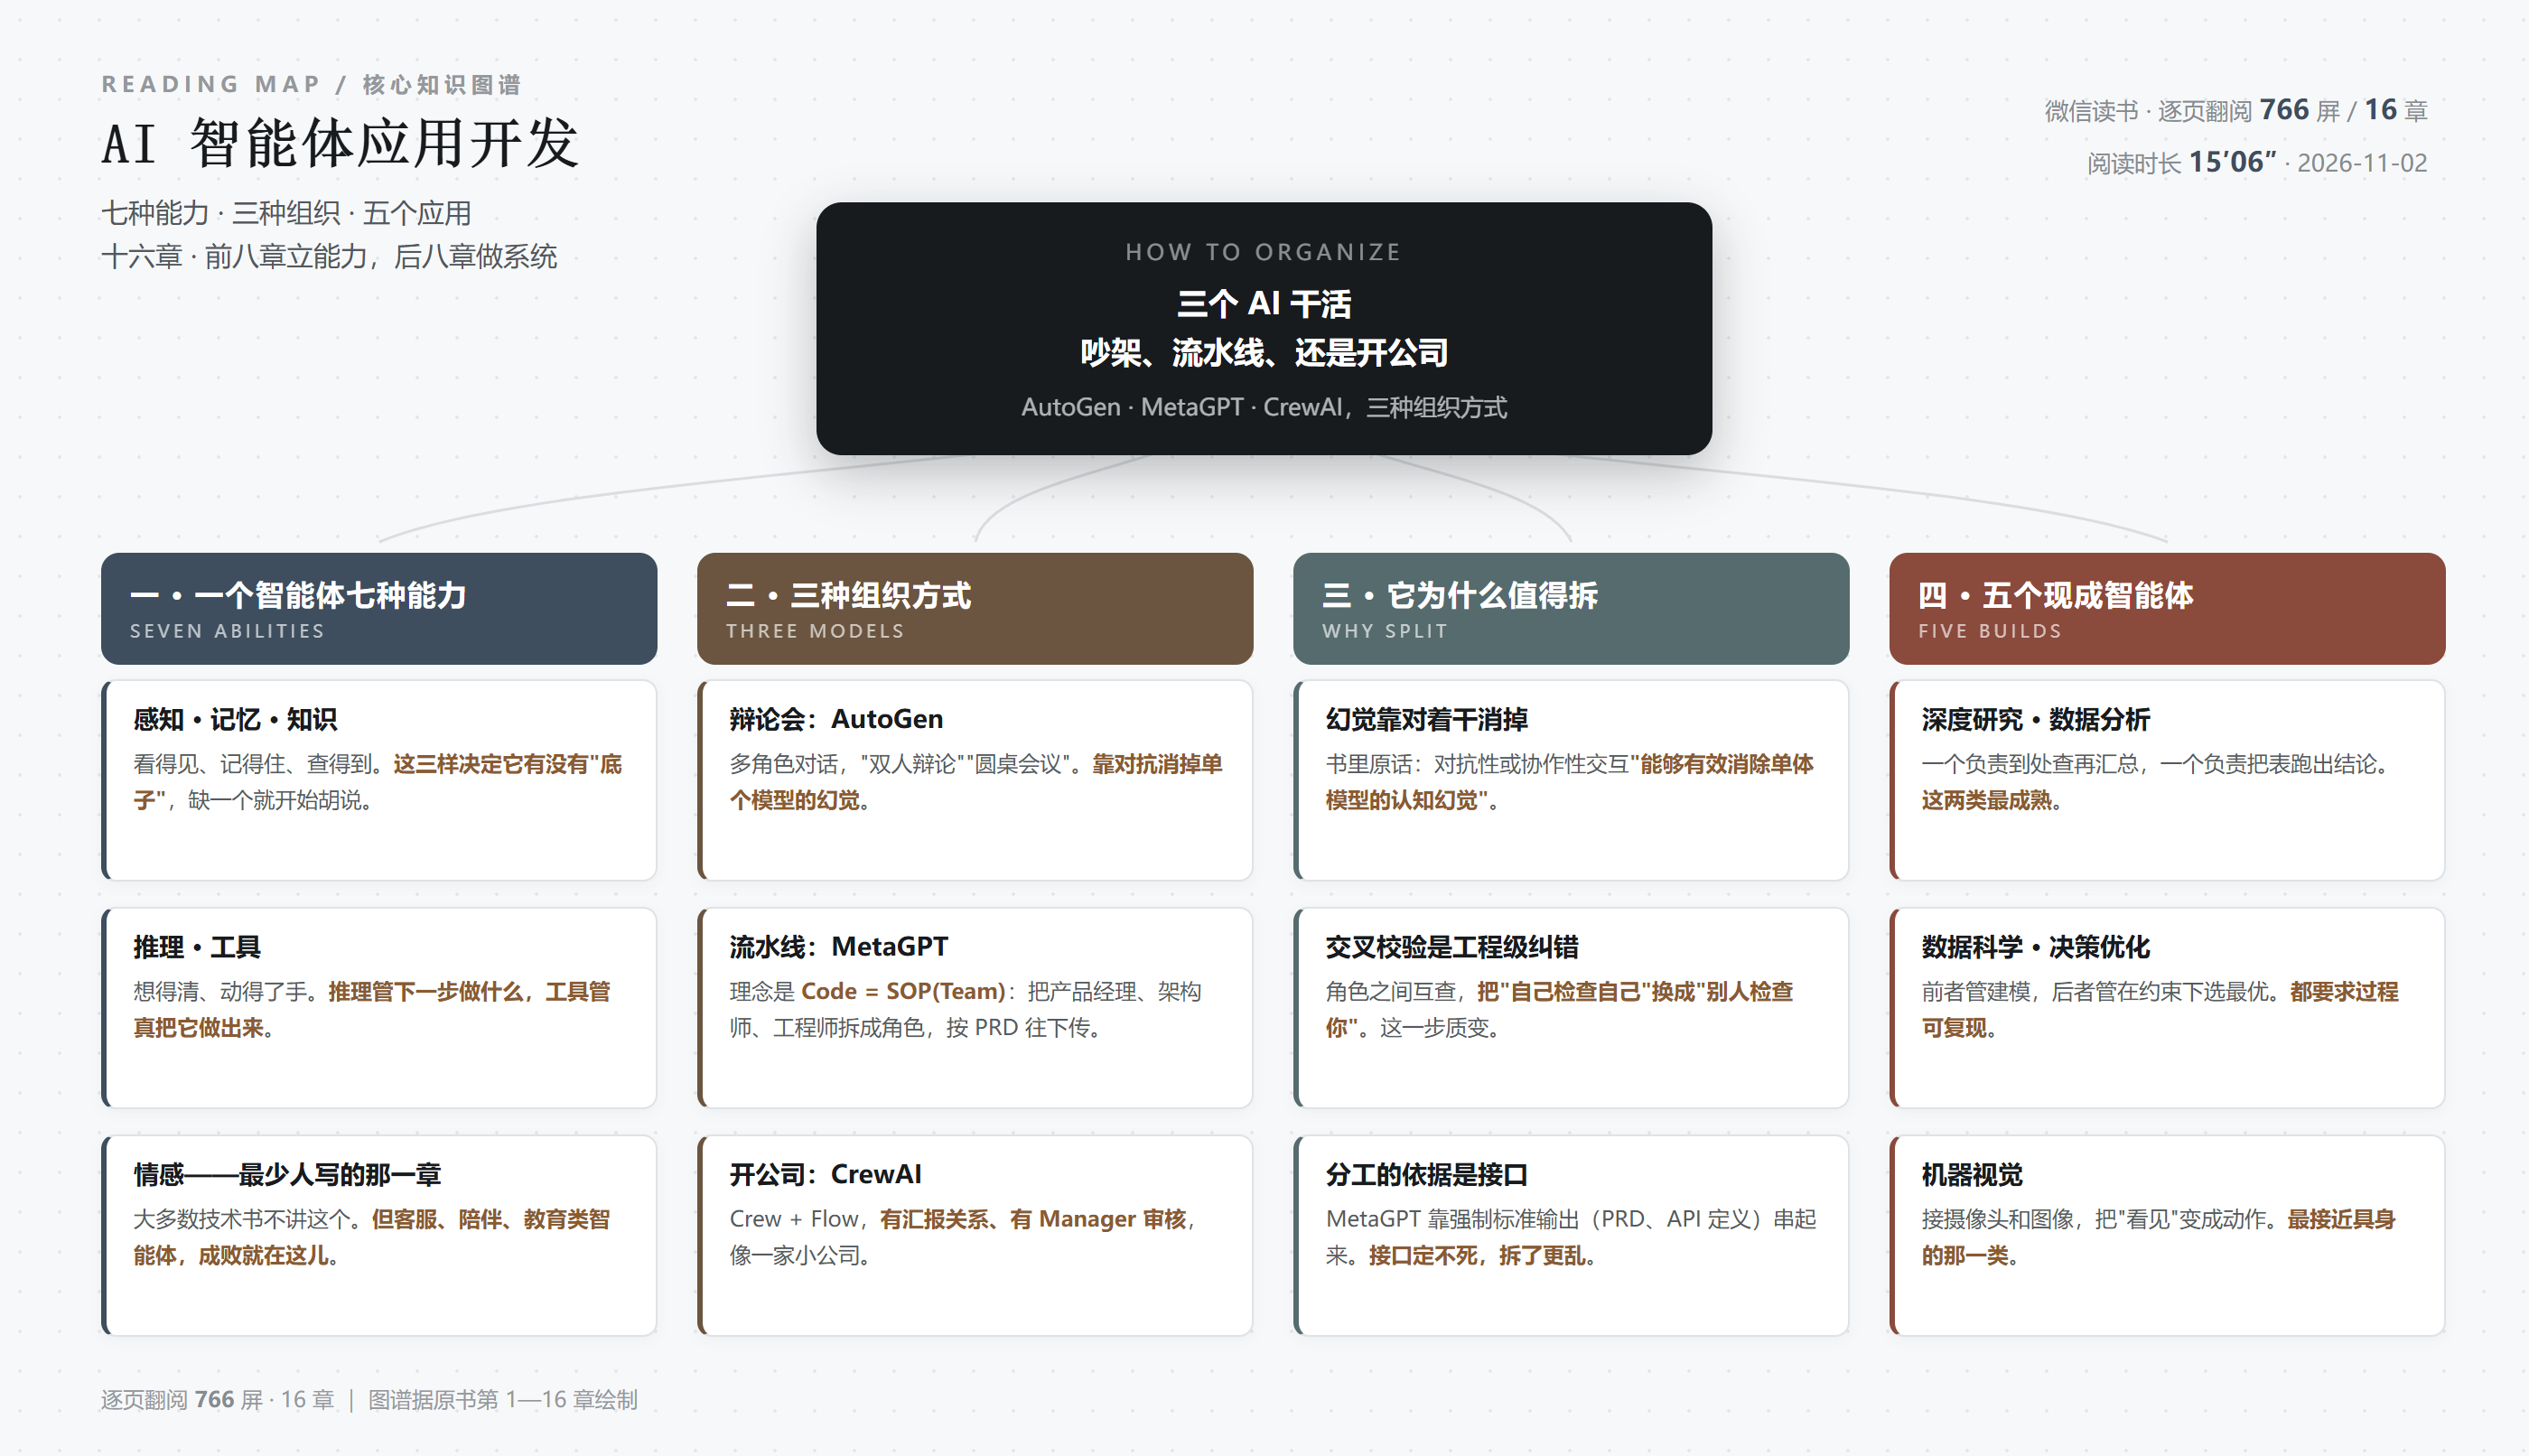
本书知识图谱见文中配图,原图地址:https://www.jiangtian.top/zb_users/upload/kg/agent-seven-abilities-map.png
发表评论: