
大脑、手脚、记性,缺一样都不算智能体
阅读方式:微信读书网页版,从版权页翻到第 14 章末,共 571 屏、14 章、11 分 37 秒。 十四章:重新定义助手、大脑、感知与记忆、规划与决策、行动与工具、开发路径、LangChain、低代码、知识库、工作流、多智能体、评估、商业化、具身与 AGI。
这是我读过的智能体书里,结构最像"教科书"的一本。
它不急着教你搭东西,先用五章讲清楚一件事:一个智能体由哪几个部分构成。
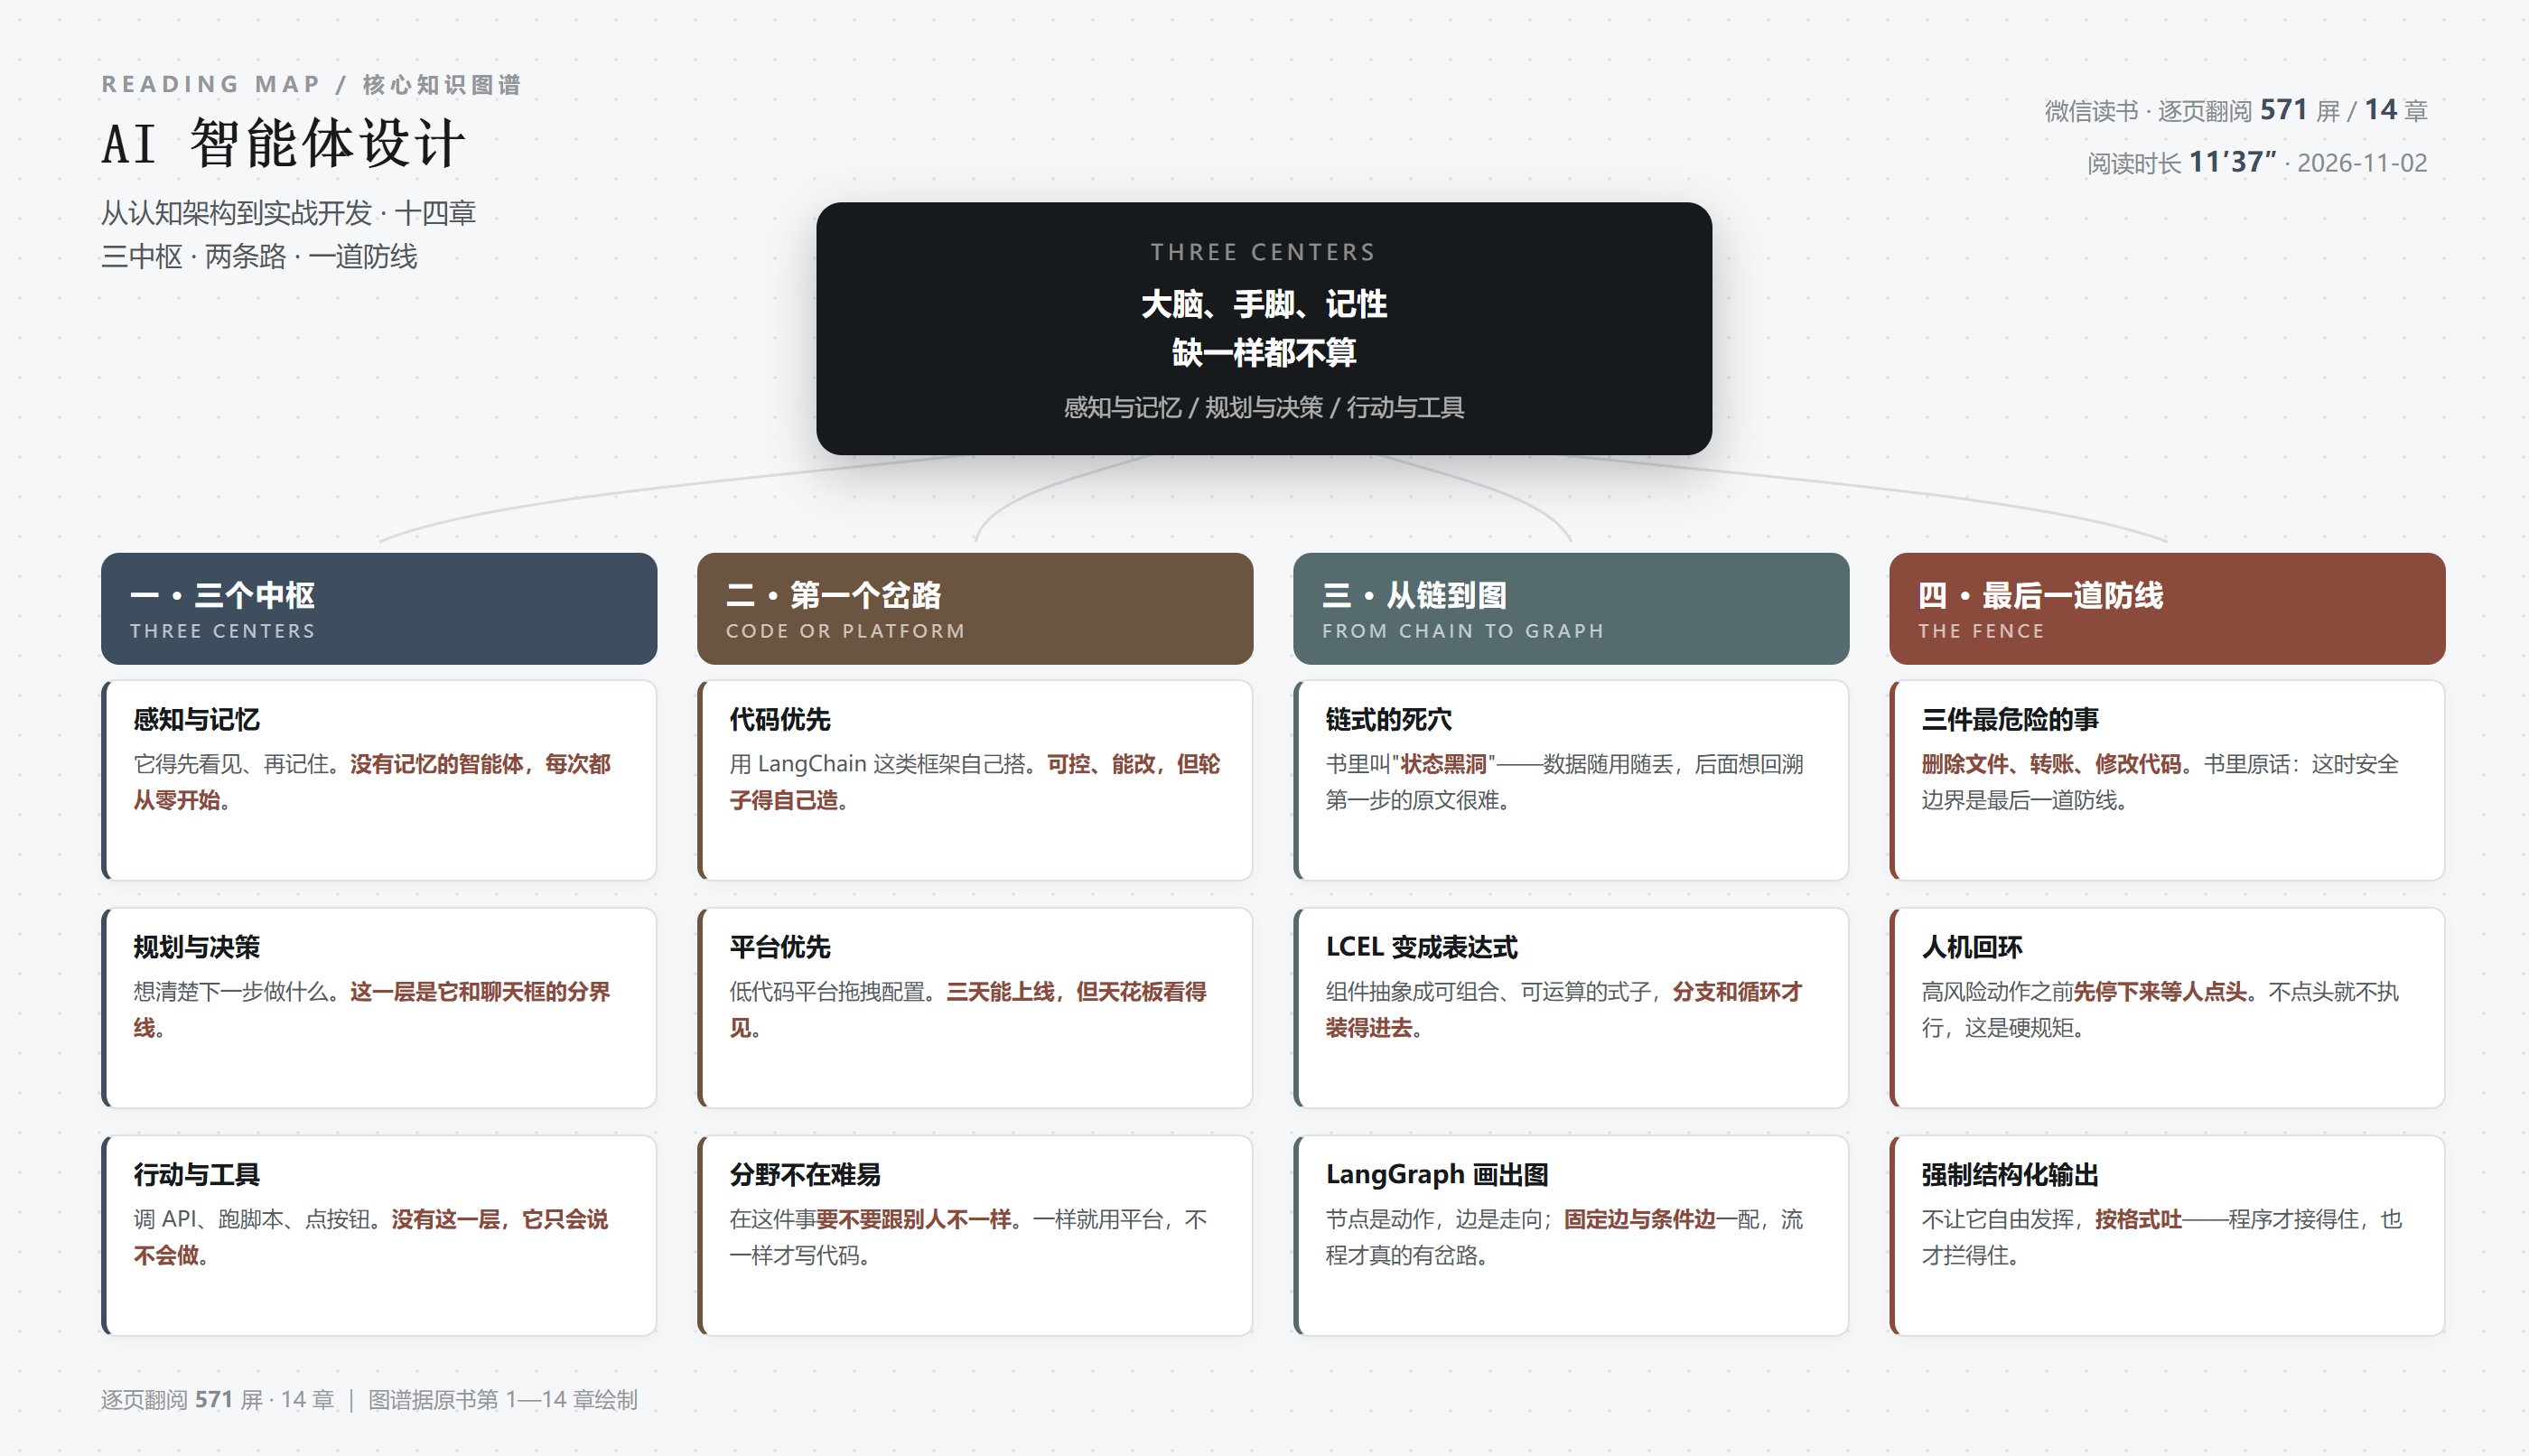
答案分三块:感知与记忆、规划与决策、行动与工具。
用大白话说:记性、大脑、手脚。
一、三个中枢,缺一个都不成立
这三块的分工,书里说得很清楚:
感知与记忆——先看见,再记住。这一块决定了它有没有"上下文"。没有记忆的智能体,每次对话都在从零开始,你昨天教过它的事,今天还得再说一遍。
规划与决策——想清楚下一步做什么。这一块是和聊天框真正的分界线:聊天框等你给下一步,智能体自己给下一步。
行动与工具——调 API、跑脚本、点按钮。没有这一层,它只是一个说得很好听的顾问。
书里第 1 章的标题是"重新定义'助手':从软件工具到智能实体"。这个"实体"二字用得很准:工具是被用的,实体是能自己往下走的。
二、第一个岔路:代码还是平台
第 6 章讲"开发路径的分野",我认为是全书最实用的一章。
它把路分成两条:
代码优先——用 LangChain 这类框架自己搭。书里第 7 章专门讲这条路,还配了"复杂系统的深度治理"这样的副题。
平台优先——低代码平台上拖拽配置。第 8 章的副题是"低代码生态下的敏捷生产力"。
两条路的取舍,书里没给标准答案,但给了个判断方向,我总结成一句:
分野不在难易,在"这件事要不要跟别人不一样"。
一样的事,用平台;要不一样,才写代码。
为什么?因为平台给你的是一套已经定好的抽象。它替你省掉了所有底层功夫,代价是你的天花板就是它的天花板。 而如果你要做的事恰恰是"别人没做过的",那平台里根本没有这个按钮。
三、链式的病,和它怎么被治好的
第 7 章讲 LangChain 的演进,有一段我读得很过瘾,因为它承认了框架自己的问题。
早期的 LangChain 是"链式"编排:一步接一步,像流水线。书里列了它的三个毛病,其中第三个被起了个很形象的名字——"状态黑洞":
线性流转意味着数据"随用随丢"。如果后续环节需要调用第一步的原始输入,在无状态的线性链条中往往很难回溯。
这句话点到了要害。线性流程最大的问题是它记不住中间过程。 你在第三步发现结果不对,想回头看看第一步喂进去的原文——没了。
然后是两次改版:
第一次,LCEL。 把组件抽象成可组合、可运算的"表达式",变成"用运算符把组件串起来"的写法。这样分支、循环、状态管理才装得进去。
第二次,LangGraph。 干脆不装成一条链了,改成画图:
节点(Node)是动作,边(Edge)是走向。边又分两种——固定边(A 完了必到 B)和条件边(看情况,可能去 B 也可能去 C)。
书里对边有个说法我很喜欢:"边是流程的指挥官"。
因为它决定了一件事:这个系统会不会拐弯。
只会直走的,是脚本;会拐弯的,才叫智能体。
四、最后一道防线
第 5.5 节的开头,是我在整本书里划得最重的一段:
"现在,最关键的问题来了:当智能体具备了'删除文件''转账''修改代码'等高风险能力时,安全边界就成了智能体落地的最后一道防线。"
这句话的分量在于,它举的三个例子都是不可撤销的。
说错一句话,改回来就行;删错一个目录、转错一笔账、改错一行生产代码,可能就回不去了。
书里给的解法有三个层次:
格式规制——强制结构化输出,不让它自由发挥。这一步看着是技术细节,其实是安全设计:输出格式定死了,程序才能校验;能校验,才拦得住。
人机回环——高风险动作之前先停下来等人确认。
安全护栏——把绝对不能做的事写死在系统提示里,当成硬约束。
这三条,恰好和我这段时间读的另外几本书接上了:写提示词时最管用的是"不许";搭工作流时最要紧的是"规范层";设计智能体时最后一道防线是"安全边界"。
三本书,三个说法,一件事:能拦住它,比它能干多少更重要。
五、这本书里写了 OpenClaw,而且写得挺准
第 7 章讲代码优先路径时,作者腾出一整节讲 OpenClaw 的工程架构。这一点让我意外——一本 2025 年的教材,能把一个还在一线迭代的开源框架拆得这么细,说明作者是真读过代码。
他讲了两个设计,我认为是这本书里最有价值的技术观察:
第一,纯文件式的记忆引擎。
它摒弃了需要额外部署、占用重系统资源的向量数据库,转而将记忆和技能直接挂载为轻量级的本地 Markdown 或 JSON 文件。
SOUL.md(灵魂文件):相当于系统提示词,定义人格、行事风格与不可逾越的安全护栏;
SKILL.md(技能字典):定义可调用的本地原子化工具库;
MEMORY.md(动态记忆):沉淀的历史上下文与关键执行结果。
书里对这套设计的评价是:"一切皆文件"——既保证了数据隐私,降低了本地调用延迟,还允许开发者像修改普通文本一样,随时手动干预智能体的认知状态。
最后半句是关键。向量库里的记忆,你只能"检索"它,改不了它;而 Markdown 里的记忆,你能打开看一眼,然后亲手改掉。
对一个要长期跑在自己机器上的智能体来说,这个差别比"检索精度"重要得多——因为你要能审计它,才敢让它干活。
第二,高权执行层与容错闭环。
书里说它抛弃了传统的 API 封装网关,执行层直接与操作系统对话,大脑下达指令后由终端完成操作。更关键的是这个:
当本地代码运行报错时,执行层不会直接宕机,而是将终端的报错日志作为新的上下文输入给大模型,驱动智能体自主修改代码、重新安装环境依赖并再次测试,形成"编写→测试→修复"的自治生命周期。
这段话描述的是一个闭环:报错不是终点,是下一轮的输入。
我觉得这是"智能体"三个字最实在的一种解释。不是它能陪你聊天,是它失败了会自己再来一次。
六、这本书的短板
一是框架版本绑得紧。 第 7、8 章大量讲具体 API 和界面操作,LangChain 的接口换一次版本,这两章就要重写。 而它恰恰是全书篇幅最大的部分。
二是后六章偏"应该做",不偏"怎么做"。 知识库、工作流、多智能体、评估、商业化,每章都在讲"要重视""要建立体系",但很少给一个能照着做的流程。 相比之下,第 7 章讲 LangGraph 节点怎么加,就实在得多。
三是评估那章太轻。 智能体最难的技术问题其实是"怎么判断它这次做得对不对",这一章只有几屏,停在"要建立评估指标"的层面,没给指标长什么样。
它的优点是:它有骨架。 三个中枢这个框架,从头贯到尾,讲开发路径时用它、讲多智能体时用它、讲评估时还在用它。读完你能记住结构,而不是记住一堆名词。
七、一句话
这本书教了很多搭智能体的技术,但最该记住的是它那句提醒:当它能删文件、能转账、能改代码的时候,问题就不再是"它有多聪明",而是"你拦不拦得住"。 所以我们花在提示词上的功夫,最后都要落回到三样东西上——说清要什么、写死不许什么、危险动作等人点头。 前两样决定它做得好不好,第三样决定你敢不敢用它。
阅读记录:微信读书网页版逐页翻阅,571 屏 / 14 章 / 11 分 37 秒。
本书知识图谱见文中配图,原图地址:https://www.jiangtian.top/zb_users/upload/kg/agent-three-centers-map.png
发表评论: