
内功省显存,外拓长眼睛
阅读方式:微信读书网页版,从版权页翻到第 15 章末,共 646 屏、15 章、14 分整。 十五章:注意力与多模态总论、PyTorch 环境、注意力基础/进阶/高级/调优、九个实战项目。
这是我这批书里技术含量最高的一本,也是最难写笔记的一本。
因为它大半是代码和公式,而我要写的是给不看代码的人看的东西。
但它有一个框架,我觉得普通人也能用上——作者自己在第 1 章就摆出来了:
1.2 大模型的内功:高性能注意力机制的崛起
1.3 大模型的外拓:多模态融合
内功、外拓。 四个字把整本书说完了,也说清了这两年大模型在拼什么。
一、先说清"贵"在哪
要理解内功,得先知道钱花在哪。
大家通常以为大模型贵在算。其实推理的时候,更贵的是记。
它每蹦出一个字,都要回头把前面所有字重新看一遍。为了不每次重算,工程上就把前面那些字的中间结果存下来,这就是 KV 缓存。
问题是:这个缓存的大小,跟"上下文长度"成正比。你给它十万字的材料,它就要为这十万字留一份缓存。
所以长上下文不是免费的。上下文翻一倍,显存差不多也要翻一倍。这就是为什么"支持百万上下文"这句话,背后是硬件的账单。
于是所有省钱的努力,都指向同一个地方:把这份缓存压小。
二、GQA 和 MLA:两种省法
书里第 1.2.3 节讲这件事,我把它那段几乎原样抄下来了:
GQA(Group Query Attention,分组查询注意力)以其共享键和值矩阵的创新设计,显著减少了显存占用,提升了推理速度……尤其适合处理长序列输入和大规模模型。
MLA(Multi-Head Latent Attention,多头潜在注意力)则通过低秩压缩技术(可以理解为将高维矩阵压缩为若干低维矩阵的乘积),进一步降低了 KV 缓存的需求。
两种省法,思路完全不同:
GQA 是"少存几份"。 原来每个注意力头都各存一套 K/V,现在让几个头共用一套。头分组,存储除以组数。 代价是精度略损,但实测损得很少。
MLA 是"压小一点"。 它不存原始的高维 K/V,而是先压成一个低维的"潜向量"存起来,用的时候再还原。存的是压缩包,不是原件。
用生活里的话说:GQA 是几个人合租一套房,MLA 是把行李抽真空再装箱。
而这两个东西凑在一起,就是 DeepSeek 能在便宜硬件上跑出好效果的关键之一。它不是把模型做得更聪明,是把同样的聪明做得更省。
这句话我认为是这本书最该被记住的判断——过去两年大模型的进步,一大半不是"更会想",是"更会省"。
三、外拓:三种接法
第 1.3.2 节讲多模态融合,给了三种基本策略:
早期融合(Early Fusion),也叫特征级融合——在模型早期就把不同模态的数据特征连接在一起,输入一个联合模型。书里说它的优点是"可以捕捉不同模态间的低级关联信息"。
晚期融合(Decision-level Fusion)——各模态各算各的,最后在决策层合并。
混合融合(Hybrid Fusion)——两头都用。
这个分类很干净,而且它解释了一个常见困惑:为什么同样是"多模态",不同产品的表现差别那么大?
因为融合得越早,模型对"图和文之间的关系"理解得越深,但训练也越难、越贵;融合得越晚,越容易拼起来,但模型其实是在"各看各的",谈不上真正理解。
这也是为什么早期那批"多模态"产品,本质是"一个看图模型 + 一个语言模型"接起来——晚期融合,便宜,但也浅。
四、六章讲注意力,值不值
全书十五章,第 3 到第 6 章全在讲注意力,分基础、进阶、高级、调优四层。
这个比例在一本实战书里是很少见的。大部分书会花两页把注意力带过,然后赶紧进项目。
这本书反过来:先把自注意力怎么算、多头怎么拼、LayerNorm 放哪、TransformerBlock 怎么搭,一行行写出来跑通,再谈别的。
值不值?取决于你是谁。
如果你只是想调 API 做个应用,这六章是负担——它们不会让你的产品好一分钱。
但如果你想弄清"为什么长上下文贵""为什么换 GQA 就快了""为什么我的模型显存爆了",这六章是唯一能给你答案的地方。因为这些问题都不在应用层,在注意力层。
五、九个实战,覆盖面很野
第 7 到 15 章是九个项目,选题挺出人意料:
旅游特种兵迪士尼大作战(API 调用与高精准路径优化)、广告文案撰写(多模态本地化部署与微调)、Diffusion 可控图像生成、多模态图文理解与问答、交叉注意力语音转换、多模态特征 token 压缩、图像编码器与图形重建、端到端视频分类、跨平台智能客服。
这里面有三个是"融合范式",作者特意标了号:范式 1 是 Diffusion 可控生成,范式 2 是图文问答,范式 3 是语音转换。一个范式一章,各讲透一路。
而第 12 章那个"token 压缩",我觉得是全书最容易被低估的一章。
因为多模态真正的瓶颈不在模型能力,在带宽:一张图切成几百个 token,一段视频切几万个。上下文窗口就那么大,你把位置全让给图片了,文字就没地方放。
所以谁能把图像压成更少的 token 而不丢信息,谁就能在同样的窗口里塞进更多内容。这是工程问题,不是算法炫技。
六、这本书的短板
一是环境搭建那章太长。 第 2 章讲装 Miniconda、装 PyCharm、选显卡驱动版本、装 PyTorch——整整一章。这类内容在书里注定会过期,而且网上教程一搜一大把,占这个篇幅不值。
二是技术论述偏综述。 讲"大模型的涌现""发展历程""未来展望"这些段落,措辞像论文引言,信息密度低,且没有出处。真正硬的部分只在代码和少数几个小节里。
三是实战项目绑死了特定条件。 有的依赖 DeepSeek 的 API,有的要求本地有可用显卡。读者硬件不够,一半项目跑不起来——这是这类书的老问题,作者也没给降级方案。
它的优点是:它真的把注意力讲透了。 大多数讲大模型的书,注意力是当成背景知识一笔带过的;这本把它当成主角,讲了六章,还配了能跑的代码。在这个层面上,它比很多"大模型原理"的书扎实。
七、一句话
读完这本书,我对"大模型进步"这件事的理解变了一点:它不是一年比一年更聪明,是一年比一年更会算账。 GQA 少存几份、MLA 压小一点、token 压缩少占点位置——这些都不是让模型多想,是让它少花。所以下次看到"性能提升 X 倍"的宣传,先问一句:是模型变强了,还是它把账算明白了?
阅读记录:微信读书网页版逐页翻阅,646 屏 / 15 章 / 14 分整。
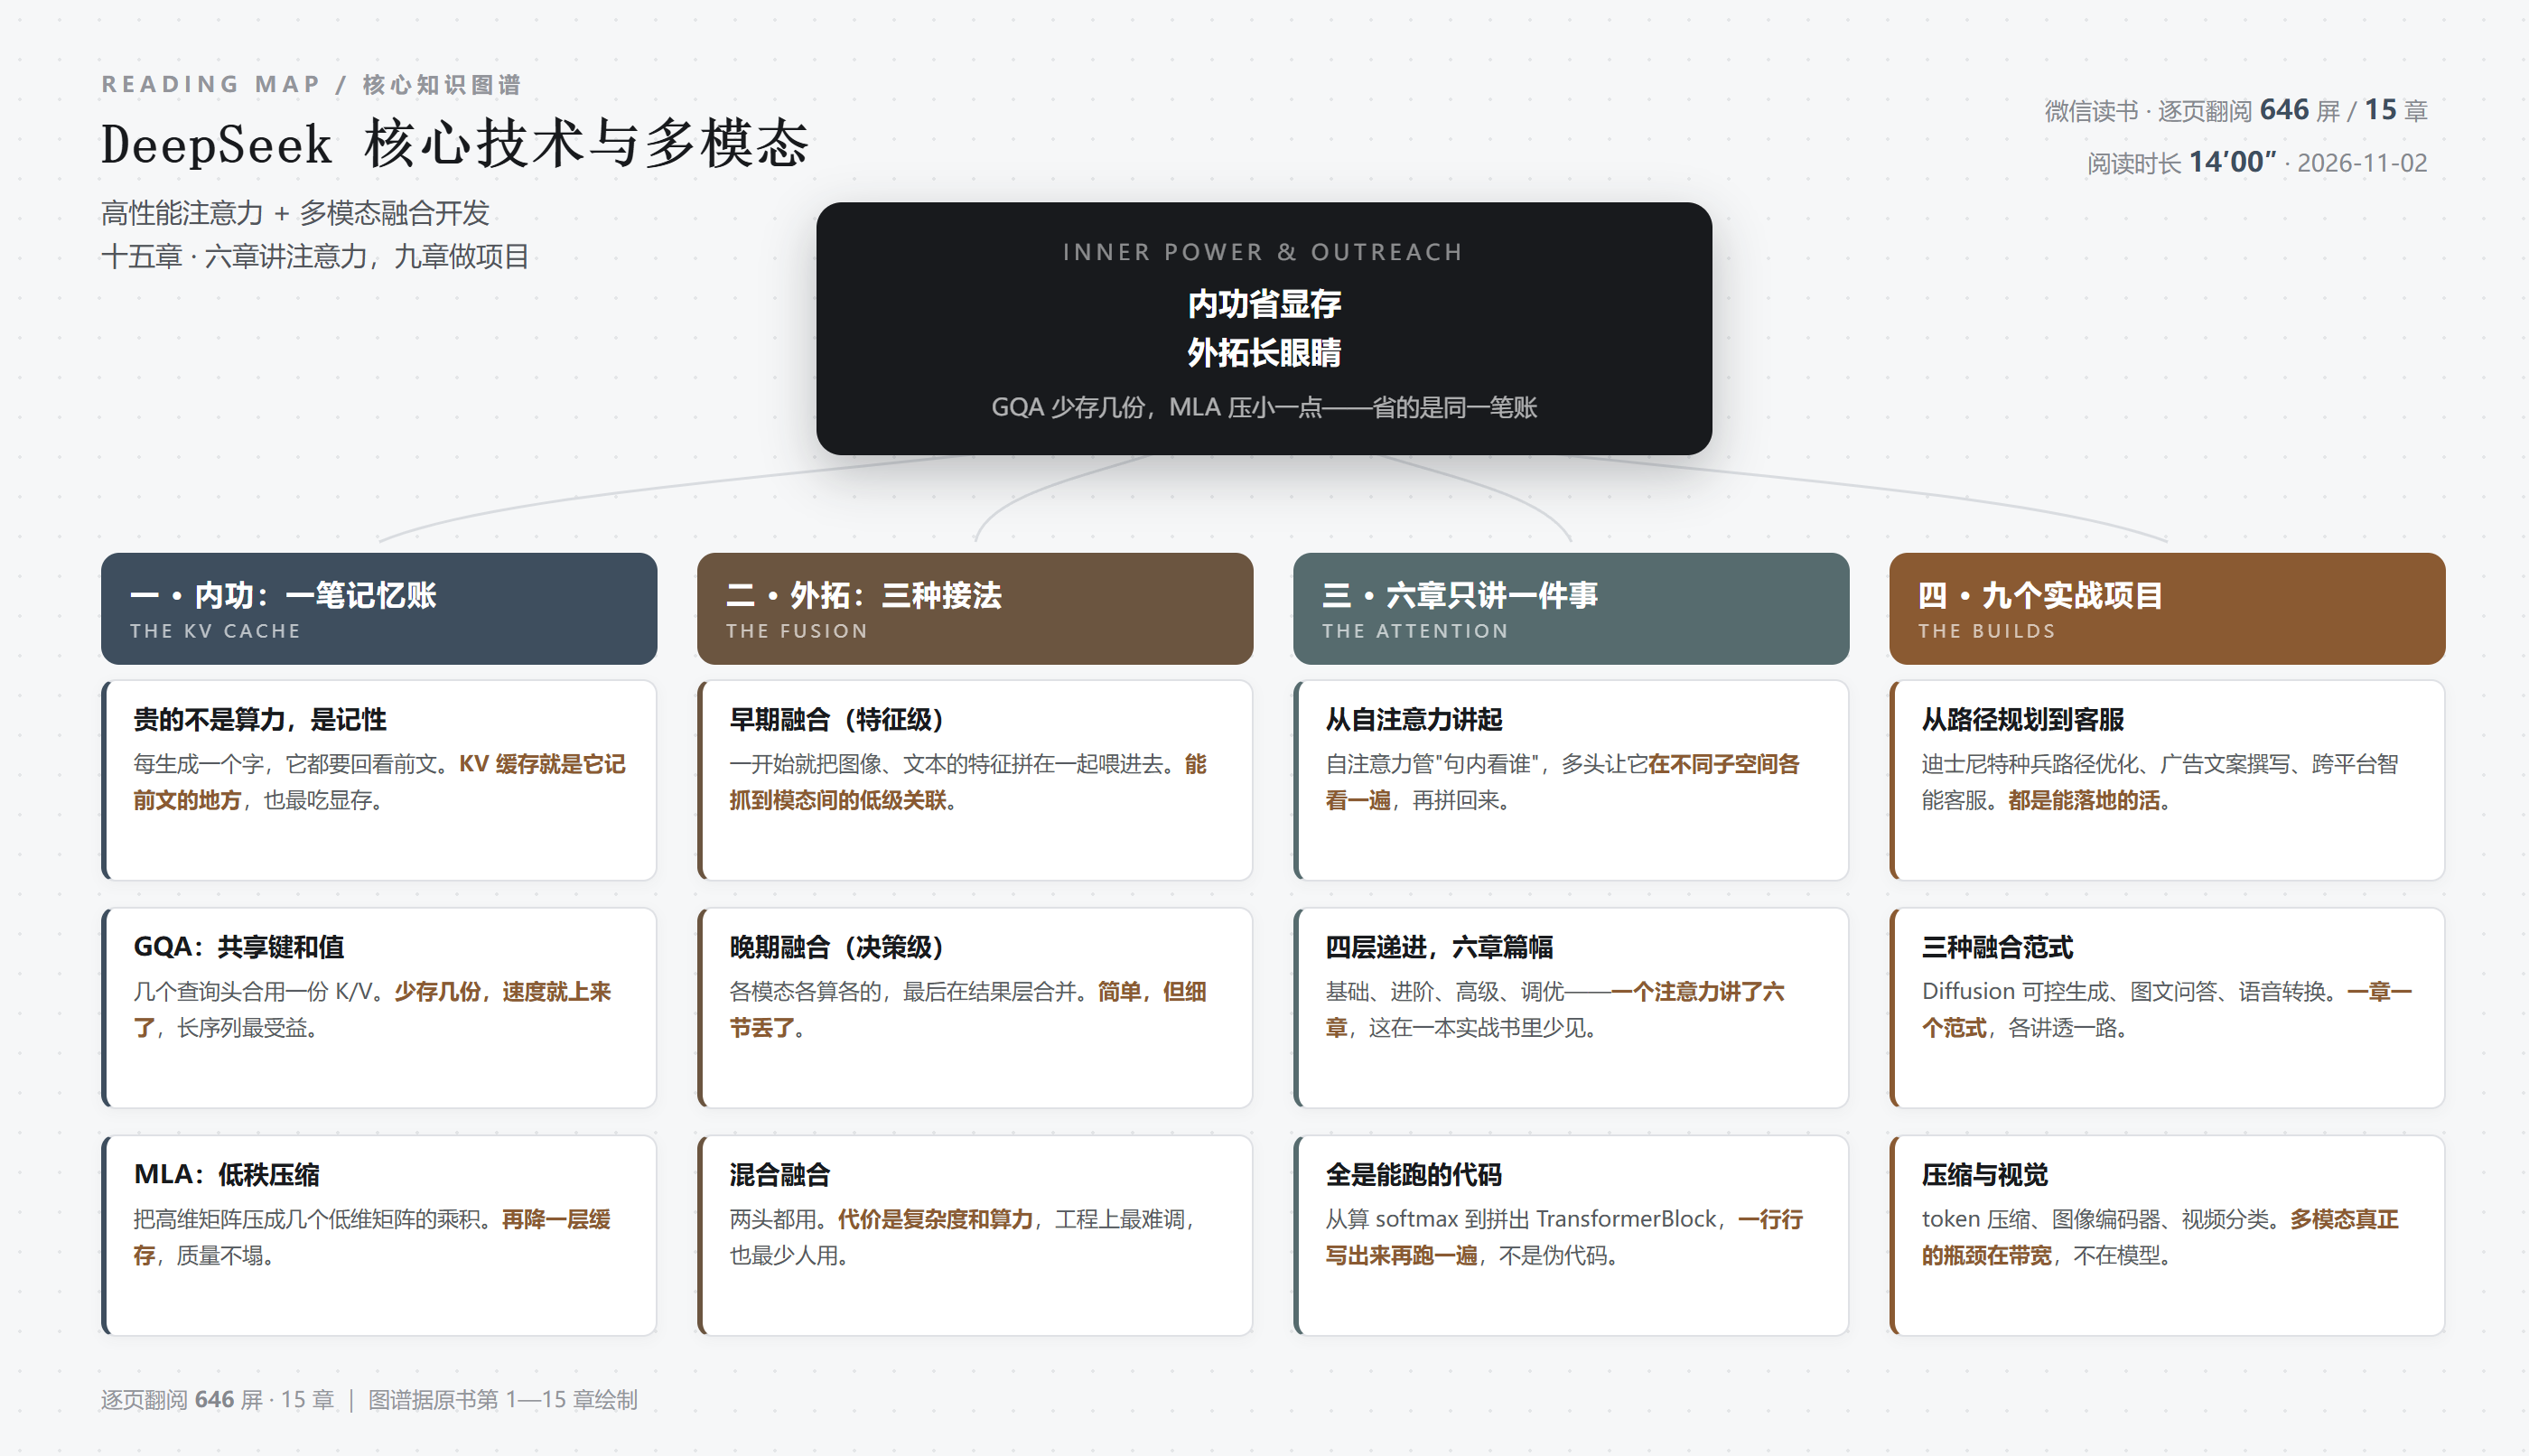
本书知识图谱见文中配图,原图地址:https://www.jiangtian.top/zb_users/upload/kg/deepseek-inner-outer-map.png
发表评论: