
整本书只做一次搬家:把语言搬进坐标系
阅读方式:微信读书网页版,从版权页翻到附录与后记,共 687 屏、12 章、14 分 29 秒。 三部分:理解语言模型(词元、嵌入、内部机制)/使用预训练模型(分类、聚类、提示工程、生成、RAG、多模态)/训练与微调(嵌入、分类、生成)。
这是一本 O'Reilly 的译本,作者是 Jay Alammar 和 Maarten Grootendorst。前者画的那套"图解 Transformer"图,很多人应该都见过。
所以这本书的写法可以预期:每一步都配上图,把数据形状画出来。 从"一句话"到"一串 token id",再到"一个 768 维向量",每一步长什么样,都摆给你看。
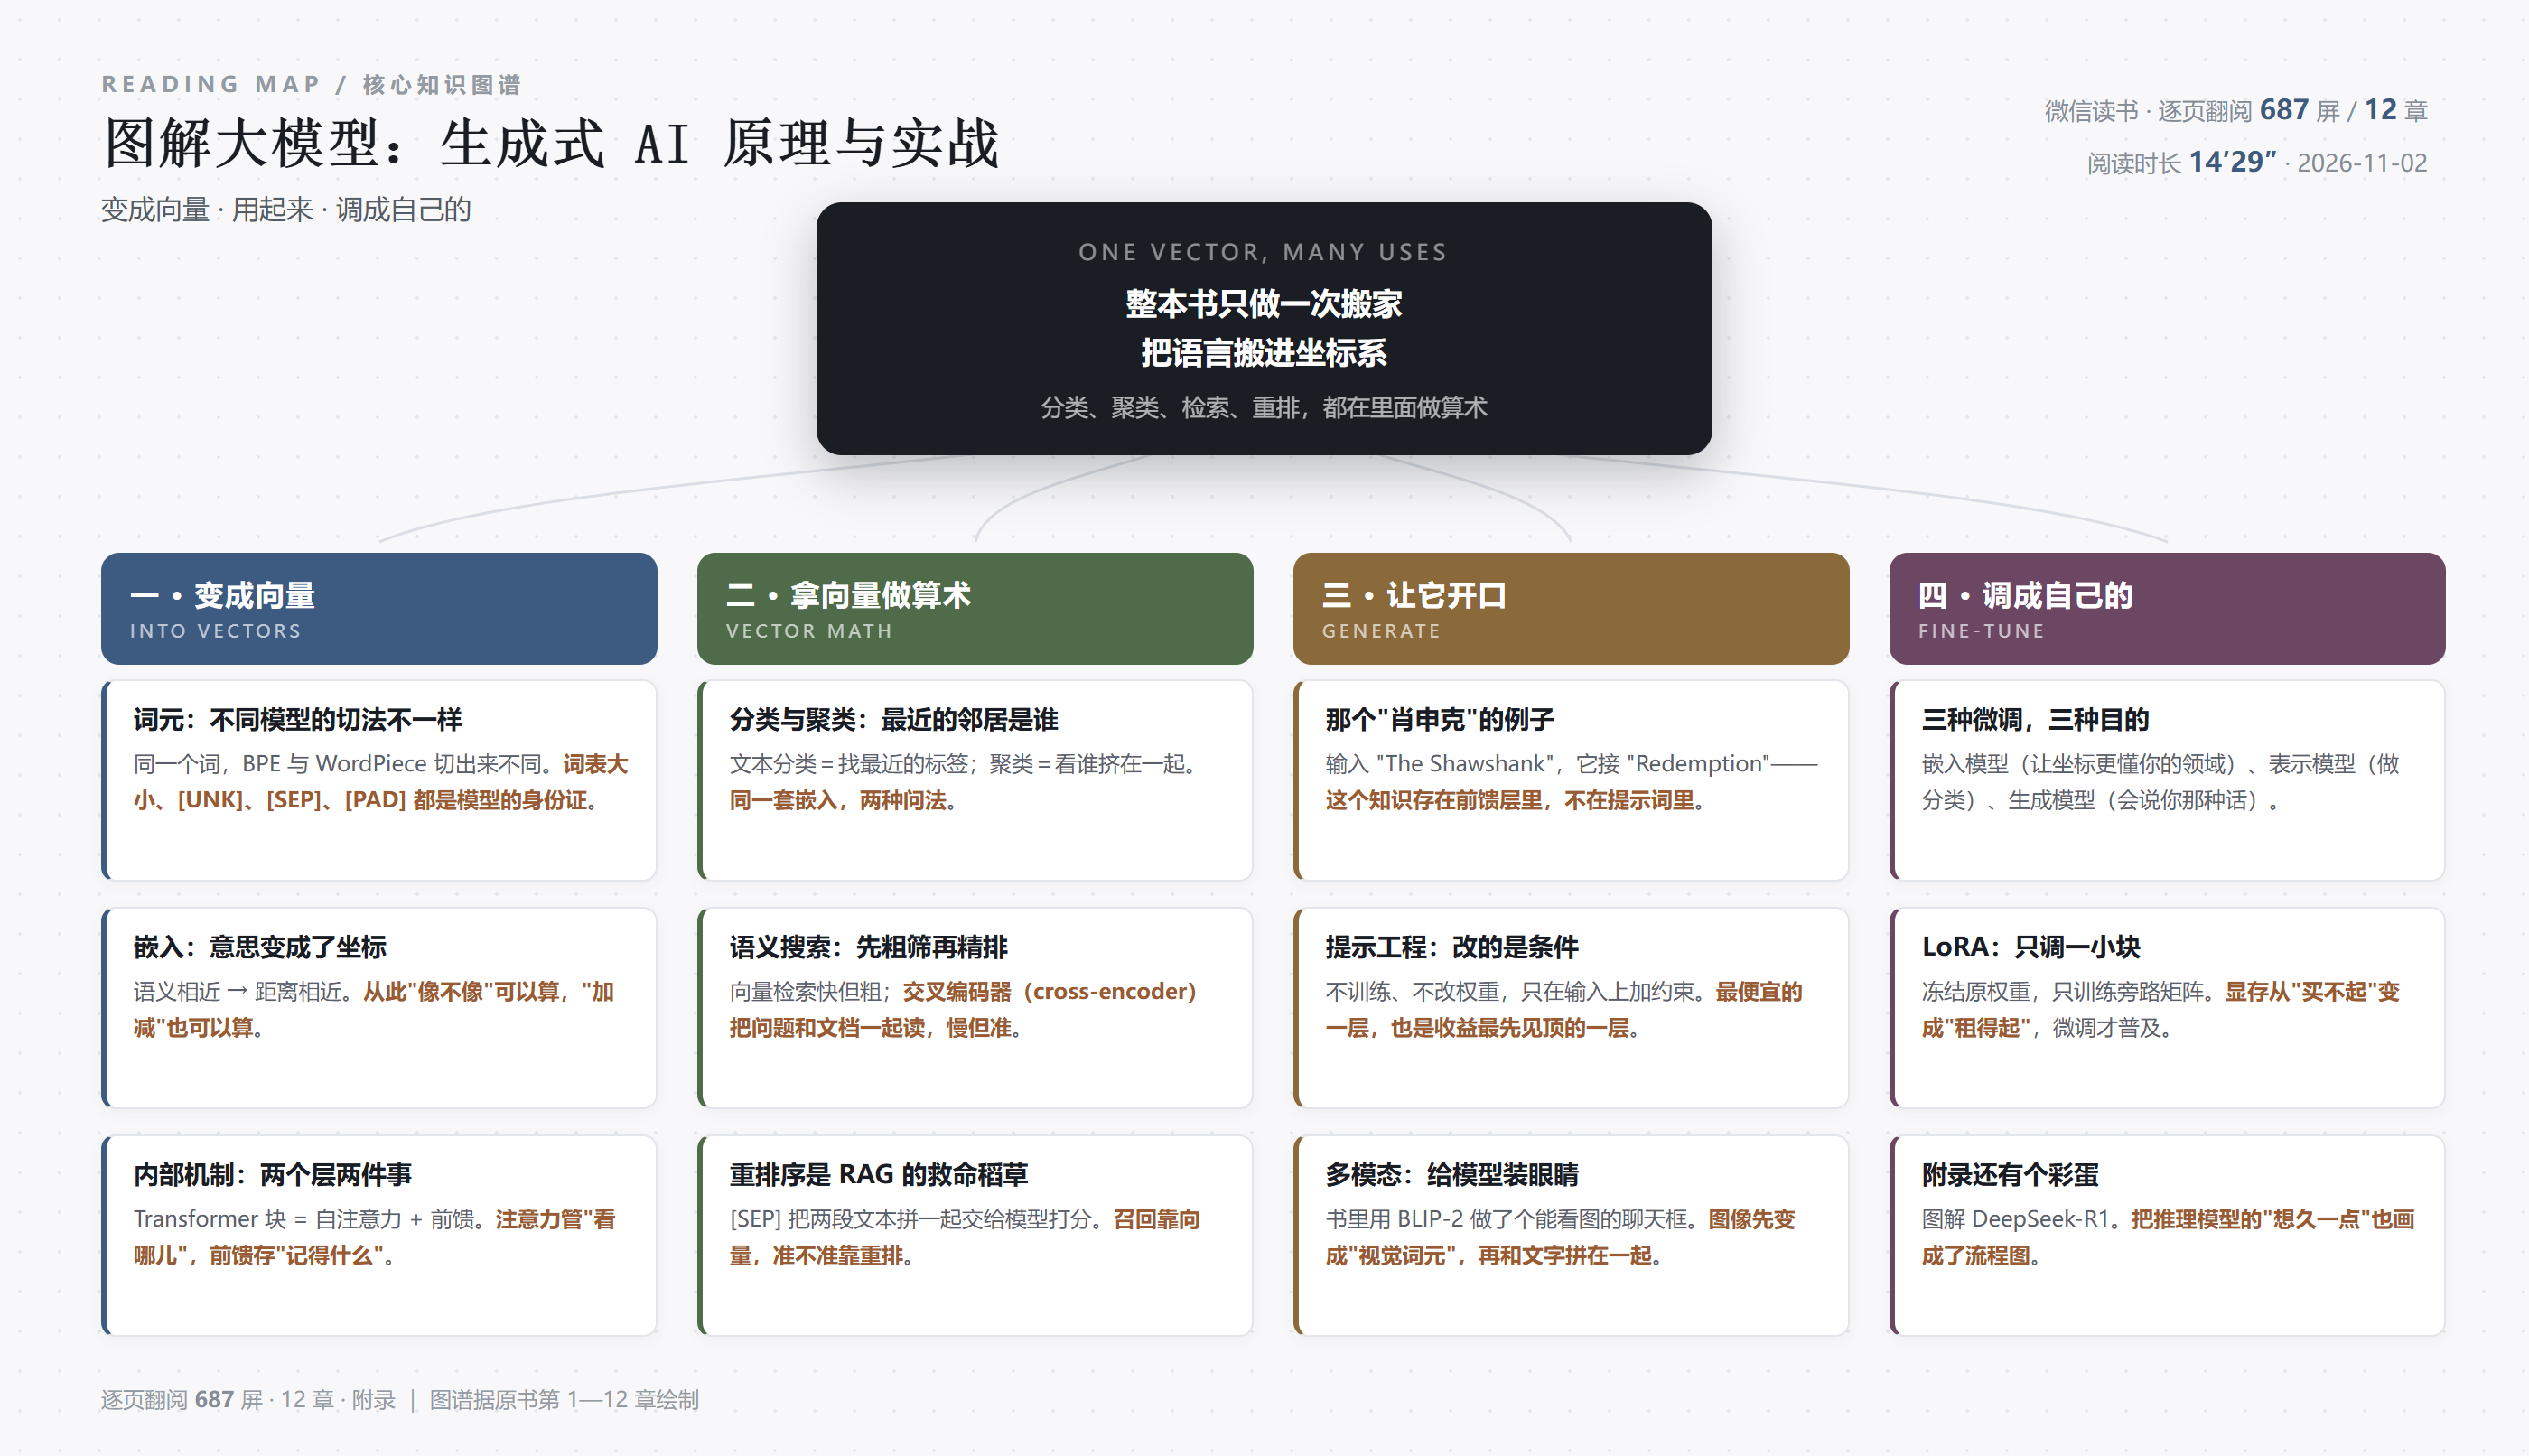
而全书的线索,我认为可以压成一句话:它只做了一次搬家——把语言搬进一个坐标系。
前半本讲怎么搬,中间讲搬完之后能干什么,最后讲怎么把这个坐标系调成你自己的。
一、先变成词元:模型的"身份证"
第 2 章讲词元和嵌入,是我读过的同类内容里最清楚的一份。
它干了一件别人不太干的事:把不同模型的切词方式和特殊词元列成清单。 比如 BERT 基座模型,分词方法是 WordPiece,词表大小 30522,然后逐个解释特殊词元:
[UNK]——未知词元,分词器没给某类字符做特定编码时用它;
[SEP]——分隔符元,用于需要给模型提供两段文本的特定任务,这时模型被称为交叉编码器;
[PAD]——补齐用的填充符元。
这些细节看着琐碎,但它们其实是一张身份证:你看到词表大小和特殊词元,就能大致判断这个模型是什么年代、什么用途、怎么用。
而 [SEP] 那一条尤其值得记住——书里特意点了一句"我们将在第 8 章看到分隔符在重排序中的应用"。这是一个伏笔,后面确实用上了。
二、再看内部:两个层,管两件事
第 3 章讲 LLM 内部机制。书里的结论很干脆:一个 Transformer 块 = 一个自注意力层 + 一个前馈神经网络层。
然后它举了个极好的例子来说明前馈层在干什么:
输入 "The Shawshank",期望模型接出 "Redemption"(1994 年的电影《肖申克的救赎》)。
书里的解释是:前馈神经网络(分布在所有模型层中)就是这些信息的来源。 当模型在大规模文本上训练完成后,它学习并存储了完成这项任务所需的信息与行为。
我认为这个例子把一件很抽象的事讲明白了:
注意力负责"看哪儿"——它决定这个词该关注句子里哪些位置,是把上下文串起来的机制;
前馈层负责"记得什么"——它像一个巨大的查表器,把训练时见过的事实与搭配存在参数里。
这两件事分开看,很多现象就好解释了:
为什么它能接上"肖申克"后面的词?因为前馈层里存着这个搭配。
为什么它会把事实记错、还一本正经?因为前馈层存的不是数据库,是统计出来的"最像的那个"。
所以"幻觉"这件事,在结构上就有解释:它不是查不到,是查到了一个很像的。
三、用起来:所有玩法都是向量算术
第二部分(第 4 到 9 章)讲怎么用预训练模型。它的六章看起来各干各的:分类、聚类、提示工程、生成、语义搜索、多模态。
但底层是同一个动作:把东西变成向量,然后在这个空间里做算术。
分类=找最近的标签向量。
聚类=看哪些向量挤在一起。
语义搜索=找离问题最近的那几段。
重排序=把问题和文档拼起来一起读,让模型直接判"这段能不能回答这个问题"。
最后这一条,我认为是全书对工程实践最有用的部分。
书里点明了那个关键机制:用 [SEP] 把两段文本拼在一起,交给交叉编码器打分。
为什么需要它?因为向量检索有个天生的短板——它把问题和文档分别压成一个向量,再比距离。压的过程就丢了细节。 一段话里只要有一句相关,整体向量就可能被拉近,于是"召回"回来了,但答不上。
交叉编码器反过来:它不压缩,它把两段话一起读。 慢,但准。
所以工业界的标配是两步:先用向量粗筛出几十条,再用交叉编码器精排出几条。 一个负责"不漏",一个负责"不错"。
书里那句话我一直记着:召回靠向量,准不准靠重排。 很多人做 RAG 效果不好,问题就出在只做了前半截。
第 9 章讲多模态,用 BLIP-2 做了个能看图的聊天框——图像先变成"视觉词元",再和文字词元拼在一起喂给模型。又是同一招:变成向量,然后拼起来。
四、调成自己的:三种微调,一个门槛
第三部分(第 10 到 12 章)讲训练与微调,分了三种:
构建嵌入模型——让坐标系更懂你的领域。
微调表示模型——做分类这类判别任务。
微调生成模型——让它会说"你那种话"。
这三种对应三种不同的需求,选错了就白费力气:你要它"更懂"就调嵌入,要它"会分"就调表示模型,要它"会说"才调生成。
而这一部分真正的分水岭,是 LoRA 这类参数高效微调方法。
书里给了几条延伸阅读(SetFit、AdapterHub、LLaMA-Adapter,还有一篇讲"内在维度"的论文)。核心思想其实简单:冻结原来的权重,只在旁边加一小块可训练的参数。
它的意义不在技术,在门槛:微调从"要有几张 A100"变成了"一张消费级卡也能试"。
我认为这是过去两年最重要的一次"降门槛"。因为一项技术真正普及,不是因为效果变好,是因为试错成本变低了。
五、这本书的短板
一是要动手才读得进去。 全书大量代码(Hugging Face、sentence-transformers、BLIP-2、SetFit),不跑一遍的话,很多章节会读成"名词解释"。它是工作手册,不是闲书。
二是环境门槛随时间上涨。 译本里的库版本和现在有差距,直接照抄大概率报错,得自己调。这类书的宿命:越实用,越易过时。
三是中文版的"加料"有点杂。 附录"图解 DeepSeek-R1"和"大模型面试题 200 问"是后加的,前者有价值,后者见仁见智——它更像备考材料,不像书的一部分。
它的优点是:它真的在"图解"。 大多数书说"嵌入是一个向量",这本书会把那个向量的形状、每一维代表什么、相似度怎么算,一步步画出来。看得见的数据流,比讲得清的比喻更有用。
六、一句话
这本书讲了很多技术,但真正的骨架只有一句:先把语言搬进一个坐标系,然后所有事都变成在这个坐标系里量距离。 分类是找最近的标签,聚类是看谁挨着谁,检索是找最近的段落,重排是让模型亲自读一遍再打分。想通这一层,"又出了个新方法"就不吓人了——多半还是在这张地图上换了个走法。
阅读记录:微信读书网页版逐页翻阅,687 屏 / 12 章 / 14 分 29 秒。
本书知识图谱见文中配图,原图地址:https://www.jiangtian.top/zb_users/upload/kg/llm-illustrated-map.png
发表评论: