
RAG的八种形态,是八次被同一句话逼出来的改版
阅读方式:微信读书网页版,从第 1 章翻到第 8 章末,共 392 屏、8 章、65 分 09 秒。 (原始抓取 3000 帧,其中大量是翻页未生效造成的重复画面,按像素哈希去重后为 392 帧。) 八章:解构 RAG、LlamaIndex 实现、文档聊天助手、多模态解析器、数据库检索器、知识图谱、工作流引擎、多 Agent。
这本书有 8 章,每一章都做一个完整的系统。看起来像"8 个项目",但读完会发现是同一条线被逼着往前走了七步。
每一次加新架构,起因都一样:上一版有个东西"查不到"。
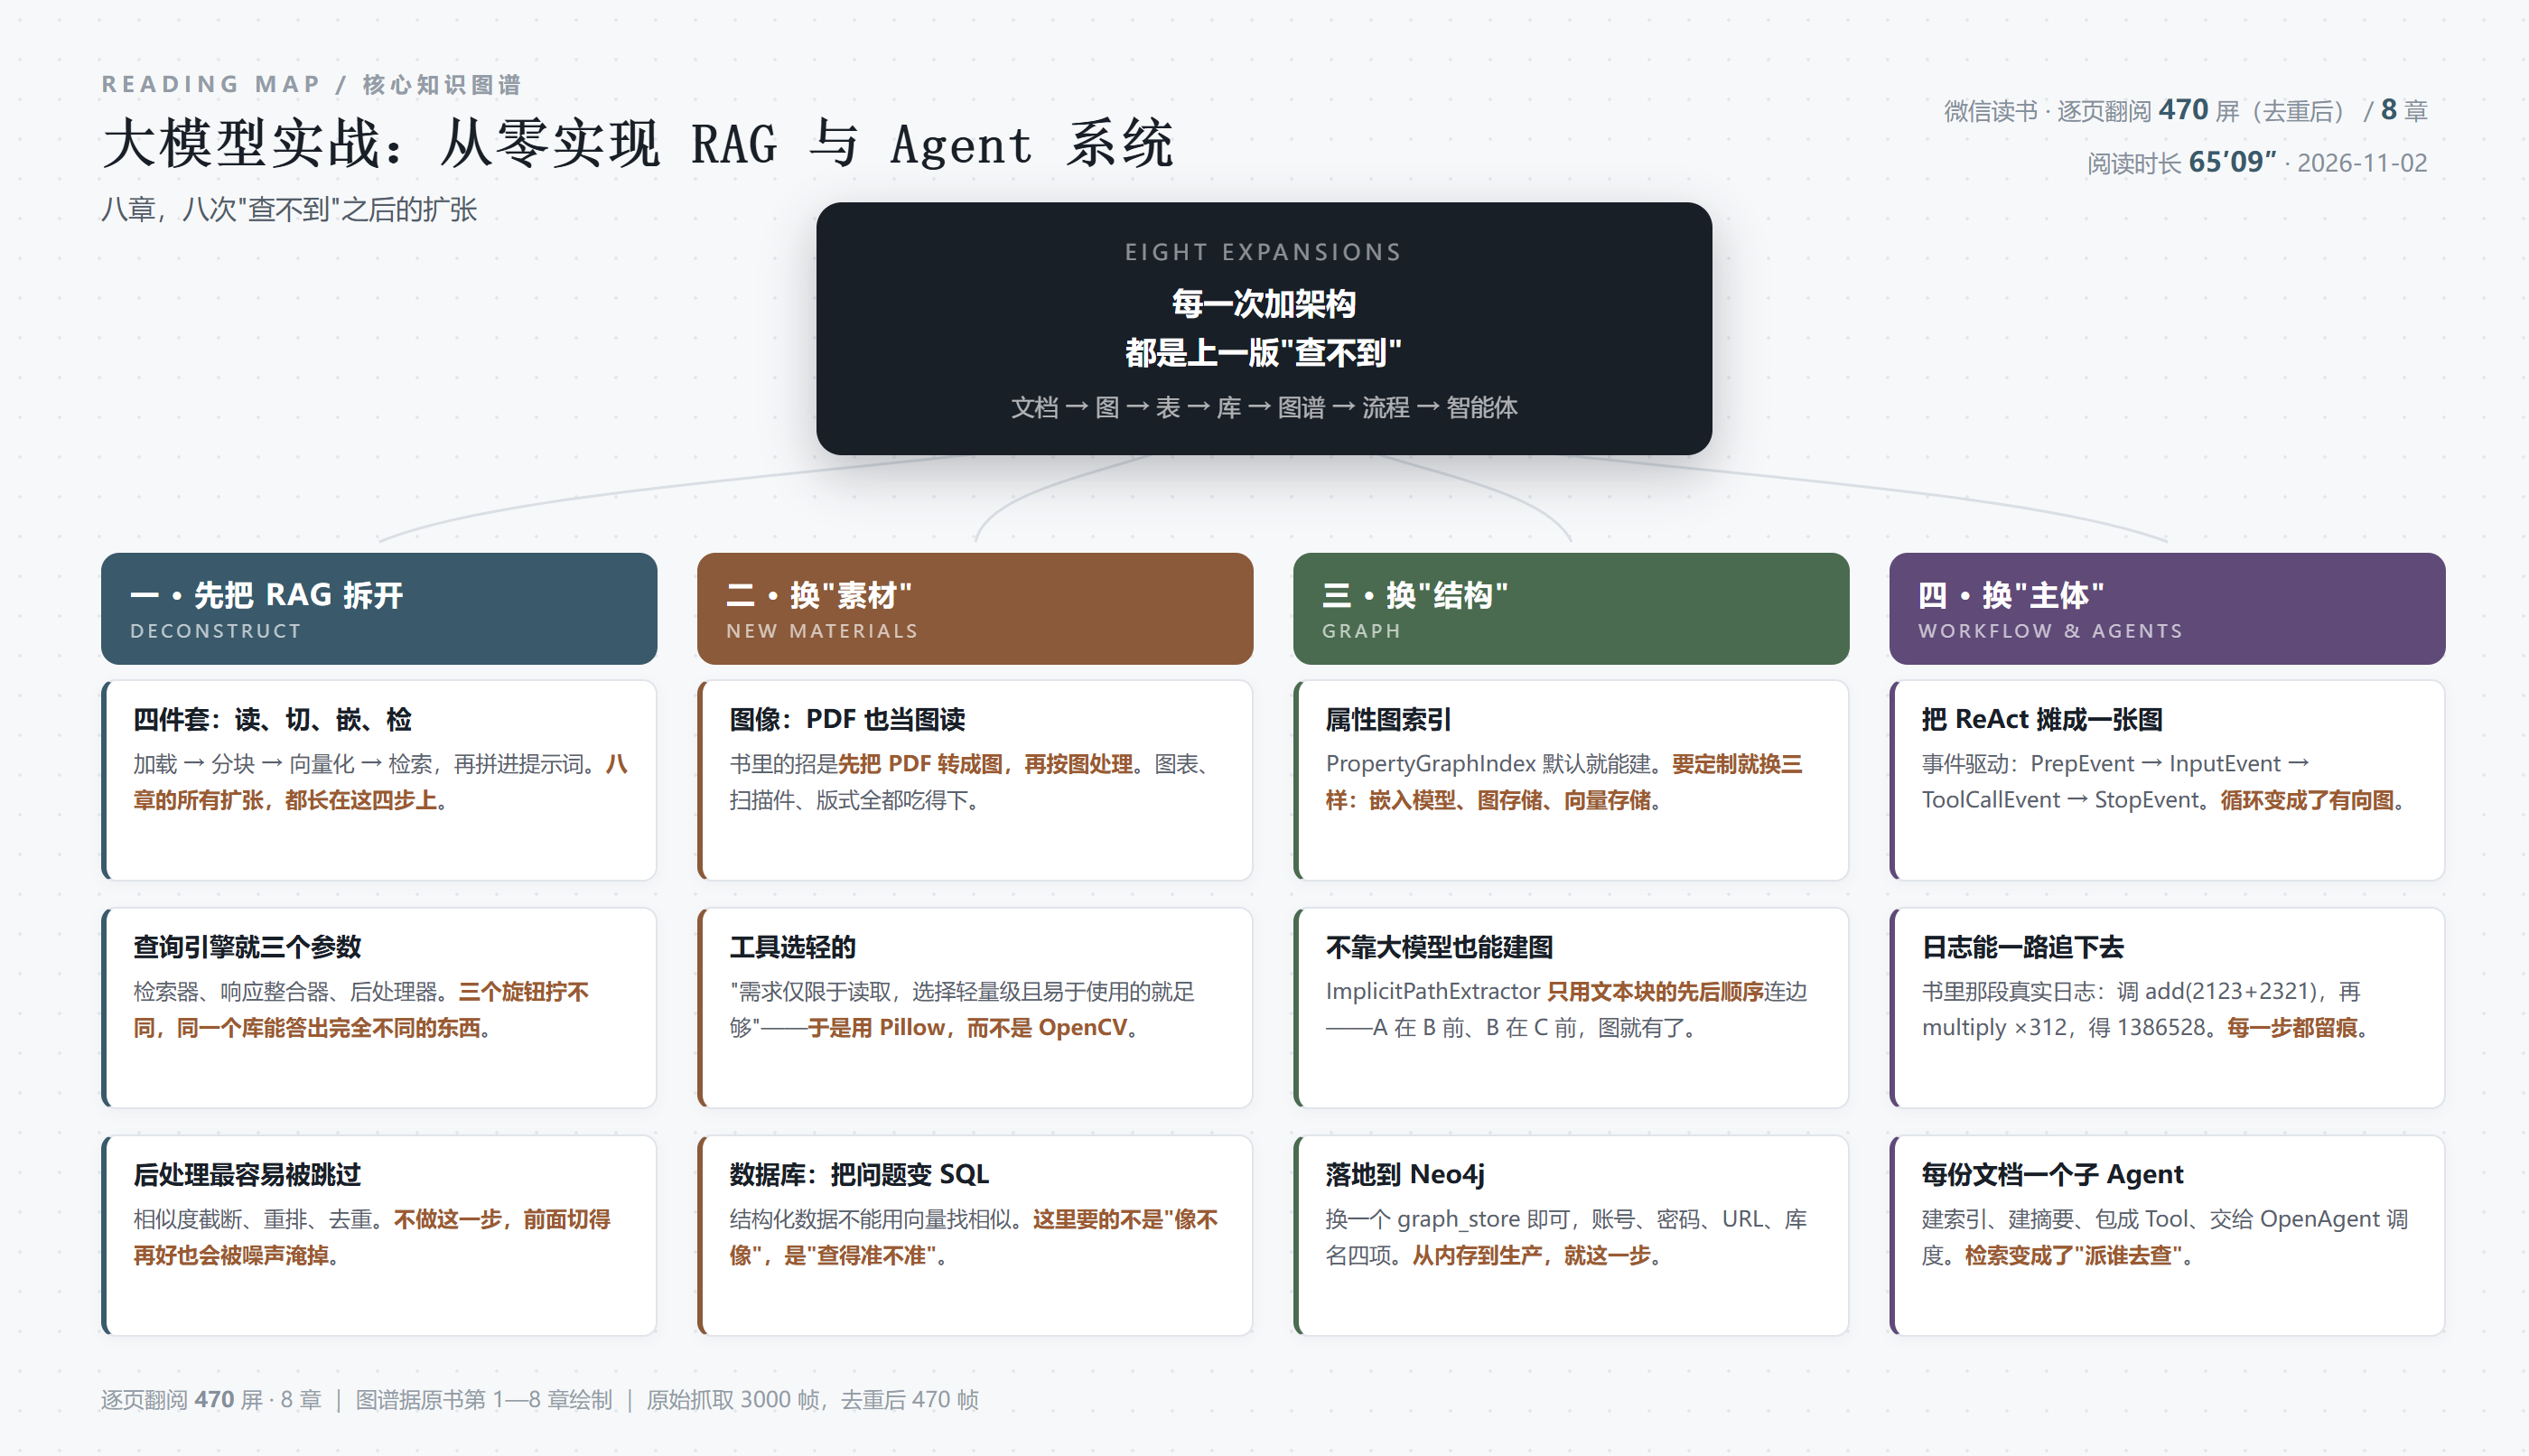
一、先把 RAG 拆开:就四件套,加一个被忽略的后处理
第 1 章"解构 RAG",第 2 章用 LlamaIndex 把它实现一遍。
拆开看,主线还是那四步:读、切、嵌、检——加载文档、切成块、向量化、检索,然后把片段拼进提示词。
但书里有个细节,我觉得比四件套本身更值得记:查询引擎的构造只传三个参数。
一个检索器(retriever)、一个响应整合器(response_synthesizer)、一组后处理器(node_postprocessors)。
作者对这三个的解释是:"这使我们可以根据具体需求对查询引擎的行为进行精细调整。"
我认为这三个旋钮的分工,是理解 RAG 的关键:
检索器决定"捞什么回来";
整合器决定"怎么把这些东西喂给模型";
后处理器决定"捞回来的东西要不要先筛一遍"。
而三者里,后处理器最容易被跳过。很多人的 RAG 就是"检索 top 5 → 拼进提示词",不做相似度截断、不做重排、不去重。
结果是:前面切块切得再讲究,最后被两段不相关的噪声一冲,答案就歪了。而修复它的成本,比重新切一遍库低得多。
二、换"素材":图像、PDF 和数据库
第 4 章的多模态解析器,思路很实用:把 PDF 先转成图片,再按图片处理。
这一手绕过了最麻烦的问题。PDF 里的版式、表格、图表,用文本抽取会散架;但转成图之后,它就只是"一张图",交给视觉模型统一处理即可。用一种笨办法,把多种格式归一了。
选工具的时候,作者的取舍也很"工程":
"鉴于我们的需求仅限于读取图像文件并交由 LlamaIndex 进行处理,选择轻量级且易于使用的图像处理库就足够了。Scikit-image 和 OpenCV 虽然功能强大,但对简单的图像读取任务来说显得过于复杂。因此,我们选择了 Pillow。"
这段话没有技术含量,但它是一种态度:够用就行,不为了"看起来专业"而上重武器。
第 5 章换成数据库检索。这一章的存在本身就在说明一件事:结构化数据不能用向量找相似。
你问"上季度华东区销售额",向量库会捞回三段提到"华东""销售额"的文字,但算不出那个数。这类问题要的不是"像不像",是"算得准不准"——所以必须把自然语言翻成 SQL。
三、换"结构":不靠大模型也能建一张图
第 6 章讲知识图谱,是全书技术含量最高的一章。
它给了两条路。一条是用 PropertyGraphIndex 建属性图,默认组件就能跑;要定制,就换三样东西——嵌入模型、图存储、向量存储。落地到生产时,把图存储换成 Neo4j,只改四个参数:账号、密码、URL、库名。
另一条路我更喜欢,因为它有点"反常识":ImplicitPathExtractor。
这个组件不调大模型、也不调嵌入模型。它只做一件事:利用文本块原本的先后顺序连边。
书里的例子是:一大段文本被切成 A、B、C 三块,而它们的顺序关系是"A 在 B 之前,B 在 C 之前",于是直接建成 A→B→C 的路径。
作者还特意加了一句解释:"在运行过程中,ImplicitPathExtractor 并不依赖于 LLM 或嵌入模型,因为它只是解析已经存在于节点对象上的属性信息。"
为什么我觉得这一手妙?因为它承认了一个事实:文档本身就带着结构,你不用花 token 去猜。
很多团队一上知识图谱,第一反应是"让大模型抽实体和关系",结果抽得又慢又不稳、还贵。而实际上,目录、章节顺序、段落位置,这些现成的结构,已经能撑起相当一部分"多跳"问题。
先用免费的,等免费的不够用了,再花钱——这个顺序,很多人是反的。
四、换"主体":把 ReAct 摊成一张能画出来的图
第 7 章讲工作流引擎,第 8 章讲多 Agent。这两章把前面所有东西收了口。
第 7 章最值得看的是怎么用事件驱动重写 ReAct。书里给的日志是这样的:
Step handle_tool_calls produced event PrepEvent
Running step prepare_chat_history ... produced event InputEvent
Step handle_llm_input produced event ToolCallEvent
call multiply tool: 1386528
... produced event StopEvent
The result of (2123 + 2321) * 312 is 1386528.
注意这里面的事件链条:准备 → 输入 → 调工具 → 停止。 每一步都产出事件,事件驱动下一步。
作者的总结是:"这表明在 ReAct 下,我们可以针对不同的业务需求开发相应的 Tool 组件,并通过事件驱动的方式完成任务处理,以获得预期的结果。"
而更关键的是下一句:调用 draw_all_possible_flows,可以把整个工作流画成一张有向图。
我认为这是这一章真正的价值点。因为在此之前,ReAct 在很多人心里是个黑盒——"它会自己想一想、调个工具、再想一想"。而一旦能画成图,它就从一个玄学循环,变成了一个可以审阅、可以调试、可以讨论的流程。
能画出来,才谈得上改。画不出来的东西,只能靠祈祷。
第 8 章把这套东西推到最后一步:每份文档一个子 Agent。 每份文档建索引、建摘要索引、各自包成 QueryEngineTool,再交给一个 OpenAgent 去调度。
到这一步,检索这件事彻底变了性质——以前是"去库里找",现在是"派谁去查"。
五、这本书的短板
一是代码占比过高。 全书的主体是大段 Python 清单,很多页面整屏都是代码。好处是能照着敲,坏处是代码会过时,而设计不会——真正值得读的是每章开头那段"为什么这么做",可那部分往往只有两三页。
二是缺少横向对比。 八章八个系统,但没有一处回答:"同一个需求,我该从哪一章的方案起步?" 从文档聊天助手跳到多 Agent,中间缺一张选型表。
三是版本绑死。 LlamaIndex 的接口变化很快,书里很多类名和参数在新版本里已经调整。照着跑大概率要改代码,这一点得有心理准备。
它的优点是:它把"RAG 不是一个东西,而是一条能力边界线"这件事演示清楚了。 八章读下来,你会知道"文档问答为什么不够""什么时候必须上图""什么时候该派 Agent"——这些判断,比会调几个 API 值钱。
六、一句话
RAG 的八种形态,不是八个炫技方案,是八次被同一句话逼出来的改版:这个问题,你的库答不了。文档答不了就上多模态,文本答不了就上 SQL,相似度答不了就上图,单库答不了就派 Agent。所以别一上来就选最复杂的架构——那不是先进,那是还没搞清楚自己要回答什么。 先让它答,答不出来再问为什么,架构自然会告诉你答案。
阅读记录:微信读书网页版逐页翻阅,392 屏(原始 3000 帧去重)/ 8 章 / 65 分 09 秒。
本书知识图谱见文中配图,原图地址:https://jiangtian.top/zb_users/upload/kg/rag-to-agent-map.png
发表评论: