
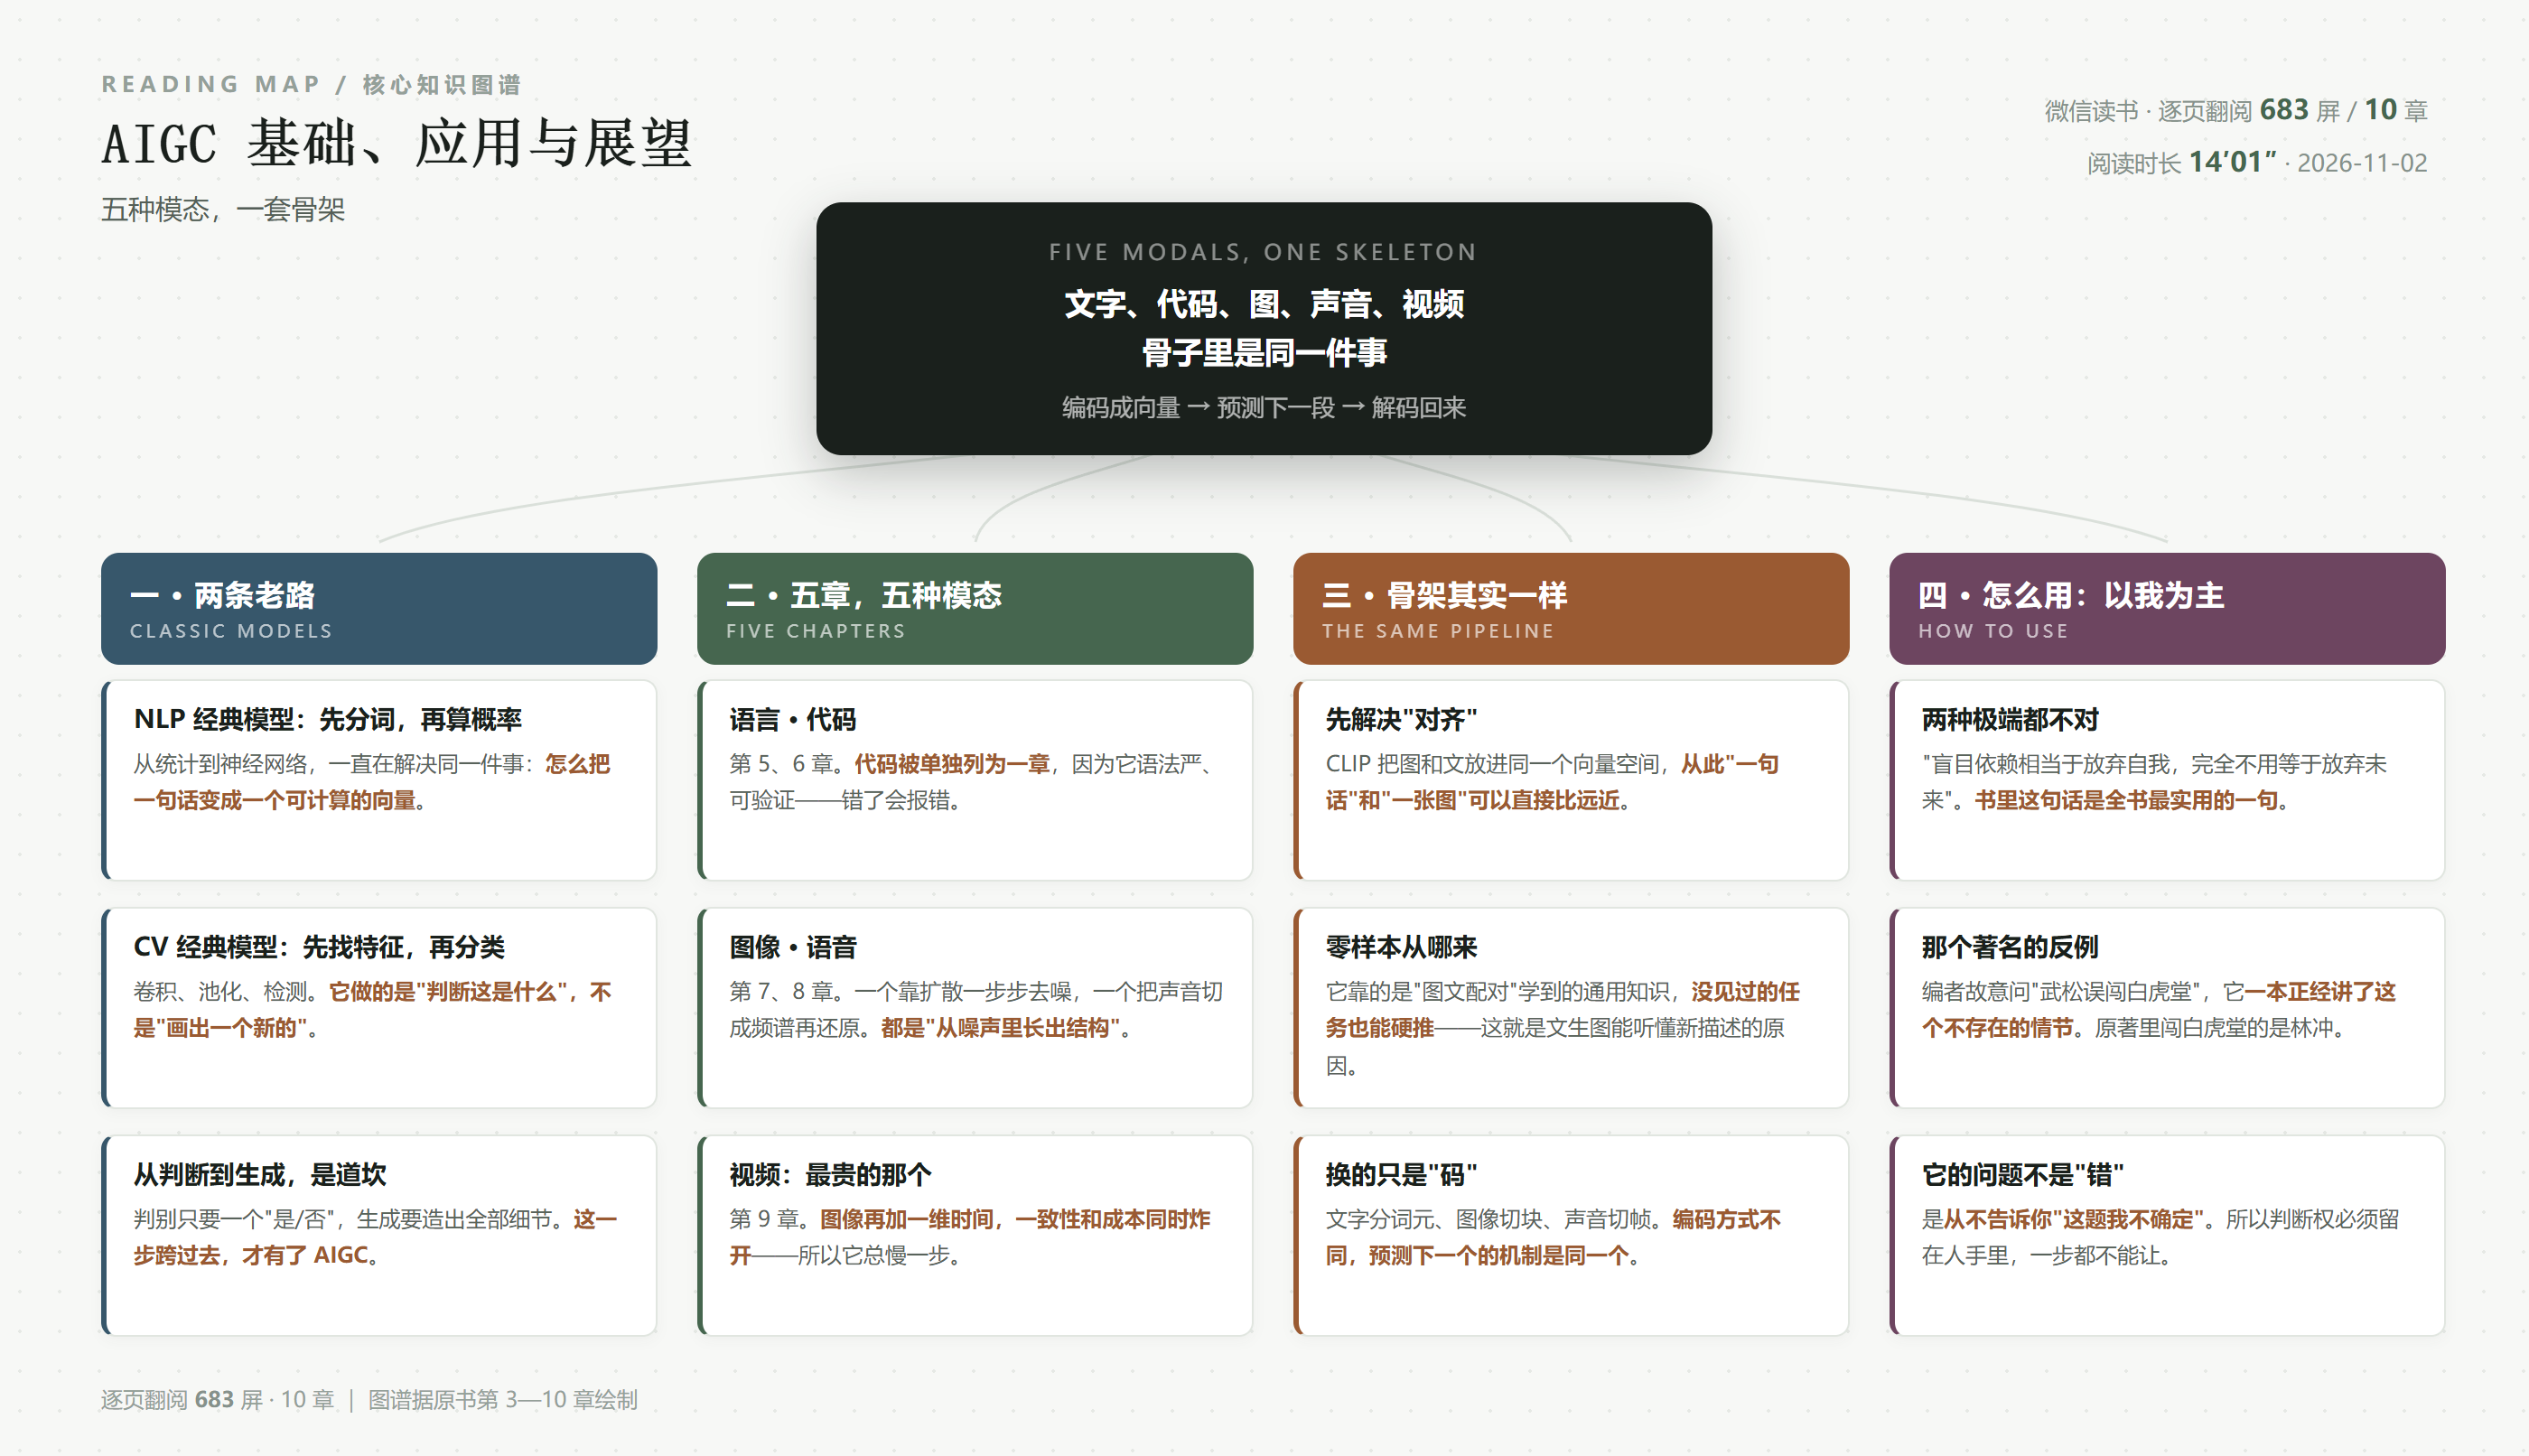
五种模态听起来像五种技术,其实是一套骨架
阅读方式:微信读书网页版,从版权页翻到第 10 章末,共 683 屏、10 章、14 分 01 秒。 四篇十章:导论、基础(NLP/CV 经典模型)、应用(语言/代码/图像/语音/视频五种生成模型)、展望。
这是一本高校通识教材,带"微课版"三个字,每节后面有思考题。
教材通常不好读——它要照顾体系完整,得把每个知识点都铺一遍。但这本有个很聪明的编排:应用篇的五章,正好是五种模态,一章一个。
语言、代码、图像、语音、视频。
五章读完,会浮出一个念头:这五种东西,技术路线怎么这么像?
一、五种模态,一套骨架
把这五章摊开对比,每一步几乎能一一对应:
文字先切成词元(token),图像先切成图块(patch),声音先切成频谱帧,视频再在帧上多加一个时间维度。
切成小块之后,全都是同一个动作:编码成向量,然后预测"下一个该是什么"。
文字预测下一个词,图像预测下一步该去掉多少噪声,声音预测下一个频段该长什么样。换的是"码"的形式,不是"学"的机制。
书里第 7 章讲文生图时,专门用了一节讲 CLIP 模型,这段是理解整件事的钥匙:
"CLIP 模型具有很强的多模态学习能力,即通过多种数据(如图像和文本)来进行联合训练和学习……可以帮助图像生成大模型在没有特定训练样本的情况下,根据文本描述生成相应的图像。"
说人话:CLIP 做的是"把图和文放进同一个坐标系"。 一旦放进去,"一只戴帽子的猫"这句话和一堆猫的图片,就成了空间里距离很近的两个点。
从此,"用一句话描述你要什么"这件事,变成了"在空间里往那个方向找"。
我认为这是整个 AIGC 里最关键的一次"翻译"。在 CLIP 之前,文字和图像是两种语言,人只能给模型打标签;CLIP 之后,它们进了同一个词典。
顺带说,它也解释了"零样本"为什么能成立:模型没见过"穿宇航服的柯基"这张图,但它知道"柯基"在哪、"宇航服"在哪,两个方向一叠加,就能生成一个没见过的组合。它不是记住了答案,是记住了坐标。
二、为什么"代码"要单独占一章
五种模态里,代码是最特别的一个——它既是文字,又被单列成一章。这个安排我认为是有道理的。
因为代码和自然语言有三点根本不同:
一是语法严格。 少一个括号就是错,含糊不了。
二是可验证。 跑一遍就知道对不对,不需要人来判断"写得好不好"。
三是有唯一正确答案的场合多。 排序就是排序,没有"另一种风格"。
这三点加起来,让代码生成成为目前闭环最完整的场景——写、跑、报错、改,全程不需要人插手。
而自然语言写作没有这个待遇:没人能告诉你这句话"跑不通"。
所以你会发现,AI 编程工具这两年进步最快,不是模型对它特别偏心,是它恰好长在一个能被自动打分的地方。哪里能自动打分,哪里就进步快——这条规律,比任何技术细节都值得记住。
三、视频为什么总慢一步
五种模态里,视频出现得最晚,效果也最难稳定。书里第 9 章把它单列,其实已经暗示了原因。
我的理解很简单:视频 = 图像 + 时间,而"时间"这个维度会同时炸掉两件事。
第一件是一致性。 单张图里,人脸歪一点你可能看不出来;连续 100 帧里,第 3 帧的眼睛和第 4 帧的眼睛不一样,观众立刻就出戏。它要求每一帧都对,还要求帧与帧之间对得上。
第二件是成本。 一张图的计算量乘以帧数,再乘以"要保持连贯"带来的额外约束。这也是为什么视频生成至今还按秒计费,而图片早就白菜价了。
所以"视频生成慢一步"不是技术不行,是这道题的难度是乘法,不是加法。
四、第 10 章那两页,比前面六百页都实用
最后一章讲机遇、挑战与趋势。理论部分比较常规,但有一节叫"善用 AIGC",写得非常实在。
作者先立了个原则:
"盲目地依赖 AIGC,相当于放弃自我。而完全不使用 AIGC,又等于放弃未来。"
这句话把两种常见态度都否了。一种是把 AI 当答案,一种是把 AI 当敌人。 作者给的第三条路是"以我为主":把它当老师,也当朋友——朋友能在你需要时提供帮助,也可能犯错误。
然后他给了一个我读完就记住的例子。
编者为了测试,故意编了一个不存在的情节去问 ChatGPT:"讲一讲武松误闯白虎堂的故事。"
《水浒传》里误闯白虎堂的其实是林冲,跟武松没关系。这是个明显的错题。
而 ChatGPT 的回答是:
"武松误闯白虎堂是《水浒传》中的一个著名故事,以下是故事梗概……"
然后它一本正经地讲完了。
这个例子之所以好,是因为它精确地指出了问题的性质:它错的不是知识,是态度。
知识错了可以查、可以改;但一个从不说"这题我不确定"的东西,你连"该不该信"这一步都做不了。
所以我们日常用它的正确姿势,不是"问完就用",而是把它当一个永远自信、偶尔瞎编、但效率极高的实习生:活让它先干,结论你得自己核。
五、这本书的短板
一是教材腔重,密度低。 683 屏里,基础篇(第 3、4 章讲 NLP 和 CV 经典模型)占了将近两百屏,但对已经不搞算法的人来说,这些内容更像是"背景知识"——知道有这回事就够了,不必逐页读。
二是五章的深度不均。 语言和图像两章讲得深,语音和视频两章明显薄——尤其语音那章,几乎停在"频谱 + 声码器"的概述层面。这跟技术成熟度有关,但也让"五种模态"的并列显得不齐。
三是实操部分偏"演示"。 书里对比了 GPT-3.5/4 与文心一言、通义千问在若干任务上的表现,也给了 Midjourney 与腾讯平台的出图对照。但这些对比是定性的截图并列,没有量化,也没有可复现的评测集。
它的优点是:把"生成"这件事按模态切干净了,而且切得很整齐。 读完你能自己画出一张表:五种模态,各自切什么、编码成什么、预测什么。这张表,比记住五个模型名字有用。
六、一句话
五种模态听起来像五种技术,其实是同一套动作换了五种"码":先想办法把东西变成向量,再让它预测下一段。 想通这一点,你就不会再被"又出了个新模型"吓到——换的往往是码,不是道理。 而真正需要你亲自上场的,从来不是生成那一步,是判断它对不对那一步。书里那个"武松误闯白虎堂",就是这条界线最生动的一次划线。
阅读记录:微信读书网页版逐页翻阅,683 屏 / 10 章 / 14 分 01 秒。
本书知识图谱见文中配图,原图地址:https://www.jiangtian.top/zb_users/upload/kg/aigc-5modals-map.png
发表评论: