
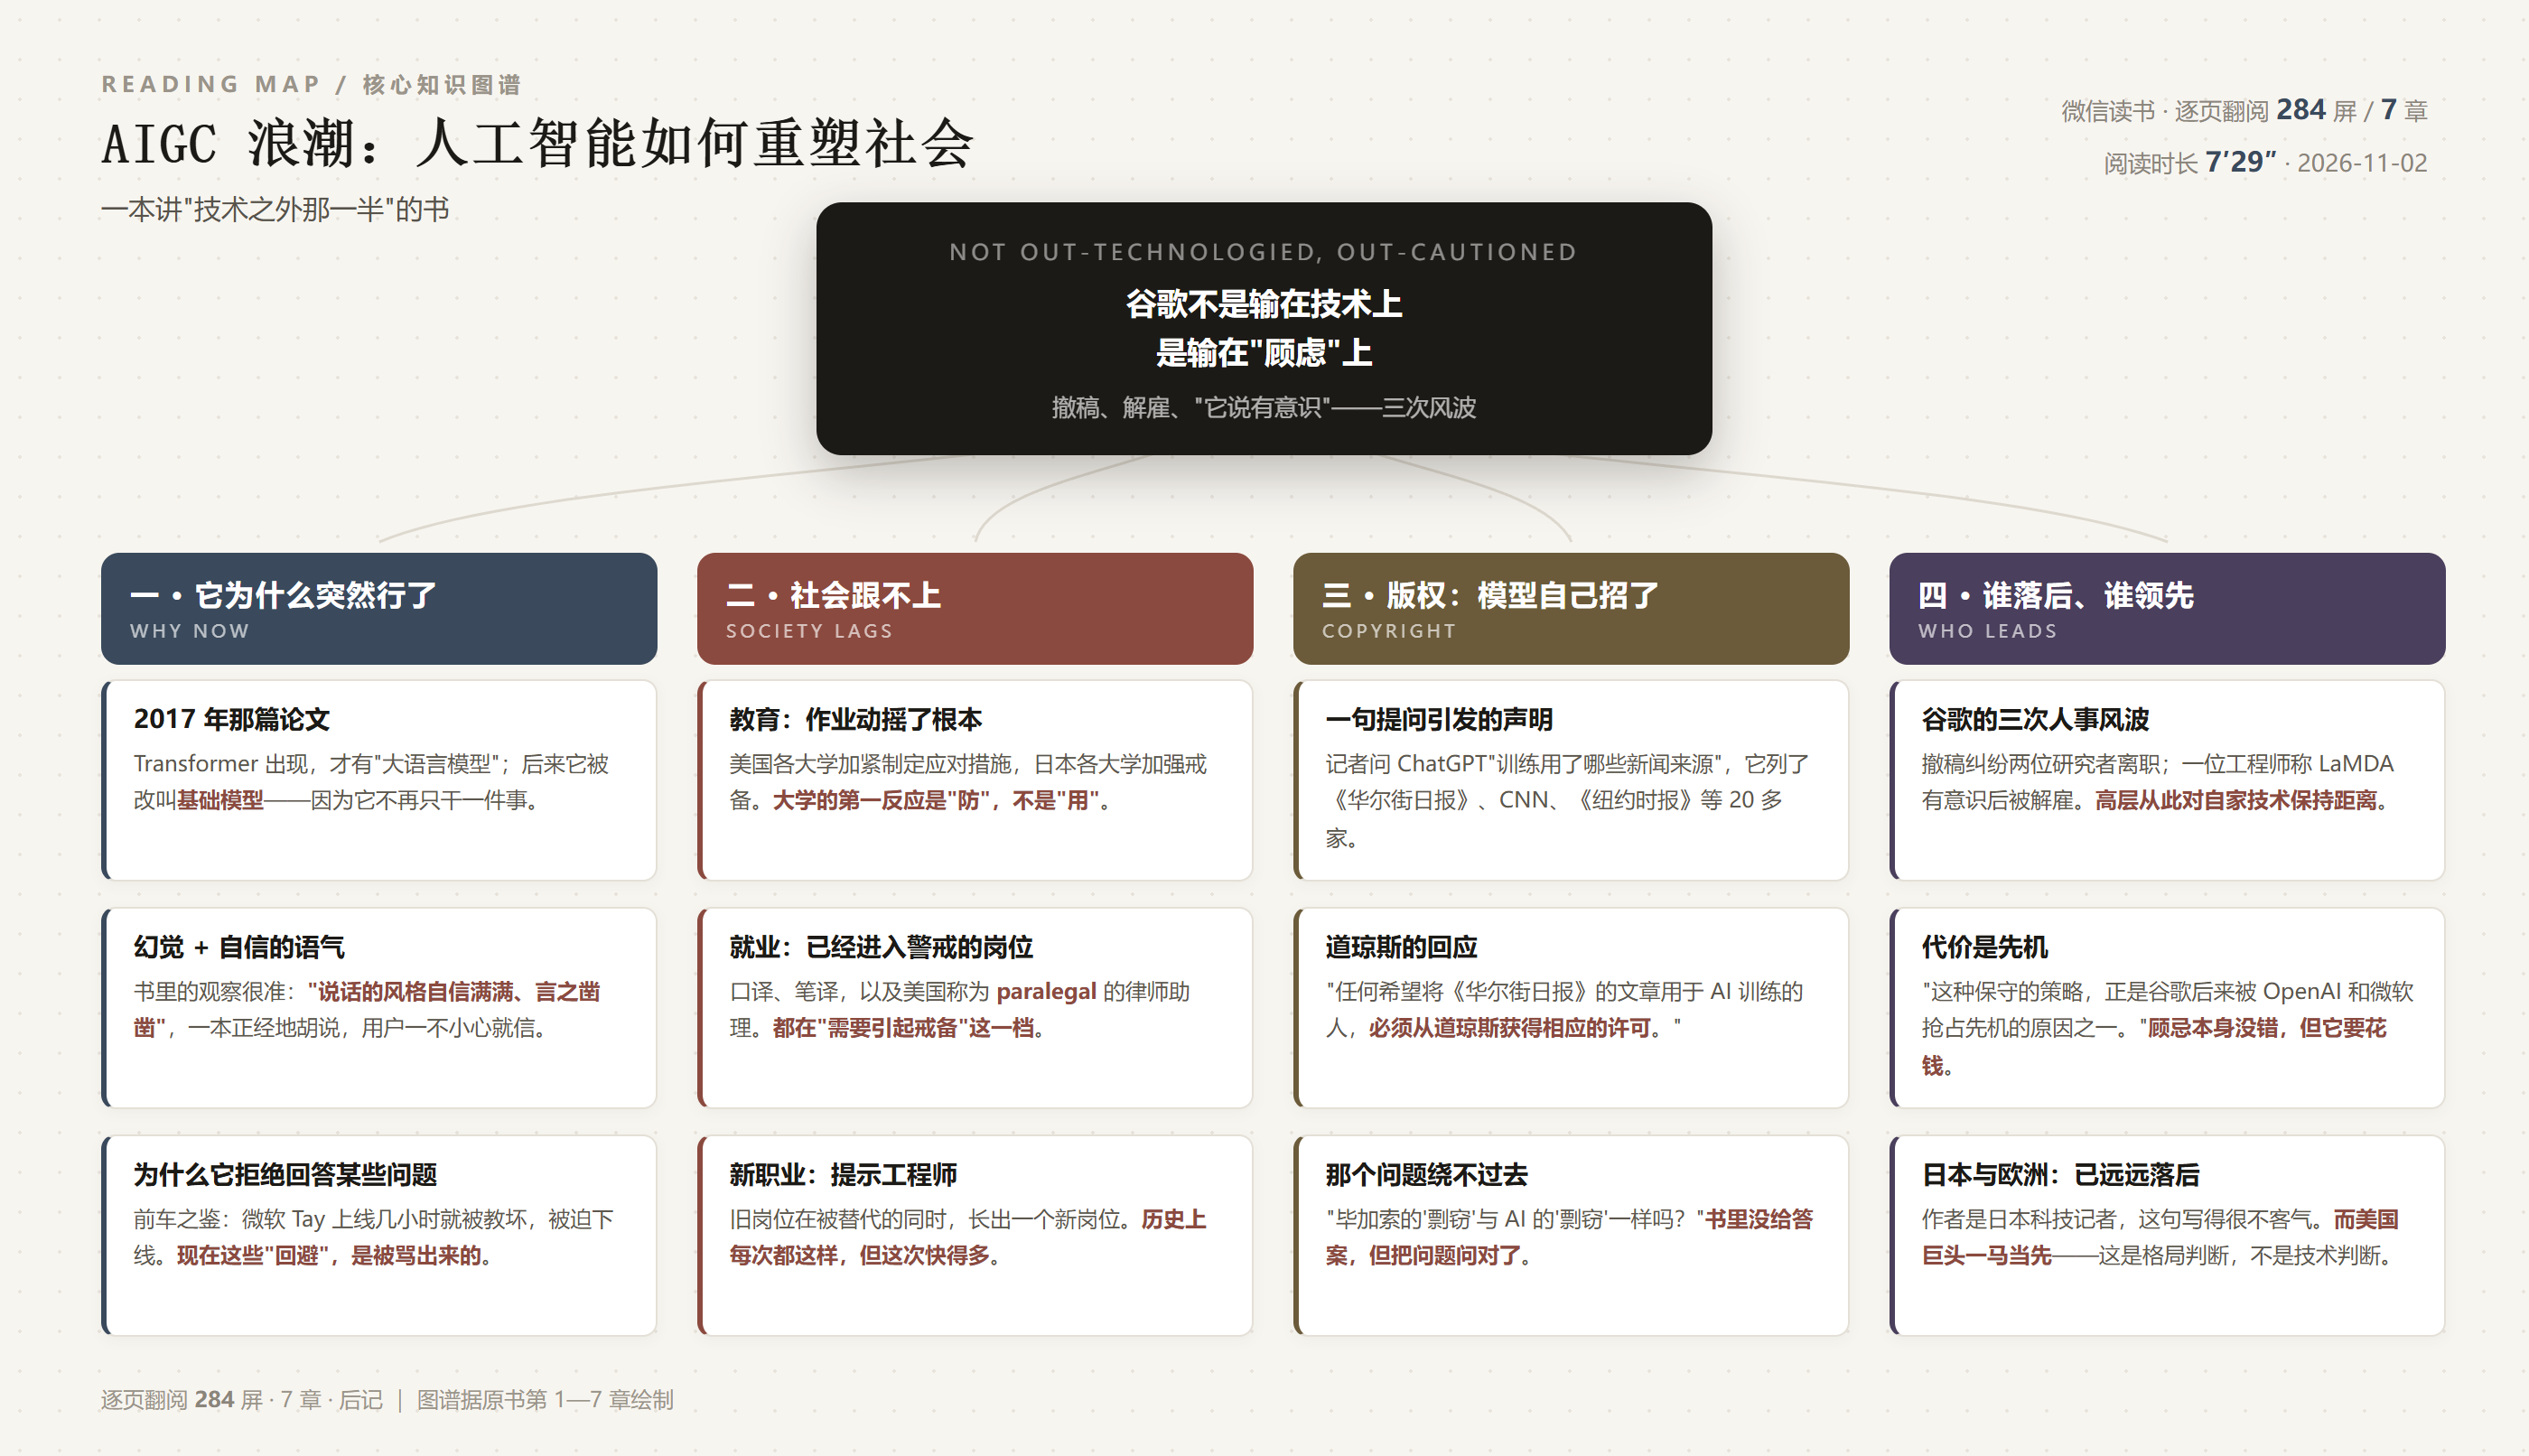
谷歌不是输在技术上,是输在顾虑上
阅读方式:微信读书网页版,从版权页翻到后记,共 284 屏、7 章、7 分 29 秒。 七章:ChatGPT 的冲击、如何影响世界、生成式 AI 之前的 AI 史、Transformer、谷歌与 OpenAI 的此消彼长、图像生成、创造性的本质,加一篇后记。
这本书的作者是一位日本科技记者。这个身份很重要——他写的不是技术,是"社会怎么接住它"。
同类的书里,技术部分大同小异:Transformer、注意力、大语言模型。但这本的重心在后面几章:谁被告了、谁被解雇、哪个岗位被列进警戒线、哪所大学第一反应是禁止。
而它给出的最反直觉的一个判断,是关于谷歌的。
一、谷歌不是输在技术上
第 5 章的标题叫"苦恼迟疑的谷歌与高歌猛进的 OpenAI 和微软"。这个对比很扎眼,但作者的解释比"谷歌掉队了"复杂得多。
他列了三件事:
第一件,一篇关于大模型偏见与风险的论文引发撤稿纠纷,两位研究者相继离职。
第二件,2021 年 2 月,其中一位在离职两个月后被以"违反公司行为规范和安全政策"为由解雇。
第三件,2022 年,一位 AI 评估人员在接受采访时称大语言模型 LaMDA 具有意识,随后被解雇,引发轩然大波。
然后作者写了一句我认为全书最见功力的话:
"经过上述这些事件,也难怪谷歌高层会采取与这种 AI(大语言模型)保持距离的策略……也许这种保守的策略正是谷歌后来被 OpenAI 和微软抢占先机,并在大语言模型开发竞争中陷入被动的原因之一。"
注意他的用词:"也许"、"原因之一"。这种克制,比一口断定"谷歌因为怕被骂所以输了"要可信得多。
但我还是想把这句话往前推一步,因为它指向一个很现实的处境:一家公司越是被公众盯着,它的技术就越难发出来。
不是能力问题,是"发出去之后要解释"的成本问题。你发一个模型,要先想清楚它会不会被用来造谣、会不会说出不该说的话、会不会上一个记者的头条。这些顾虑都是对的,但它们要花钱,花的是时间。
而一个新来的公司,没有这些包袱。它只需要跑得快。
所以"领先"这件事,有时候不取决于谁的技术更强,取决于谁更敢先把它放出去。这是个组织问题,不是技术问题。 这一点,对任何在大公司里做事的人都不陌生。
二、版权:模型自己把人给招了
第 6 章讲图像生成与诉讼,但最精彩的一段其实是文字模型引起的,而且过程有点荒诞。
据书里引述的报道:一位记者去问 ChatGPT——"你训练时使用的新闻来源是什么?"
它回答了,列了《华尔街日报》、CNN、《纽约时报》等 20 多种主流媒体。
然后是道琼斯的声明:
"任何希望将《华尔街日报》的文章用于 AI 训练的人必须从道琼斯获得相应的许可。"
CNN 随后也提出抗议,并要求支付训练数据的内容使用许可费。
作者很谨慎地补了一句:鉴于 ChatGPT 会出错或产生幻觉,这个检举是否妥当尚不确定——但它确实说明,主流媒体的内容被用于训练的可能性是存在的,而 OpenAI 并未获得许可。
我特别喜欢这一段,因为它同时暴露了两件事:
一是模型的"自知"是假的。 它说的训练来源,可能只是从语料里学来的"合理猜测",不是真的查询了训练日志。它连自己吃了什么,都是猜的。
二是版权这件事,很难靠"查"来解决。 你没法打开模型的脑袋看它记了哪篇文章。所以争议最后不会落在技术上,会落在"谁来承担举证责任"上。
书里还问了一个更根本的问题:"毕加索的'剽窃'与 AI 的'剽窃'一样吗?"
它没给答案。但我认为这个问题的价值在于它把讨论从"技术是否侵权"拉到了"创造是什么"——一个人类画家看遍前人的画,然后画出自己的,这叫学习;一个模型看遍前人的画,然后生成一张,这叫不算?
这个界线,法律还没画完。
三、就业:警戒线画在哪三个岗位
第 2 章讲社会影响,作者列了一份"已经进入需要引起戒备阶段"的名单,只有三个:
口译、笔译,以及美国称为 paralegal 的律师助理。
这份名单很有意思,因为它不是"最容易被替代"的名单,而是"已经被替代到需要警戒"的名单。
这三个岗位有个共同点:输入是文本,输出是文本,中间那层判断不重。 翻译要的是准确与通顺,律师助理要的是检索与整理——都不是"必须有人负责"的环节。
而作者紧接着提到的另一句更值得琢磨:即便小说家、漫画家、动画师、电影制作这类创造性岗位,"以目前生成式 AI 的发展速度来看,也无法确保能够一直不受影响"。
这句话写得克制,但意思很清楚:创造性不是护城河,只是更晚被淹到的地方。
同时他也提到了新长出来的岗位——提示工程师。
我不太认同把"提示工程师"当成一个长期职业(它更像一项技能),但作者把这个现象摆出来是对的:每次技术换代,都会先干掉一批岗位,再长出一批新岗位,而这两批人往往不是同一批。
这才是真正的问题所在——不是"有没有新工作",是"被换掉的那个人,能不能变成新工作要的那个人"。
四、教育:第一反应是"防"
书里有一节叫"用 AI 做作业动摇了教育的根本",接着两节分别讲美国各大学加紧制定应对措施、日本各大学加强戒备。
这个"加紧制定""加强戒备"的措辞,把当时的气氛写得很准:大学的第一反应不是"怎么用它教",是"怎么防它作弊"。
我不觉得这有什么可指责的。考试和作业是教育里最基础的度量工具,度量一旦失效,整套体系就要重新设计——而重新设计要很多年。
但这恰好也是这本书最值得读的地方:它记录了一个"制度还没想好"的时刻。技术三个月走完了,制度可能要三年。 中间这段时间,所有人都在凭直觉办事。
五、这本书的短板
一是时效性极强,且写得很"当时"。 大量篇幅在讲 2023 年上半年的事——Bard 刚发、GPT-4 刚出、诉讼刚起。两年后再读,很多"最新进展"已经成了历史注脚。 它更像一本"现场报道合集",不是"长期判断"。
二是技术章节偏薄。 第 3、4 章讲 AI 史和 Transformer,明显是给非技术读者做的压缩饼干,懂行的人会觉得太浅,不懂的人可能还是跟不上。两头不讨好。
三是立场偏"记者",少"判断"。 作者擅长把事实摆清楚、把各方说法列全,但很少给出自己的结论。好处是客观,坏处是读完你会知道发生了什么,但不太知道该怎么想。
它的优点是:它记录了别人不愿意记的那部分。 谁被解雇了、谁被告了、哪个岗位进了警戒线、哪所大学先竖起了墙——这些东西写不进技术文档,但它们决定了技术最后长成什么样。
六、一句话
这本书真正的主题不是 AI 有多强,而是当一项技术跑得比制度快的时候,中间那一段真空由谁来填。谷歌的迟疑、大学的戒备、道琼斯的声明、口译员的焦虑——看起来是四件不相干的事,其实是同一件事的四个侧面:技术三个月走完的路,制度要走三年。 而在这三年里,所有人的判断都只能凭直觉,包括你我。
阅读记录:微信读书网页版逐页翻阅,284 屏 / 7 章 / 7 分 29 秒。
本书知识图谱见文中配图,原图地址:https://www.jiangtian.top/zb_users/upload/kg/aigc-wave-map.png
发表评论: