
监控全绿,退款金额错了一个数量级
阅读方式:微信读书网页版,从版权页翻到第 10 章末,共 470 屏、10 章、10 分 02 秒。 十章:第一次危机、理解系统、执行编排、可靠性、调试排查、生产部署,加三个实战(VLM 审片、农业机器人、裸机代码修复)。
这是我读的这一批 AI 书里,最像"出过事的人写的"一本。
其他书讲怎么搭起来,这本讲怎么塌下去。而且它不是泛泛地说"要注意稳定性",它给了一个具体到能拍成短片的场景。第 5 章开头这段,我认为是全书——也可能是这批书里——最好的一段:
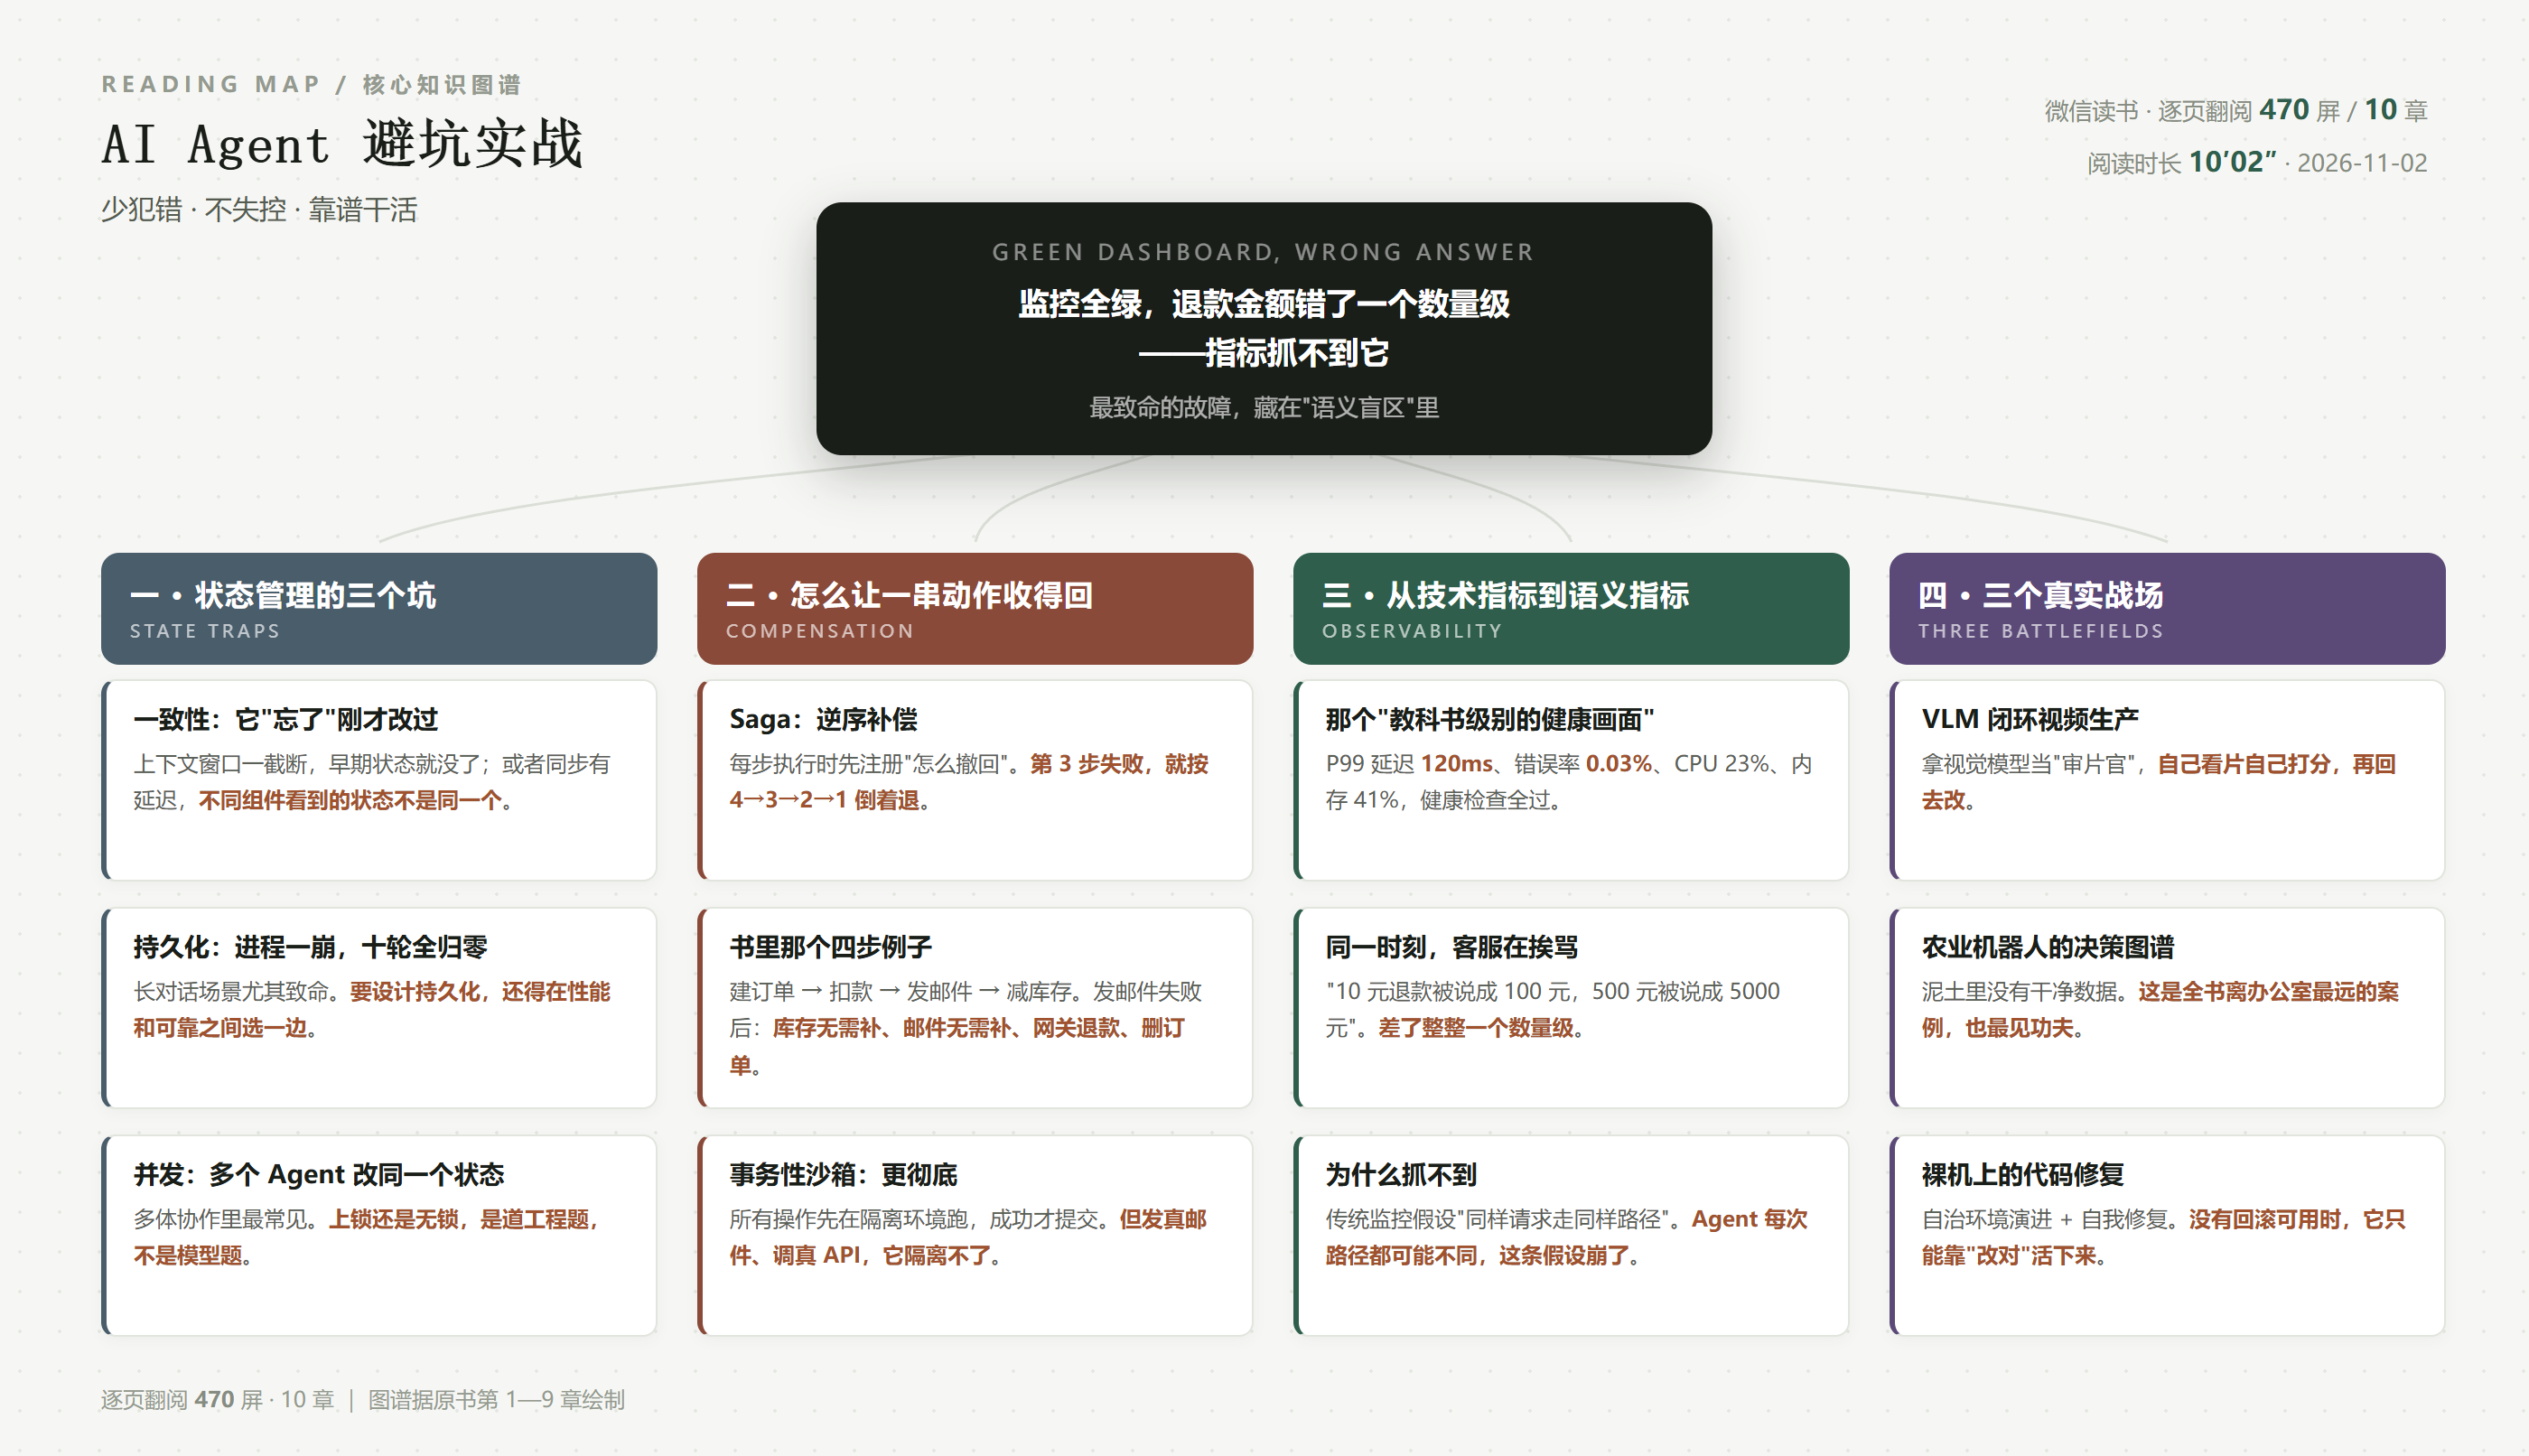
"当运维工程师小王在周一早上打开监控大屏时,一切看起来都是绿色的。P99 延迟稳定在 120 毫秒以内,错误率 0.03%,CPU 利用率 23%,内存使用率 41%,所有服务的健康检查全部通过。这是一幅教科书级别的'系统健康'画面……
然而,就在这个'一切正常'的上午,客服团队却收到了几十起用户投诉:他们反馈 AI 助手给出的退款金额全部偏高了一个数量级,10 元的退款被 Agent 告知为 100 元,500 元的退款被说成 5000 元。"
我读到"500 元被说成 5000 元"的时候,后背有点凉。
因为这不是一个"AI 说错话"的问题,这是一个技术上完全正常、业务上已经出事的状态。而绝大多数团队,监控的就是小王看的那块屏。
一、为什么监控抓不到它
作者的诊断很准,我把它抄下来:
"传统可观测性体系的底层逻辑建立在一个隐含的假设之上:相同的请求会走过相同的调用路径……它们擅长监控的是确定性的技术指标,而 Agent 系统中最致命的问题恰恰发生在技术指标完全正常的'语义盲区'里。"
这句话解释了我这两年看到的一个普遍困惑:为什么 AI 应用"跑得好好的",用户却在骂。
因为传统监控的基础是"同一个请求走同一条路"——一个 GET /api/users/123,今天走这条链路,明天还走这条链路。路径固定,所以你能埋点、能算 P99、能设告警。
而 Agent 不是这样。同一个问题问两次,它可能调三个工具,也可能调五个;可能查了知识库,也可能直接凭记忆答。路径不固定,你埋的那些点就抓不到它。
所以真正的缺口不在技术层,在语义层:它这次说的这句话,跟事实对不对得上?金额算没算错?有没有把不该说的说了?
这些东西,P99 和错误率一个都测不出来。
二、状态:三个坑,全是老坑
第 2 章讲"状态管理的失败陷阱",列了三条。我觉得这三条特别值得单独记,因为它们每一条都是分布式系统的老问题,只是换了个壳:
一是一致性。Agent 在一次调用里改了某个状态,后续调用却"忘了"。书里给了两个原因:上下文窗口限制导致早期信息被截断;或者状态同步有延迟,不同组件看到的状态视图不一致。
二是持久化。进程一崩,内存里的状态就没了。书里的原话很戳人:"用户可能已经展开了十轮对话,瞬间便一切归零。"
三是并发竞争。多个 Agent 同时读改同一个状态,数据不一致。这在多体协作里尤其常见。
这三条归结起来是一句话:Agent 的"记忆"不是模型的事,是存储的事。
很多人以为长上下文窗口大了,记忆问题就解决了。恰恰相反——窗口越大,截断发生得更隐蔽:它不会报错,只是悄悄忘掉了前面那几句关键约束。
三、一串动作做了一半失败,怎么办
第 4 章讲执行可靠性,给的方案是 Saga——逆序补偿。
思路是:每个步骤在执行时就注册好自己的"撤回动作"。一旦某一步失败,就按执行顺序反向逐个撤回已成功的步骤。
书里那个例子讲得极清楚。假设一个 Agent 要做四件事:
(1)数据库里创建订单记录 →(2)调用支付网关扣款 →(3)发送确认邮件给客户 →(4)库存系统扣减库存。
如果第(3)步发邮件失败了,补偿动作按 (4)→(3)→(2)→(1) 逆序执行:
(4)库存还没扣,无需补偿 →(3)邮件没发出去,无需补偿 →(2)调用支付网关退款 →(1)删除数据库中的订单记录。
这个例子妙在"无需补偿"那两步。它说明补偿不是"把每步都反着做一遍",而是只撤那些真的发生了的。这就要求每一步都能判断"我到底成没成"——而这恰恰是 Agent 最容易糊弄的地方:模型说"已完成",你就当完成了。
书里还提了一个更彻底的方案:事务性沙箱。把 Agent 的所有操作都放进一个隔离环境里跑,全部成功才提交,失败就整个丢弃。
但它也老实说了局限:"很多操作无法在沙箱中模拟——发送真实的邮件、调用真实的支付 API、与真实的第三方服务交互。沙箱只能隔离本地状态。"
我认为这段的价值不在于给出答案,而在于它承认了没有完美答案:能回滚的用沙箱,不能回滚的用 Saga,而现实里大多数系统是两者混着的。
四、三个战场,都不是办公室
后面三章是实战,选的场景很有意思——没有一个是"做个客服机器人":
VLM 闭环视频生产:拿视觉模型当"审片官",自己看片、自己打分、再回去改。这是"用模型检查模型",也是目前少有的能闭环的质检方案。
农业机器人的决策图谱:泥土里没有干净数据,光线会变、作物会动、传感器会脏。
裸机上的代码修复:自治环境演进与自我修复。没有回滚可用的时候,它只能靠"改对"活下来。
这三个案例的共同点是:错一次的代价很高,且没人能在旁边看着。 而这恰恰是"避坑"这件事最有价值的场景——办公室里出个错,最多被同事笑一句;田里、产线上、裸机上出个错,是真损失。
五、这本书的短板
一是三个实战的"可复制性"差。 VLM 审片、农业机器人、裸机修复,都是重场景。普通开发者读完,能带走的是思路,不是代码。它更像一本"案例集",不是"手册"。
二是术语门槛不低。 Saga、事务性沙箱、幂等补偿、并发控制——这些在分布式系统里是老词,但对只写过提示词的 AI 开发者是硬墙。书里没有为这类读者做过渡。
三是第 10 章"框架丛林"偏综述。 罗列了一圈框架,但没有给出"什么条件下选哪个"的判断表,读完记不住。
它的优点是:它把"AI 应用出问题"这件事,从"模型不行"重新定义成了"系统没设计好"。 这个视角的转换,比任何技巧都值钱——因为模型你换不动,系统你能改。
六、一句话
AI 应用最危险的时刻,不是它报错的时候,是它一切正常、指标全绿、还一本正经说错话的时候。错误率、延迟、CPU 这些指标衡量的是"机器有没有病",而 Agent 的病长在"说得对不对"这一层——那一层没有报警器,只有用户的投诉。 做 Agent 的第一课,可能不是怎么让它更聪明,而是先给自己装一个能听见"500 元变 5000 元"的耳朵。
阅读记录:微信读书网页版逐页翻阅,470 屏 / 10 章 / 10 分 02 秒。
本书知识图谱见文中配图,原图地址:https://www.jiangtian.top/zb_users/upload/kg/agent-pitfalls-map.png
发表评论: