
多数"多智能体"只是一张工作流图换了壳
阅读方式:微信读书网页版,从版权页翻到第 8 章末,共 734 屏、8 章、14 分 25 秒。 八章:系统概述、认识大模型、提示词工程、RAG、记忆模块、规划能力、多智能体系统、案例实战。
书名是"构建多智能体协同系统",734 屏,是我这批里第二厚的一本。
读完它,我最想分享的是第 7 章里的一句"泄底":
"就现阶段而言,绝大多数的智能体应用是基于工作流开发的。"
这句话写在讲"多智能体"的那一章里。作者刚介绍完讨论式协作,转头就承认:真正跑在生产上的,基本都是流程图。
我认为这句比整本书的技术内容都值钱。因为它把"多智能体"这个词的光环摘掉了。
一、三种协作,只有一种在真干活
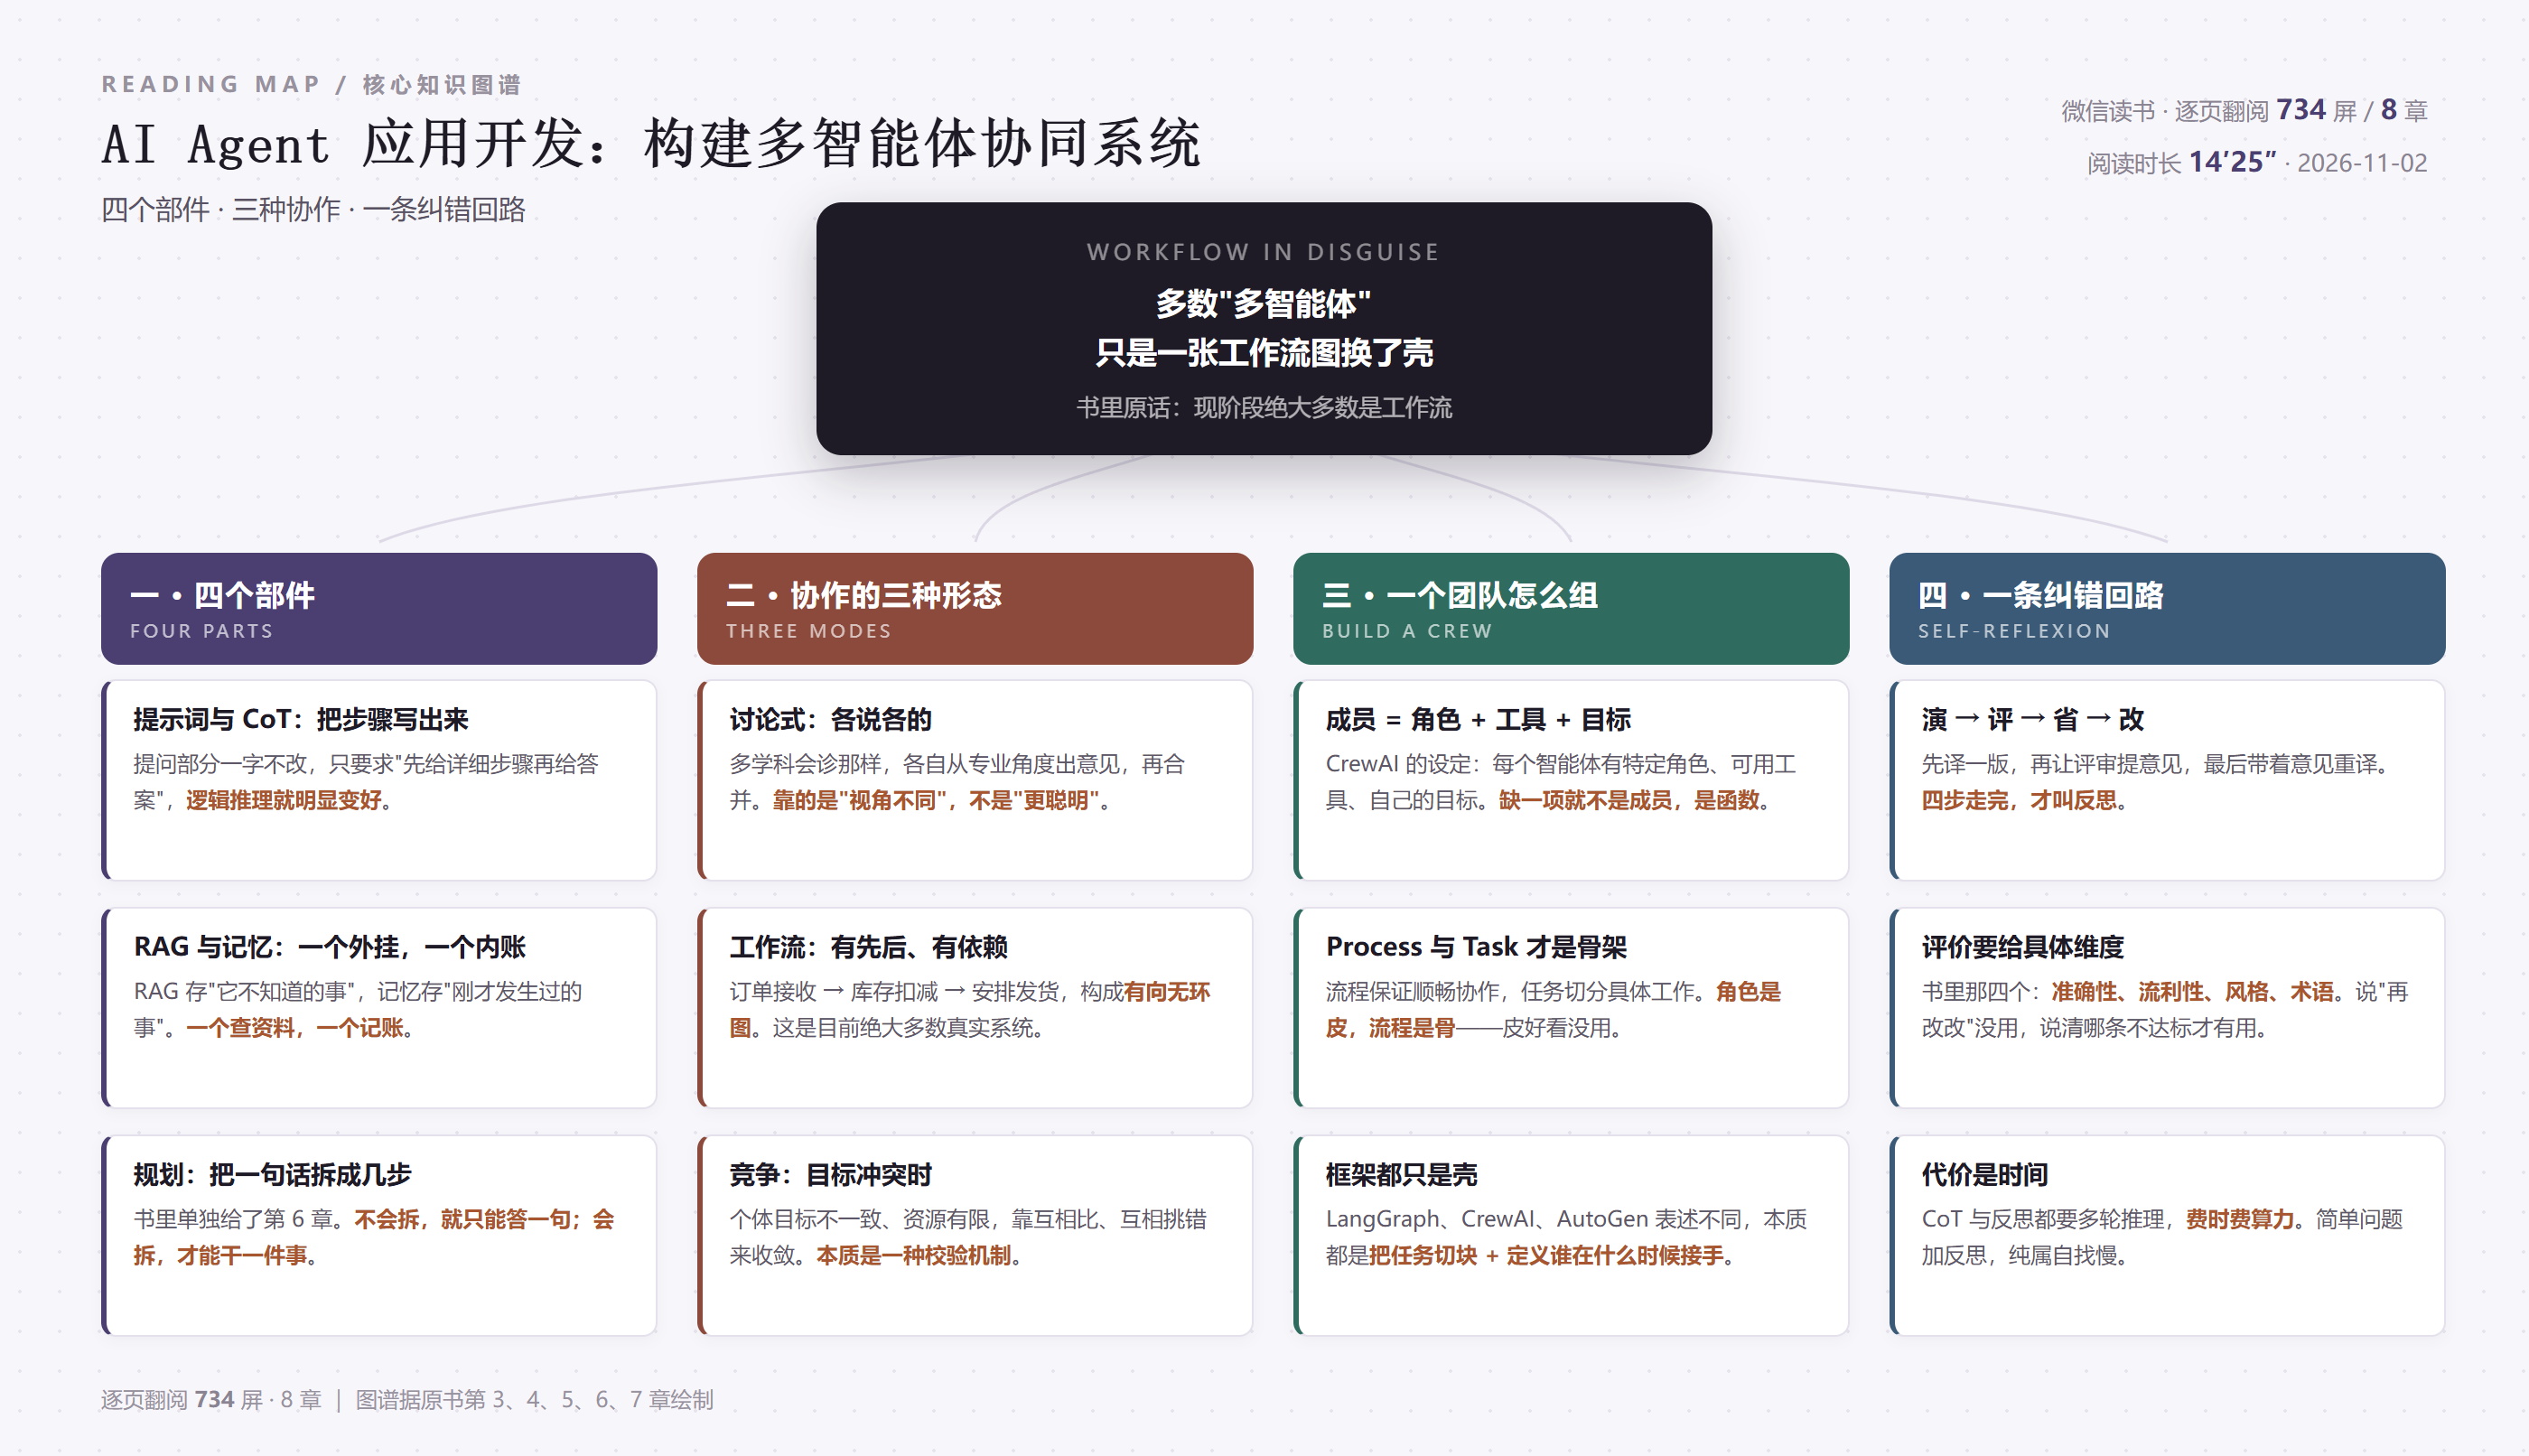
书里把智能体之间的协作关系分成三种:讨论式、工作流、竞争。
讨论式是多方交换意见,书里举的例子是医学诊断——不同专业的智能体分别从影像、遗传、药理的角度给判断,再汇总给医生。它的价值在于视角不同,而不是每个都更聪明。
工作流是固定先后与依赖。书里举的例子很具体:电商订单系统里三个智能体——订单接收(从各渠道收集信息)→ 库存管理(查仓、扣减)→ 发货(按库存信息和地址安排物流)。三者构成一张有向无环图。
竞争发生在个体目标冲突、资源有限的时候。
这三种里,只有工作流是"可预期"的。讨论式的输出不稳定,竞争式的收敛条件难定义。所以作者那句"绝大多数是工作流",本质上是在说:大家嘴上讲协作,手上画的还是流程图。
而这未必是坏事。我在别的书里也读到过类似的判断——能画成图的东西才管得住。真正麻烦的是那种"看起来很智能、出了问题没人说得清哪一步"的系统。
二、四个部件里,记忆和规划最容易被跳过
前六章讲的是单个智能体的装备:提示词、RAG、记忆、规划。
其中记忆(第 5 章)和规划(第 6 章)各自独立成章,这个安排在同类书里不多见——大部分书把这两件事塞进"上下文管理"里一笔带过。
为什么它们重要?我用一句话概括:记忆决定它能不能接着干,规划决定它能不能干完。
没有记忆,多轮对话就是每次重新自我介绍;没有规划,遇到"帮我把这份材料整理成周报"这种活,它只能给你一段泛泛的话,而不是"先读、再摘、再按模板填"。
第 3 章讲提示词时有个细节,我认为是全书最"便宜"的一招。作者拿一道算术题举例(食堂 23 个苹果,用掉 20 个又买 6 个),然后说:
"整体提示词的提问部分都无须修改。这样一种简单的提示词修改技巧,就能显著提高大模型的逻辑推理能力。"
改的是什么?只是加了一句"请先给出详细解决步骤,再给最终答案"。
这就是 CoT(思维链)。它的成本是零,收益是让模型把中间步骤写出来——写出来,你才能看出它哪一步错了。
书里对 CoT 为什么有效给了解释,我记住的是两条:一是注意力强化(示例里的步骤激活了相关的神经元参数),二是把复杂问题拆成中间步骤,让每一步都变简单。
而它的代价也写得清楚:涉及多个推理步骤,会增加推理时间和计算资源的额外消耗,复杂问题上尤其明显。
所以 CoT 不是"加上就更好",是一道用时间和 token 换准确率的交易。简单问题加思维链,纯属自找慢。
三、一个"团队"到底由什么组成
第 7 章讲多智能体,重点介绍了 CrewAI 这个框架。它的模型很直观,一共四个词:
团队(Crew)负责整体运营;
成员(Agent)是团队里的一个个智能体,各有特定的角色、工具、目标;
流程(Process)保证成员之间顺畅协作;
任务(Task)是要完成的具体工作。
这四件里,我认为最容易被误解的是第一件——角色。
很多人搭多智能体,第一步就是给每个智能体起个好听的角色名:"资深分析师""创意总监""严谨的审稿人"。然后发现效果没什么变化。
原因在书里那句话的另外两个词上:工具、目标。
光有角色没有工具,它就是个会自我介绍的模型;光有角色没有目标,它不知道自己什么时候算干完。角色是皮,工具和目标才是肉。
而流程才是骨。书里说得很清楚:流程保证成员之间顺畅协作。 换句话说,你把三个智能体放在一起,如果没有定义"谁先谁后、谁的输出给谁",那不叫协作,叫各干各的。
所以框架之间的差别其实没那么大。LangGraph、CrewAI、AutoGen,表述不同,本质是同一件事:把任务切块,再定义谁在什么时候接手。 学会一个,其余的看半天文档就能上手。
四、唯一值得学的"智能":会自己改一版
第 6 章讲规划,最后落到 Self-Reflexion(自我反思)上。书里给的例子是翻译,流程四步:
演(actor)——先译一版;
评(evaluate)——让评审提意见;
省(reflection)——把意见整理成"哪里不对";
改——带着原文、初译、意见,重新译一遍。
书里那段 prompt 写得很讲究,它把"评审要评什么"固定成了四条:
准确性(更正添加、误译、遗漏或未翻译文本的错误)
流利性(应用英语语法、拼写和标点规则,确保没有不必要的重复)
风格(确保翻译反映源文本的风格并考虑到文化背景)
术语(不适合上下文,使用不一致)
这四条是整段设计的关键。因为如果你只说"再改改",模型只会给你换几个同义词;说清"哪一条不达标",它才知道往哪个方向改。
我认为这套结构可以搬到几乎所有场景:写作、代码、方案。反思的价值不在"反思"这两个字,在于你有没有能力把"不好"拆成几条可检查的标准。
而这也是我认为整本书最深的一层:所谓智能体的"自我改进",其实是你把自己的评价标准写清楚了,它照着改。 标准说不清,反思就是空转。
五、这本书的短板
一是厚度与信息量不成比例。 734 屏里,第 2 章"认识大模型"(讲 Transformer、注意力机制)和第 3 章"提示词工程"占了将近三百屏,但内容与市面通识材料高度重合。真正独有的东西,集中在第 5、6、7 章。
二是框架讲解版本绑定太强。 CrewAI 那节连源码解析都写了。这类内容半年就会过时,而它占了第 7 章的大半。读者真正该带走的是那四个词(团队/成员/流程/任务),不是那段代码。
三是案例章(第 8 章)偏演示性质。 734 屏只留一章做实战,且案例规模偏小。书名承诺"协同系统",但真正跑起来的协同案例只有一两个。
它的优点是:敢在讲"多智能体"的章节里,承认大多数系统只是工作流。 这种自我泄底,在一堆把 Agent 讲成科幻的书里,显得格外可靠。
六、一句话
"多智能体协同"听着像一群 AI 开会,实际上多数时候就是一张图:几个方框、几条箭头,每个方框里换成了一个会说人话的模型。 这不丢人——能画成图,说明你想清楚了谁干什么、谁给谁。真正该练的不是"怎么让它们自由讨论",而是怎么把任务切开、把评价标准写清。前者靠运气收敛,后者每一次都收敛。
阅读记录:微信读书网页版逐页翻阅,734 屏 / 8 章 / 14 分 25 秒。
本书知识图谱见文中配图,原图地址:https://www.jiangtian.top/zb_users/upload/kg/multi-agent-collab-map.png
发表评论: