
《AIGC绘画创作》读书笔记:单张好看靠抽卡,批量一致靠工程
阅读方式:微信读书网页版,从版权页翻到第 15 章末,共 788 屏、15 章、14 分 57 秒。 三部分:基础入门(MJ 与 SD 各自的机制)、Midjourney 案例、Stable Diffusion 案例。
这本书和之前读的《AI 绘画与摄影实战 108 招》看起来撞题,其实不是一类。
108 招解决的是"怎么写出对的词";这本解决的是"怎么稳定地出同一张脸"。
一句话区分:前一本教你抽卡出好图,这一本教你流水线出图。
一、Midjourney 和 Stable Diffusion 不是竞品
很多人把这两个当"哪个更好"来比。这本书的处理更实际——它把两者放在一条工作流的两端。
Midjourney 的强项是"审美"。 它是个托管服务,你写提示词,它出图,默认就好看。你不用管模型、不用管显卡、不用管参数。
代价是不可控。你没法精确地说"左手再抬高五度"、"这个 Logo 往左移两厘米"。它给的是"感觉对"的图,不是你脑子里那张图。
Stable Diffusion 的强项是"控制"。 它跑在本地,大模型、VAE、LoRA、ControlNet 全都能换、能叠、能调。你可以把构图、姿势、结构全部约束死。
代价是门槛。第 3 章光讲安装和界面就花了 70 多屏,从启动器依赖到整合包、从扩展插件到模型预览图。这一段对新手很不友好,但它恰恰说明了 SD 的定位——它是个工具,不是个服务。
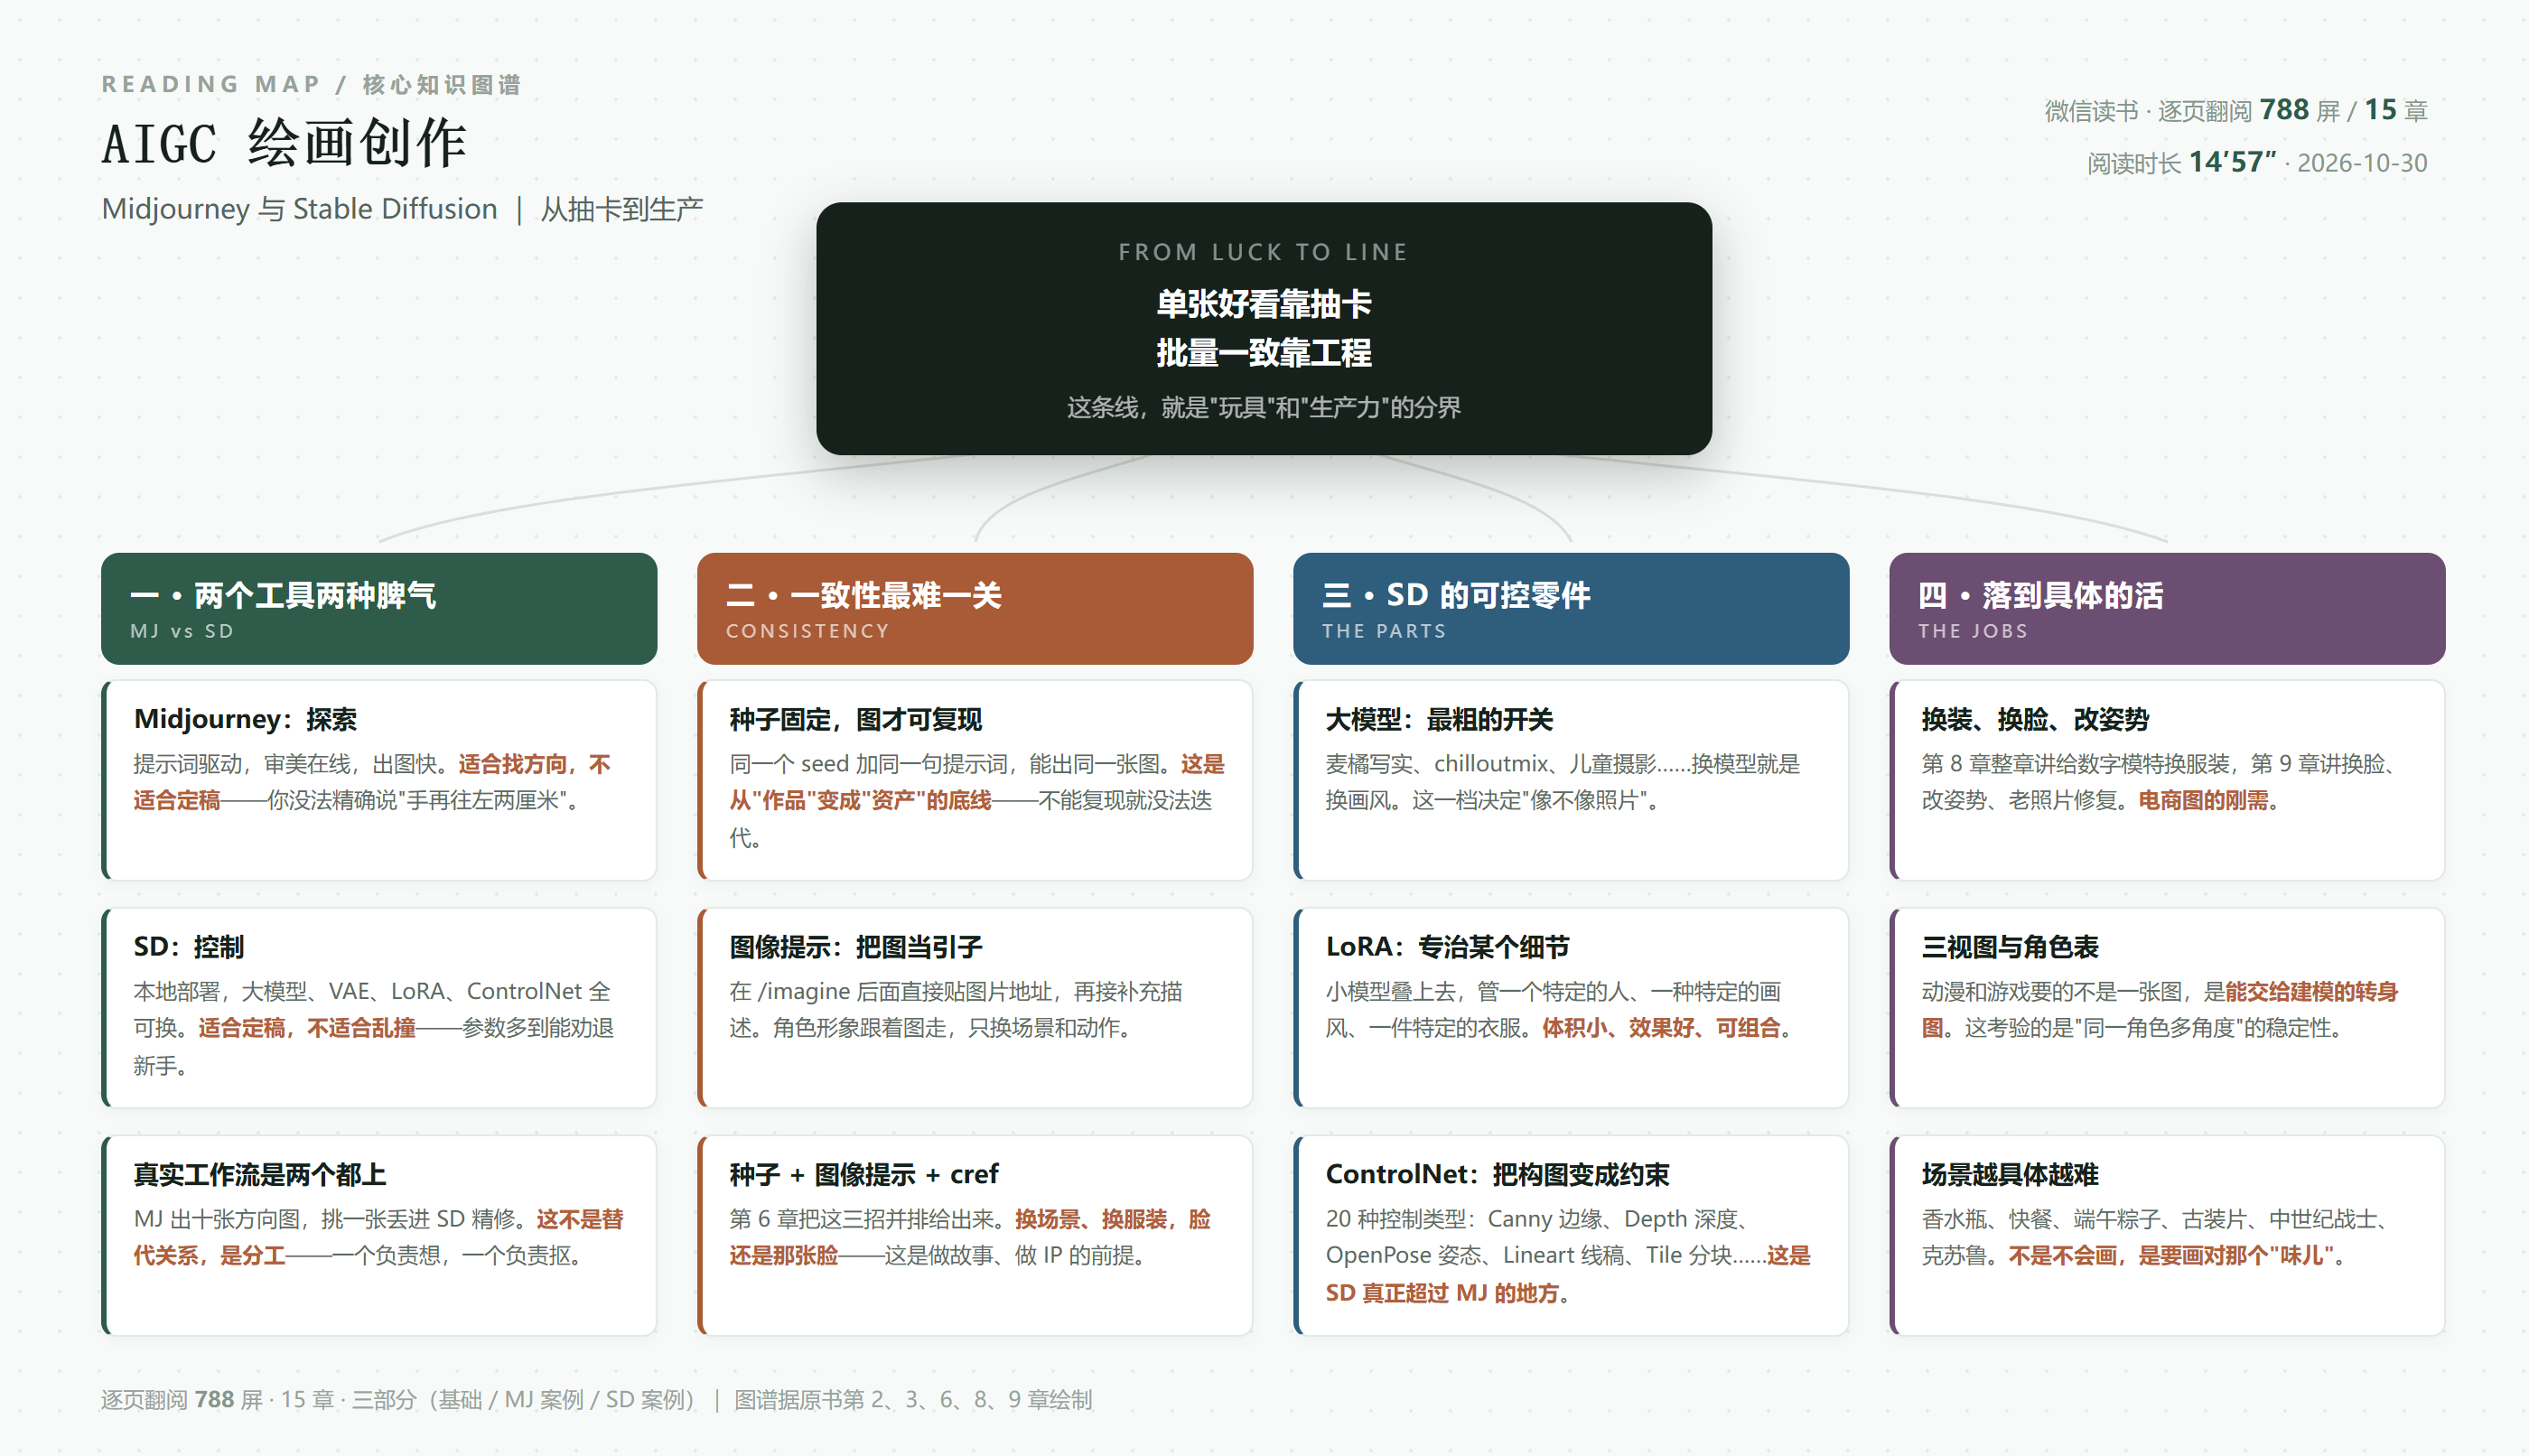
所以真实的工作流往往是:MJ 出十个方向,挑一个丢进 SD 精修。 一个负责想,一个负责抠。
二、一致性:从"作品"到"资产"的那道坎
这本书我认为最值钱的是第 6 章:讲述故事的图像力量。
这一章要解决的问题很具体:我要做一个故事、一个 IP、一套角色,怎么让同一个人在不同场景里还是同一个人?
AI 绘画最初的痛点就在这里。你出一张很满意的图,想让她换身衣服、换个场景,结果一改提示词,脸全变了。单张能看,成套就崩。
作者给了三招,一层比一层稳:
第一招,图像提示。 在 /imagine 后面直接贴图片地址,再接补充描述。这样模型会参考那张图的形象,只改你新加的部分。
第二招,种子 + 图像提示。 种子值固定了"起点",图像提示固定了"长相"。两个一起用,一致性明显提升。
第三招,cref 参数。 Midjourney 的角色参考功能。它专门用来"锁脸"——换场景、换服装、换姿势,人物还是那个人。
这三招的意义,我觉得不在技巧本身,在于它标记了一个转折:AI 绘画从"生成一张图"进入了"维护一个角色"。
前者是作品,后者是资产。而资产才需要一致性。
三、SD 的三层控制
第 3 章讲 SD 的界面参数,密密麻麻列了十几项。我把它压成三层,从粗到细:
第一层,大模型——决定"像什么"。 麦橘写实、chilloutmix、儿童摄影_V1.0……这些名字看着像黑话,其实是不同的"画风包"。换一个大模型,出图的整体质感就变了:是照片感、是插画感、是二次元。
这是最粗的一档开关,也是最有效的一档。很多人调半天提示词没效果,其实该换模型。
第二层,LoRA——决定"这个特定的东西"。 LoRA 是个小模型,叠在大模型上面,专门管一件事:某个特定的人、某种特定的画风、某件特定的衣服。
它的好处是体积小、效果好、能组合。你可以同时挂一个"人脸 LoRA"和一个"服装 LoRA",各管一摊。
第三层,ControlNet——决定"结构"。 这是 SD 真正超过 MJ 的地方,下面单独说。
四、ControlNet 的 20 种控制,本质是在问"你想约束什么"
书里对 ControlNet 的定义很清楚:
"ControlNet 是 Stable Diffusion 的一个扩展插件,它通过添加额外的条件来控制 AI 图像生成过程,从而极大地增强了 Stable Diffusion 在图像生成方面的灵活性和精确度。"
然后它列出了 20 种控制类型。这个清单我抄下来,因为它比任何教程都直观:
Canny(硬边缘)、Depth(深度)、IP-Adapter、局部重绘、InstantID、InstructP2P、Lineart(线稿)、MLSD(直线)、NormalMap(法线贴图)、OpenPose(姿态)、Recolor(重上色)、Reference(参考)、Revision、Scribble(涂鸦)、Segmentation(语义分割)、Shuffle(随机洗牌)、SoftEdge(软边缘)、SparseCtrl(稀疏控制)、T2I-Adapter、Tile(分块)
这二十个名字,其实是在回答同一个问题:你想约束画面的哪一部分?
想固定轮廓,用 Canny 或 Lineart。
想固定姿势,用 OpenPose。
想固定空间纵深,用 Depth。
想固定语义分区(哪里是天、哪里是地),用 Segmentation。
想只改一小块,用局部重绘或 Inpaint。
想保住脸,用 InstantID 或 IP-Adapter。
我读到这里才真正理解 ControlNet 的意义:它把"构图"从一句形容词,变成了一个可以输入的约束。
在 MJ 里,你说"一个人站在窗边",它给你一张它理解的图。在 SD + ControlNet 里,你给它一张线稿,它必须按那个轮廓画。前者是许愿,后者是施工。
五、后半本的案例,暴露了真实的难度
第 7 到 15 章是 SD 的案例集:虚拟数字人、给模特换装、人物图像处理(模糊变清晰、黑白线稿上色、卡通转真人、换脸、改姿势)、动漫三视图、游戏场景与道具、小说推文配图、电商广告、影片场景、建筑与室内设计。
这些案例看下来,我发现一件事:难度不在"生成",在"对齐"。
生成一张漂亮的图,现在谁都会。难的是生成一张符合要求的图——衣服的颜色必须统一、三视图必须是同一个人、古装片必须有那个年代的味道、香水瓶必须是那个牌子的形状。
书里最有价值的其实是那些"翻车与修正"的段落:第一次出来的颜色不对,怎么加 LoRA 调;脸变了,怎么用 ControlNet 锁;构图散了,怎么用 OpenPose 定。
这些段落不好看,但它们是真实的活。
六、这本书的短板
一是安装部分过重。 第 3 章讲 SD 安装、启动器、整合包、插件、模型放哪,占了大量篇幅。这些内容半年就过期,而且现在有一键包,照着做反而绕。
二是版本时效。 书里用的是 SD 1.5 时代的生态(麦橘、chilloutmix 这些模型),MJ 讲的是 V5/V6 之前的参数体系。现在这两边都换代了。
三是案例的"可迁移性"弱。 每个案例都是"提示词 + 参数 + 出图结果"的三段式,你能照抄,但换到自己的需求上,还是得重来一遍。它给的是示范,不是方法。
但它有一个很实在的优点:它敢把"一致性"这个问题摆到台面上讲。 大部分 AI 绘画书都在教你怎么出好看的图,只有它认真讲了"怎么让同一个人出现十次还是同一个人"。
这个问题,才是从玩到用的分水岭。
七、一句话
会写提示词,能出好图;能锁住一个角色、能约束一个构图、能复现同一张脸,才能接活。前一件事靠感觉,后一件事靠工程。 这本书讲的,就是那道坎怎么过——种子管复现,图像提示管长相,LoRA 管细节,ControlNet 管结构。
至于"哪个工具更好"这种问题,读完就不想问了:一个是笔,一个是尺。你不会问笔和尺哪个更好。
阅读记录:微信读书网页版逐页翻阅,788 屏 / 15 章 / 14 分 57 秒。
本书知识图谱见文中配图,原图地址:https://www.jiangtian.top/zb_users/upload/kg/aigc-paint-map.png
发表评论: