
《AIGC辅助数据分析与挖掘》读书笔记:取数归零之后,问什么成了门槛
阅读方式:微信读书网页版,从版权页翻到第 8 章末,共 633 屏、8 章、12 分 12 秒。 四部分:AIGC 基础与 Prompt 方法、Excel、SQL、Python。后三部分的结构完全一样——先讲方法,再给三个实战案例。
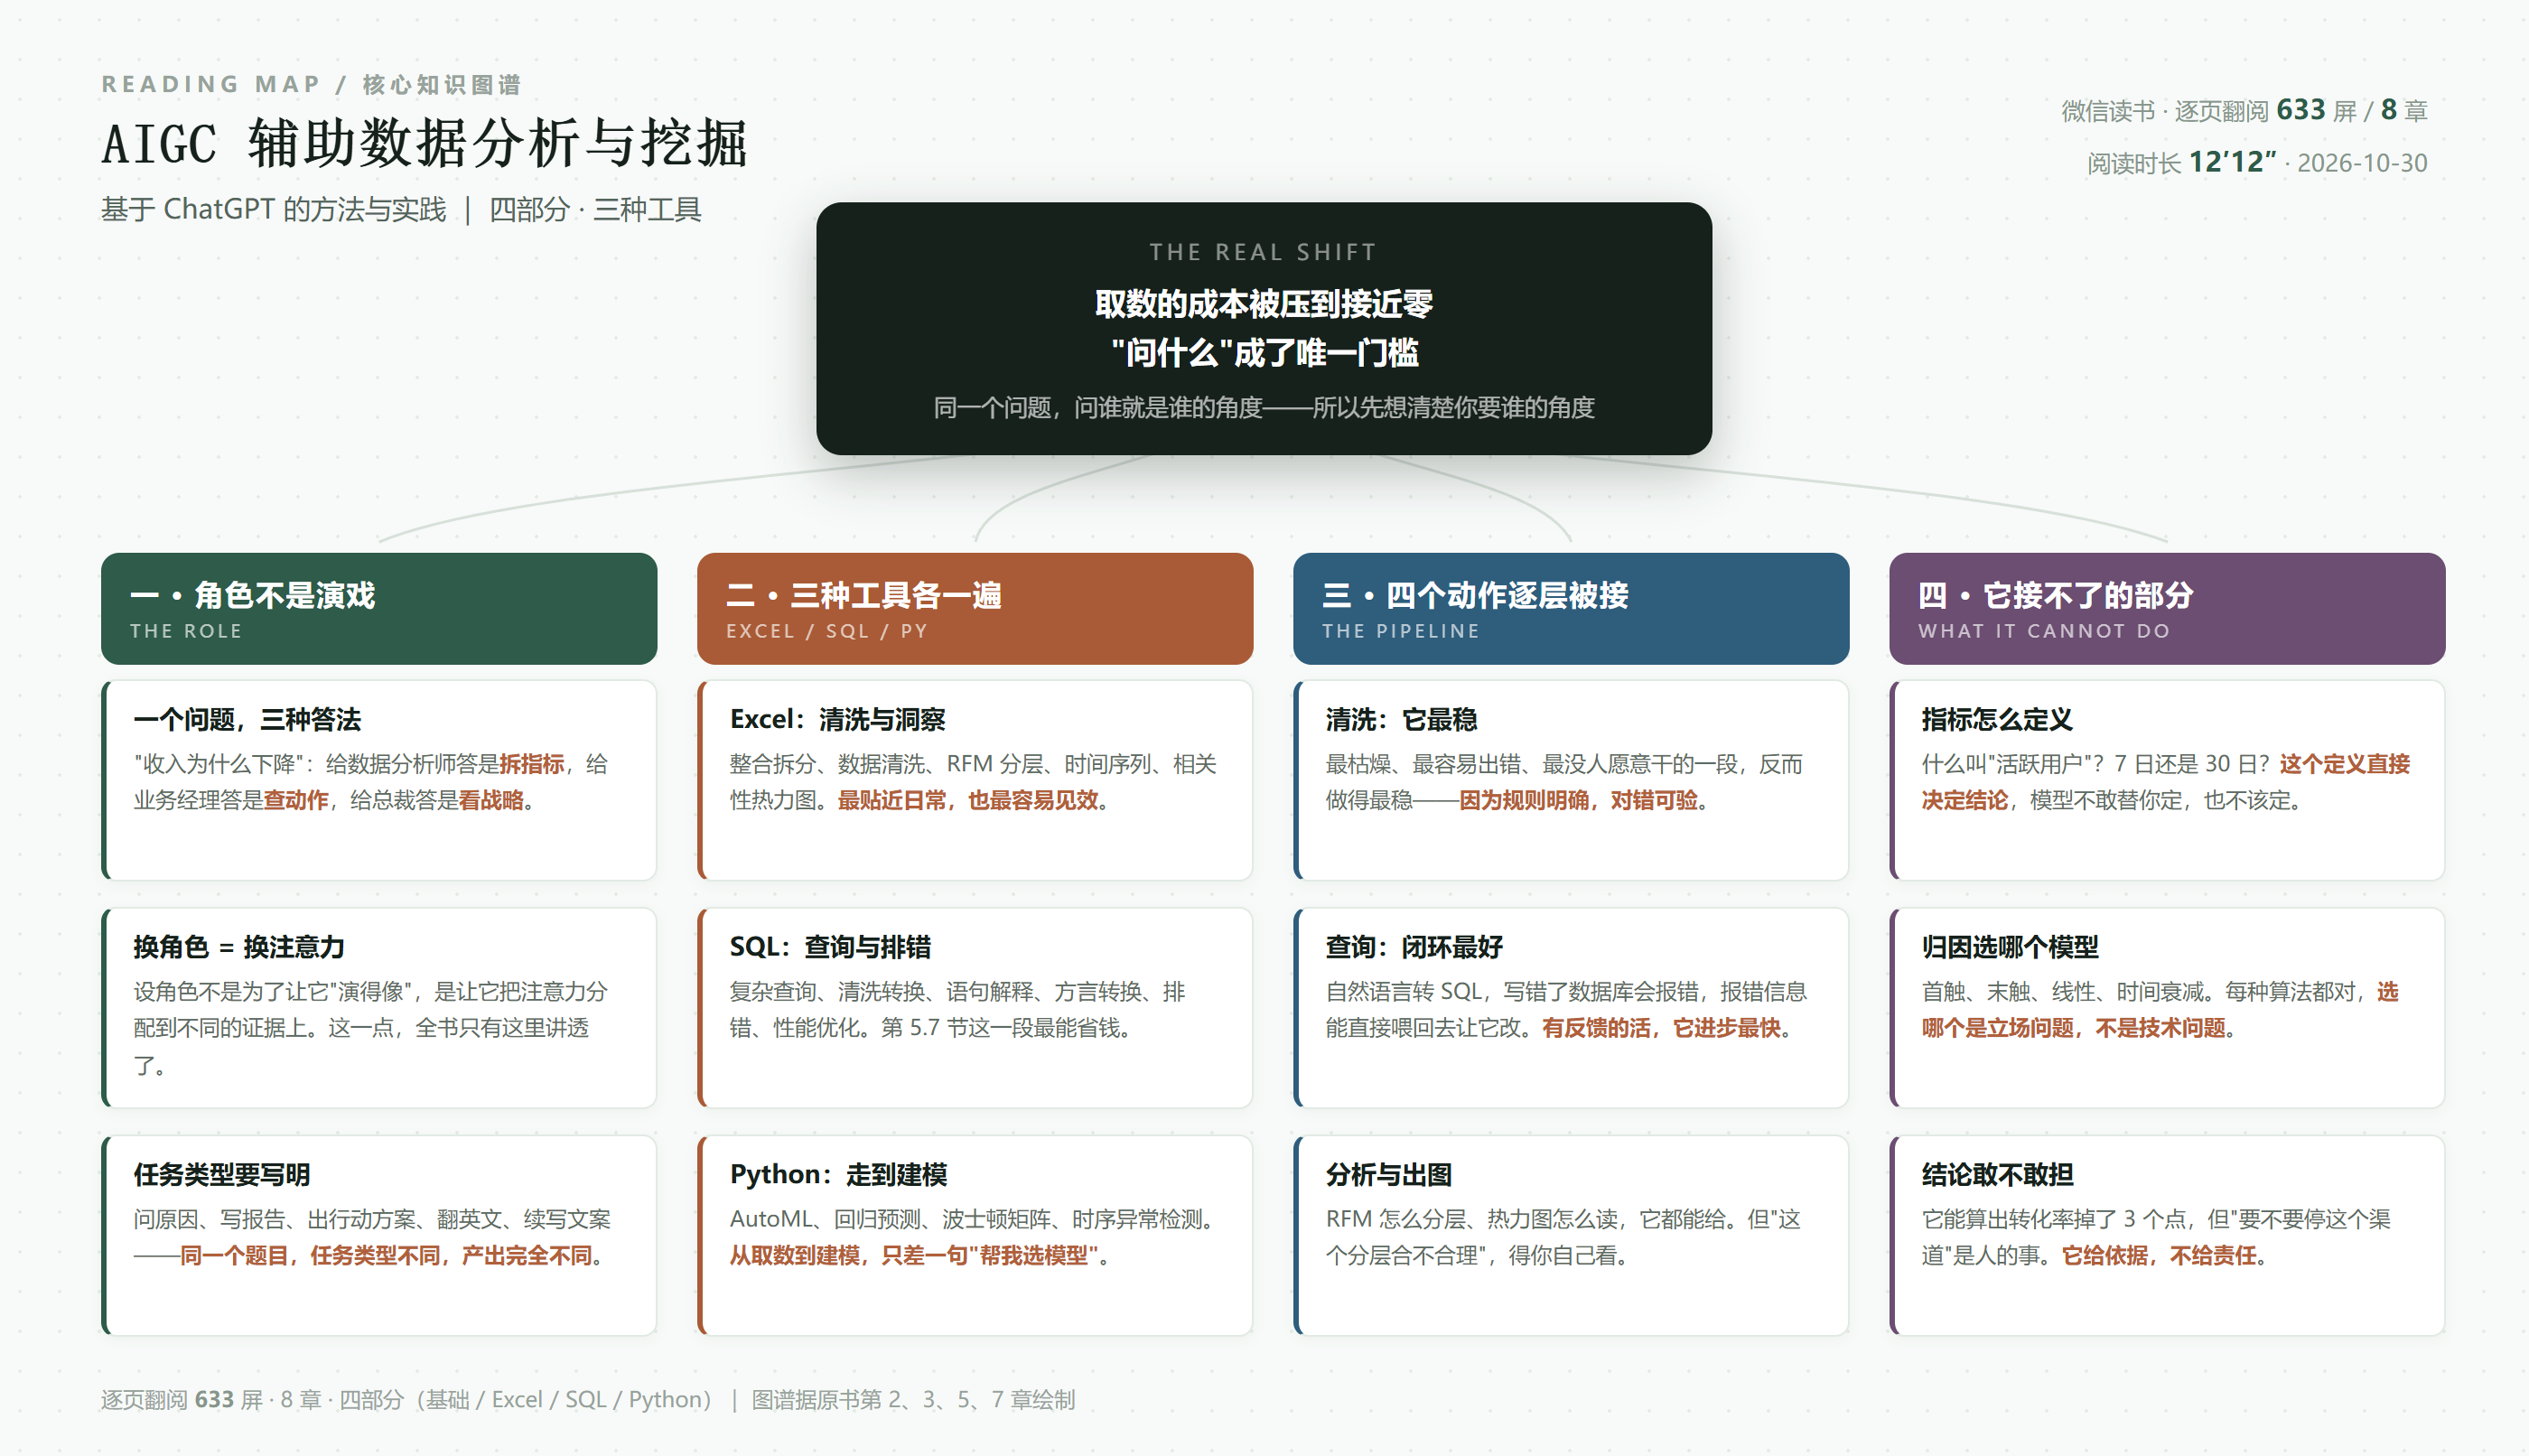
这本书有意思的地方在于它的结构本身就是个论点:同一套方法,在 Excel、SQL、Python 里各走一遍。
它想说明的是:工具不是门槛,方法才是。 你换了工具,方法照用。
我读完的判断比它更进一步:方法也不是最终门槛,"知道该问什么"才是。
一、全书最好的一页:一个问题,三个角色
第 2 章讲 Prompt 结构,讲到"角色设定"这一节时,作者没有停在"你要让 AI 扮演专家"这种空话上。
他拿同一个问题——"收入为什么下降"——写了三个 Prompt:
我需要你扮演数据分析师,你的工作职责是详细分析"收入为什么下降"这一问题,然后从数据层面进行分析,找出收入降低的原因、影响和趋势,并提供数据支持的解决方案。
我需要你担任业务经理,你的主要任务是从业务层面进行分析,找出收入降低的业务动作、运营策略以及部门协作等方面的因素,并提供业务解决方案。
我想让你担任数据总监,你的主要任务是从战略层面进行分析,找出收入降低的内部资源支持、企业总体经营战略和行业发展趋势等方面的因素,并提供战略解决方案。
这三段,把"角色设定"这件事讲透了。
注意它们的差别不在"身份",在证据来源:分析师看指标,业务经理看动作,总监看资源和趋势。角色设定真正做的,是给模型分配注意力。
我以前一直觉得"你是一个资深 XX 专家"这类开头是玄学。看完这三段才明白:它不是让模型演得像,而是告诉它去哪找原因。
顺着这个逻辑,作者在下一节讲"任务类型",也给了同样的示范——同一个"收入为什么下降":
"请分析'为什么收入下降'的原因,并生成一份详细报告。" / "请对'为什么收入下降'进行分析,并提出一份业务行动计划。" / "请创建'为什么收入下降'的文章大纲。"
同一个问题,要"报告"就要结构,要"计划"就要动作,要"大纲"就要层次。任务类型不明,它只能给你一篇四平八稳的分析——那种看起来全面、其实什么也没说的东西。
二、四个动作,逐层被接走
数据分析这件事,拆开只有四步:清洗、查询、分析、可视化。这本书的四部分,其实就是这四步在三种工具里的展开。
清洗最枯燥,反而被接得最彻底。 第 3.5 节讲 AIGC 让 Excel 数据清洗更智能,第 5.5 节讲 SQL 的清洗与转换,第 7.5 节讲 Python 的自动化数据处理。
为什么这一步接得最彻底?因为规则明确,对错可验。 空值怎么补、日期格式怎么统一、重复行怎么去重——这些都是有标准答案的活。模型最擅长的,恰恰是有标准答案的活。
查询的闭环最好。 第 5.4 节"AI 解决 SQL 复杂查询之谜",第 5.7 节更进一步,讲 SQL 的解释、转换、排错、性能优化。
这一段的体验特别顺,原因很实在:SQL 写错了,数据库会报错。 报错信息可以原样喂回去让它改。有反馈的活,它进步最快——这是所有"能自我纠错"的任务的共同点。
分析开始需要你了。 第 4 章用 RFM 做客户分层、时间序列看增长规律、相关性热力图找 KPI 之间的联系。这些方法它都懂,模型也知道 F 是频率、M 是金额。
但"分几层"这个决定,它给不了。 三层还是五层?阈值定在哪?这是业务判断,不是技术问题。书里给的例子是标准做法,落到你的业务上要改。
建模是它走得最远的一步。 第 7.6 节讲 AIGC + AutoML,第 8 章直接给三个实战:回归预测广告效果、波士顿矩阵分析商品、时序异常检测做 KPI 监控。
到这一步,它的角色从"帮你写代码"变成了"帮你选模型"。这个转变挺关键的——AutoML 已经把"选模型"这件事本身自动化了,AI 只是又包了一层自然语言。
三、它接不了的三件事
这本书没有专门写一节讲"AI 做不了什么",但从内容里能读出来。我总结成三条,这三条恰恰是数据分析师真正的价值所在。
第一,指标怎么定义。 "活跃用户"是 7 日活跃还是 30 日?"有效订单"要不要排除退款?
这类定义,模型不敢替你定,也不该定。因为定义一变,结论就变。 你说"留存下降了",老板问"哪个口径的留存",答不上来就白干。而 AI 会按最通用的口径给你算——通用口径往往不是你业务的口径。
第二,归因选哪个模型。 第 6.2 节讲"复现归因报表,揭示真实转化贡献"。归因模型有首触、末触、线性、时间衰减好几种,每种算法都没错。
但选哪个是立场问题,不是技术问题。 首触归因把功劳给拉新的渠道,末触归因给促成交的渠道。你选哪个,取决于你要向谁交代。这件事,模型只能列出选项。
第三,结论敢不敢担。 它能算出某渠道转化率掉了 3 个点,能画出趋势图,能给出"建议降低投放"。
但"要不要真的停"——这涉及预算、涉及部门、涉及谁签字。它给依据,不给责任。
这三条有个共同点:都不是技术判断,是业务判断。 而这正好是这本书的结构所暗示的——它用四部分讲完了所有技术动作,留给"判断"的部分,其实一句话也没讲,因为讲不了。
四、这本书的短板
一是案例的"业务厚度"不够。 广告渠道评估、归因报表、留存报表、波士顿矩阵——这些案例的方法都是标准的,但业务背景被压缩得很薄。你照着做能跑通,但换到自己的场景,还是要重新想一遍。
二是 Prompt 部分偏长。 第 2 章从 2.1 写到 2.9,讲了结构、要素、最佳实践、精调示例、构建工具、常见问题。信息密度不高,核心就是"角色 + 任务 + 上下文 + 格式"这四样加上举例。
三是时效。 书里的 ChatGPT 操作界面、模型版本、插件生态,现在都对不上了。这一层要打折看。
但它有个别人比不了的优点:它把"同一件事在三种工具里怎么做"摆在一起了。 这个对照非常有价值——你会发现 Excel 里的"数据透视"、SQL 里的"GROUP BY"、Python 里的"groupby",是同一件事的三种写法。而 AI 能帮你在这三种写法之间来回翻译。
五、一句话
以前数据分析师八成的力气花在取数和清洗上,只有两成用来想问题。AI 把那八成压到接近零之后,剩下那两成突然变成了全部。所以真正的变化不是"AI 会写 SQL 了",是"会写 SQL"不再是一项本事,"知道该查什么"才是。
这本书教的是前一半。后一半,得自己在业务里磕。
阅读记录:微信读书网页版逐页翻阅,633 屏 / 8 章 / 12 分 12 秒。
本书知识图谱见文中配图,原图地址:https://www.jiangtian.top/zb_users/upload/kg/aigc-data-map.png
发表评论: