
《AI Agent智能体与MCP开发实践》读书笔记:提示词讲道理,协议立规矩
阅读方式:微信读书网页版,从版权页翻到第 16 章末,共 747 屏、16 章、18 分 07 秒。 结构是教科书式的:前 6 章打地基(大模型演进、环境、微调、在线 API、RAG、架构设计),后 10 章是七个实战项目。
拿到这本书时我以为又是一本"Agent 入门到实战"。读到第 10 章,我改变了判断。
第 10 章的标题是《云上 MCP 服务的部署与使用》,第一节叫「stdio 与 SSE 传输协议」。整整一节,在讲两种传输方式的差别、各自的适用场景、以及为什么远程服务必须换成 SSE。
在一本讲智能体的书里,这是最"不性感"的内容。没有人会因为搞懂了 stdio 和 SSE 的区别而兴奋。但恰恰是这一节,让我觉得这本书和市面上那批"Coze 拖拽搭建"的书不是一类。
一、这本书的主角不是"智能体",是"协议"
作者王晓华是清华社的作者,写法很实。全书 16 章里,有三整章在讲协议:第 8 章 A2A、第 9 章 MCP 与应用、第 10 章云上 MCP。加上第 11、12 两章各做一个 MCP 服务实战,协议相关内容占了全书近三分之一。
这个配比说明了他的判断:智能体这个概念本身没什么新鲜的,新鲜的是"约定"。
一个能调工具、能多轮决策的程序,十年前就有,叫 workflow engine。它和今天 Agent 的差别不在"智能",在于今天有一批标准,让任何人写的工具能被任何人写的智能体调用。
作者在第 9 章给了一个很朴素的比喻:
"MCP 的问世,旨在攻克 AI 模型与外部数据源和工具之间错综复杂的连接难题。在过往的开发进程中,开发者常常需要为不同的数据源和工具量身定制连接方案,这不仅耗费大量的时间与精力,还极易导致代码的冗余和混乱。而 MCP 凭借其标准化的特性,犹如一把万能钥匙,巧妙地减少了开发者的重复劳动。"
"万能钥匙"这个说法有点过头,但方向是对的。MCP 真正解决的不是"能不能连",是"连一次要改几处代码"。
而 A2A 解决的是另一个层次的问题:智能体和智能体之间怎么说话。这一层比工具调用抽象一档,也更容易被忽略——因为大部分人做的项目里,只有一个智能体。
二、三道墙:为什么非得有协议
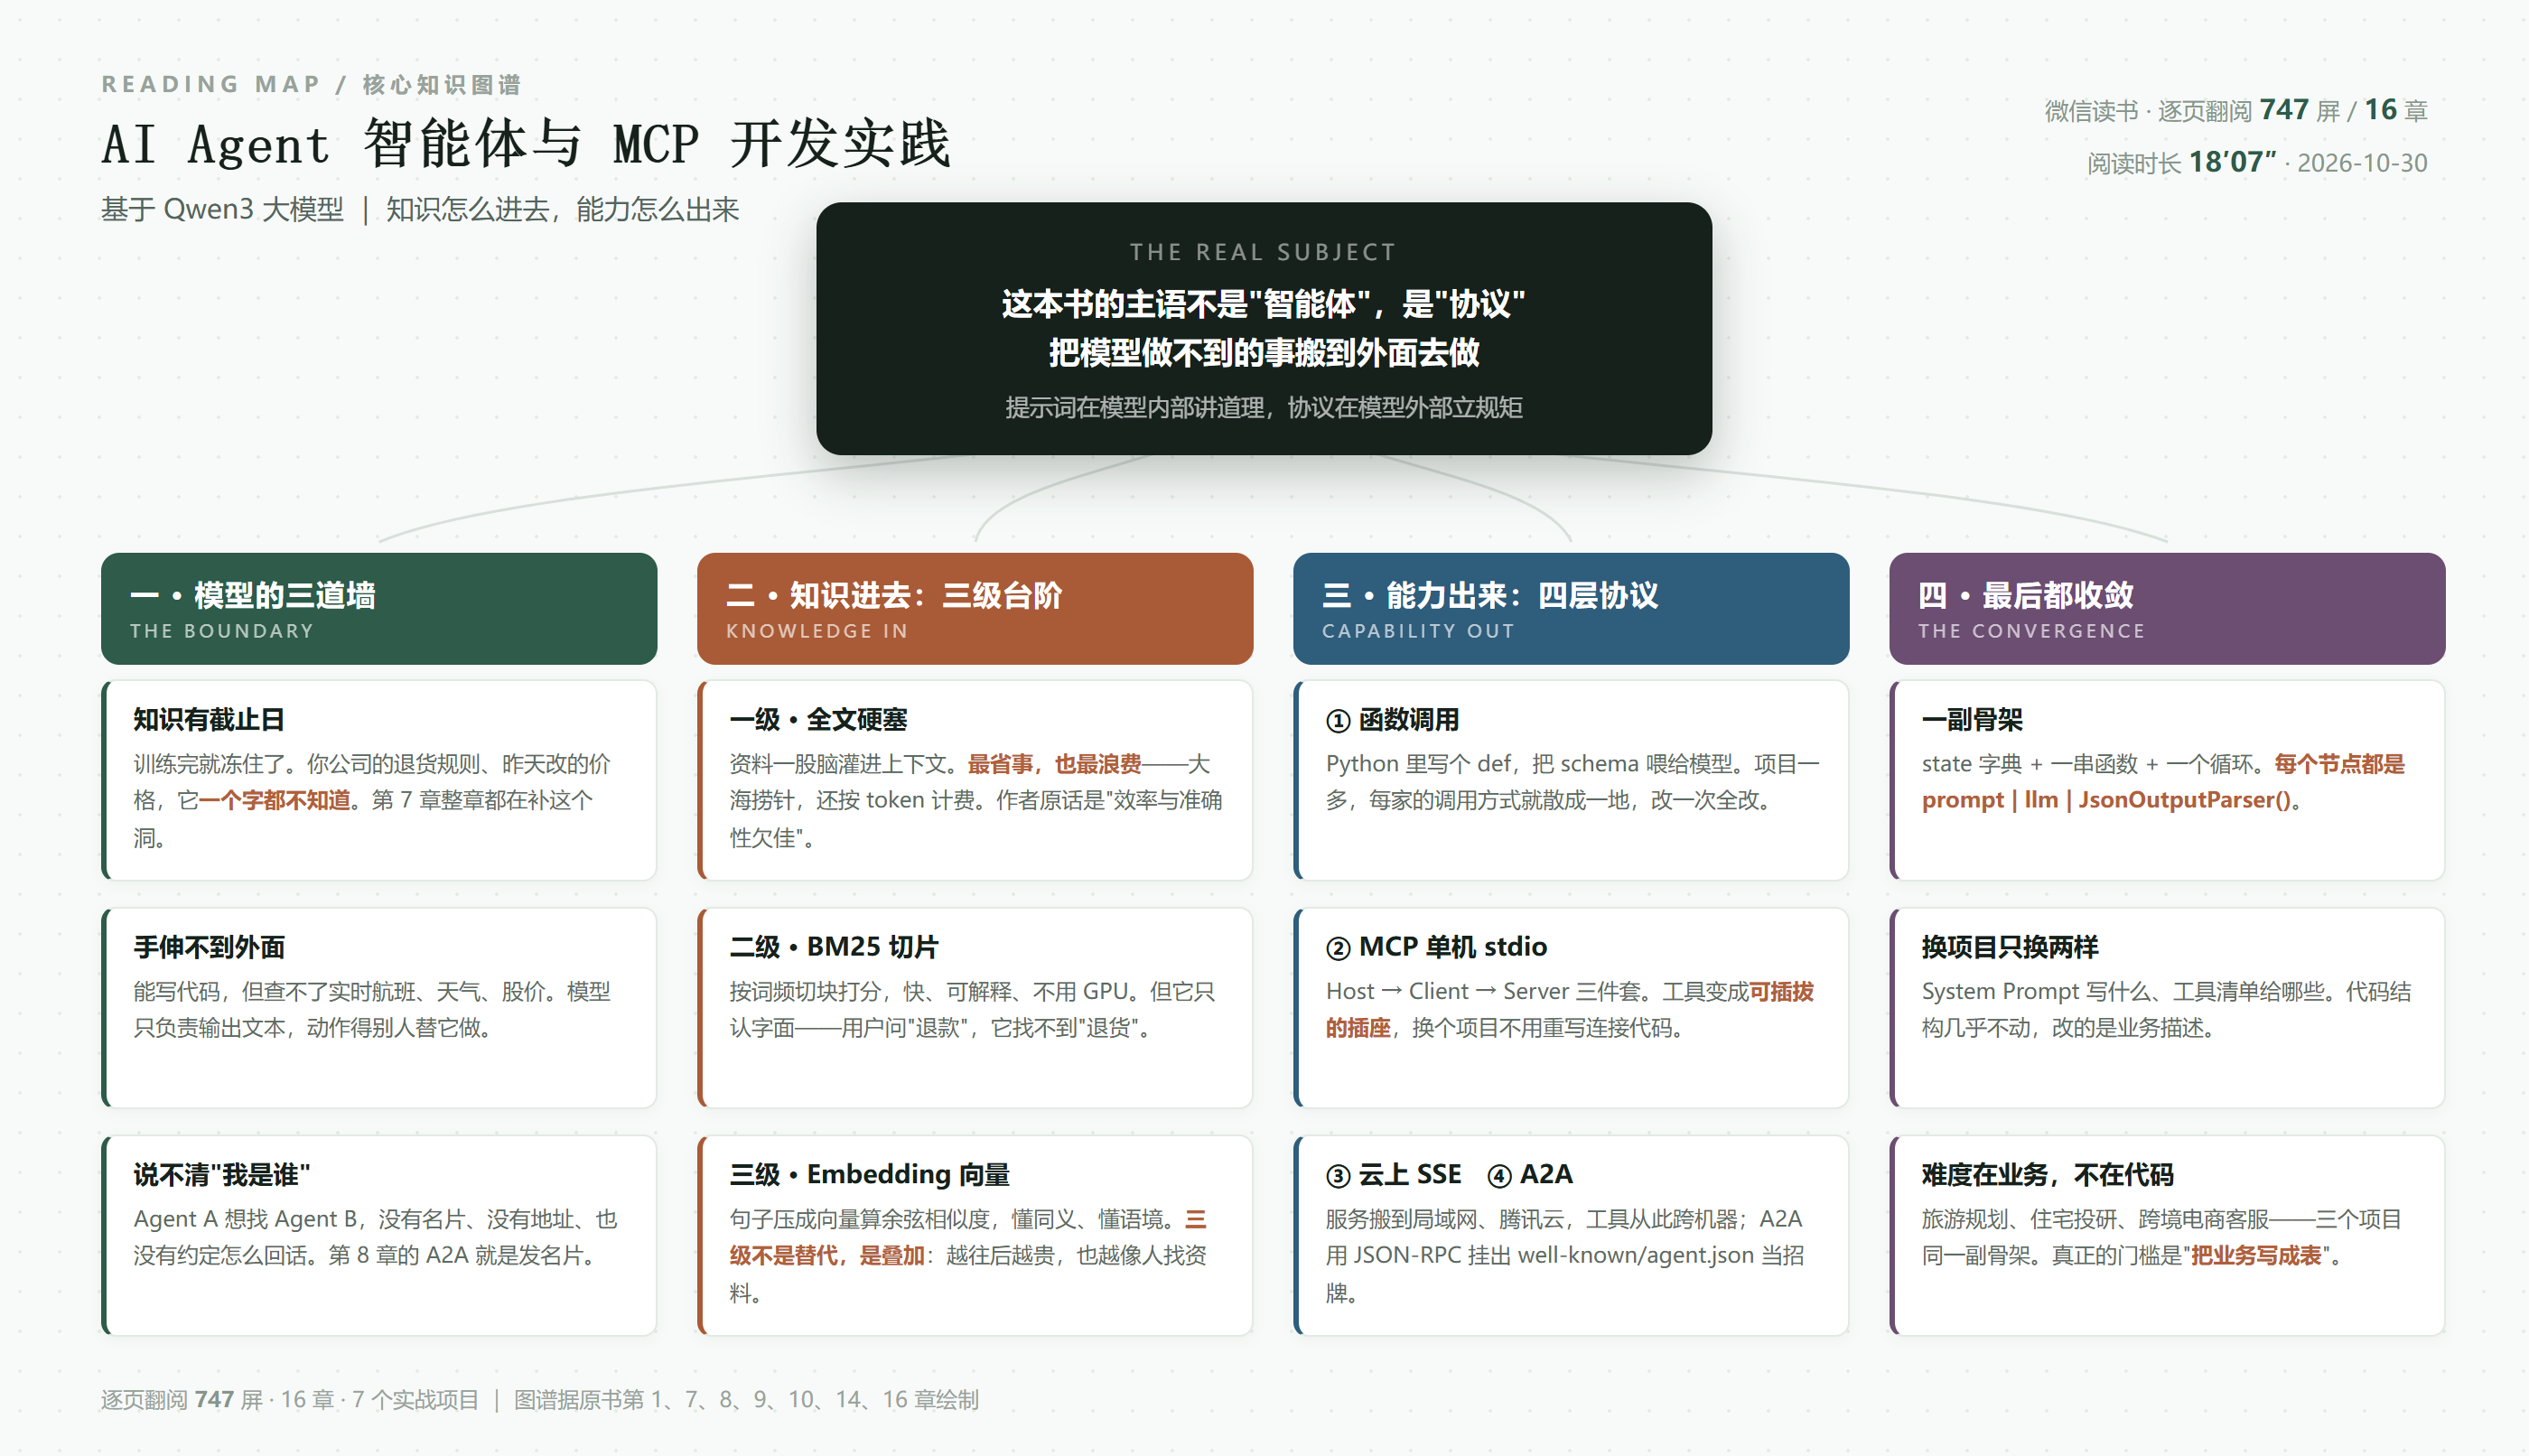
我把全书前 10 章的问题意识归纳成三句话。这三句话,也是三个章节存在的理由。
第一道墙:知识有截止日。 模型训练完就冻住了。你公司的退货规则、昨天改的价格、这个月新上的 SKU,它一个字都不知道。第 7 章整章都在补这个洞,用的办法就是 RAG。
第二道墙:手伸不到外面。 它能写代码,但查不了实时航班、天气、股价。模型只负责输出文本,"动作"得别人替它做。第 9、10 章解决这个。
第三道墙:说不清"我是谁"。 Agent A 想找 Agent B 帮忙,没有名片、没有地址、也没有约定怎么回话。第 8 章的 A2A 就是发名片。
这三道墙有个共同点:都是模型边界之外的事。 而边界之外的解决方案,几乎必然是协议,而不是更强的模型。这是这本书全篇的隐含论点,作者没明说,但从章节配比能读出来。
三、知识进屋的三级台阶(第 7 章,全书最实用)
如果只读一章,我推荐第 7 章的第 3 节:给交流客服 Agent 注入垂直领域知识。
这一节的高明之处在于,它不是直接教你"用向量数据库",而是把三种方法按能力递进摆出来,每一种都讲清代价。
一级台阶:全文硬塞。 把资料一股脑灌进上下文。操作最简,效果最差。作者的评价很直接:
"此方法简单直接,将涵盖垂直领域全面信息的完整文本资料,一股脑地输入智能客服系统的知识库中。其优势在于操作便捷,能快速将大量知识纳入系统。然而,其弊端也比较明显,全文本数据量庞大且缺乏结构化梳理,导致知识检索时如同大海捞针,难以精准定位用户所需信息,效率与准确性欠佳。"
二级台阶:BM25 切片。 按词频统计切块打分。这是搜索引擎用了二十年的老办法,快、可解释、不用 GPU。但它有一个致命短板,作者也写得很清楚:
"不过,BM25 算法主要基于关键词匹配,对文本语义的深度理解有限,面对语义复杂或存在歧义的查询时,排序结果可能不够理想。"
这句话翻译成业务语言是:用户问"我想退款",而文档里写的是"退货流程"——BM25 很可能匹配不上,因为它不认同义。
三级台阶:Embedding 向量。 把句子压成向量,算余弦相似度。懂同义、懂语境,代价是要模型、要算力、要一次性建索引。
关键在于,作者把这三者当成叠加关系而不是替代关系。书里的实际做法是:BM25 先粗筛,Embedding 再精排。这也是工业界的主流组合,不是二选一。
这一节我读完最大的收获不是技术,是一个判断标准:评估一套知识注入方案,别问它用了什么模型,问它"同一句话换个说法还能不能找到"。
四、工具出门的四层:从 def 到云
第 9 到 13 章是一条完整的升级路径,我把它们叠成四层。
第一层:函数调用。 Python 里写个 def,把 schema 喂给模型,模型返回要调哪个函数、传什么参数。第 9 章开头专门讲了"Python 调用工具的基本原理",然后才进 MCP。
这一层的痛点不是难度,是碎片化。每家模型有自己的一套调用格式,项目一多,改一次要改一片。
第二层:MCP 单机 stdio。 这一层引入三个角色,作者的分工讲得很清楚:
"从架构层面来看,MCP 主要由 Host(主机)、Client(客户端)和 Server(服务器) 三大部分构成。其中,客户端扮演着通信使者的角色,负责在 AI 模型与外部系统之间传递信息;而服务器则如同一位睿智的中间人,巧妙地连接着外部系统,这些外部系统可能是庞大的数据库,也可能是功能各异的 API。"
三件套的意义在于:工具变成了可插拔的插座。写工具的人不用管谁来用,写智能体的人不用管工具怎么实现。换个项目,插座照用。
第三层:云上 SSE。 服务搬到局域网、搬到腾讯云,工具从此跨机器。第 10 章把 stdio 和 SSE 的区别讲透了:stdio 是本地进程间管道,服务必须和客户端在同一台机器上;SSE 走 HTTP,服务可以在任何地方。
这一层还带了个很实用的东西:持久化部署。书里用腾讯云做示例,讲了端口开放、在线验证、持久化服务开启。这部分内容在别的书里基本看不到,但对"能不能真的用起来"是决定性的。
第四层:A2A。 见下一节。
五、A2A:智能体的名片和门牌
第 8 章讲 A2A 协议。这一章的技术选择很务实:
"A2A 协议建立在开发者熟悉的网络技术之上:其核心通信方式是 JSON-RPC 2.0 over HTTP(S)……没有晦涩难懂的专有二进制格式,只有通过 HTTP 传输的纯文本 JSON——这种设计非常友好,就像使用所有 Web 服务都能理解的"HTML 通用语言"一样畅通无阻。"
这段话说白了就是:A2A 没有发明新东西,它只是把已有的 Web 技术拿来做智能体通信。 这是个聪明的选择,也是个省事的选择——任何一个会写 HTTP 接口的人,都能上手。
书里 Hello Agent 那个例子的三段实现,作者用了三个特别生活化的比喻,我觉得比代码本身更值得记:
"请求处理器 DefaultRequestHandler:这个组件就像智能体的"接线员",专门负责接听和处理所有打给智能体的"电话"……
服务器 A2AStarletteApplication:这是智能体的"营业大厅",把智能体正式搬到网络上开张营业。它会自动在固定地址(/.well-known/agent.json)挂出智能体的"招牌"(agent_card),路人一来就能看到简介、功能和联系方式……
启动服务 uvicorn.run:最后一步就是"点亮营业灯牌"。"
「招牌」这个词很准。`/.well-known/agent.json` 就是智能体的门牌号——别人想知道你能干什么、怎么联系你,访问这个地址就行。这是整章最有价值的一个概念,因为它把"智能体发现"这个抽象问题,变成了一个具体的 URL。
六、七个项目,最后收敛成一张图
全书七个实战项目:二次元陪伴 Agent 微调(第 3 章)、跨境电商智能客服(第 7 章)、Hello Agent(第 8 章)、高德地图 MCP(第 11 章)、arXiv 科研论文 MCP(第 12 章)、旅游规划智能体(第 14 章)、高品质住宅投研智能体(第 16 章)。
读到第 16 章,我发现它们的代码结构几乎一样。以投研智能体的"数据收集模块"为例:
def perception(state, llm):
prompt = ChatPromptTemplate.from_template(PERCEPTION_PROMPT)
chain = prompt | llm | JsonOutputParser()
input_data = {"research_topic": state["research_topic"], ...}
result = chain.invoke(input_data)
return {**state, ...}
这段东西你在旅游规划那一章也能看到,只是 prompt 换了、字段换了。
所有智能体的骨架就三样:一个 state 字典、一串函数、一个循环。 每个节点都是 `prompt | llm | parser`,每个函数负责读 state、算一步、写回 state。
换项目只换两样东西:System Prompt 写什么、工具清单给哪些。 代码结构几乎不动。
这是个让人清醒的结论。它意味着这个领域的门槛不在编程——而在能不能把业务写成一张表。旅游规划那张表是"出发地、目的地、天数、预算、偏好",投研那张表是"研究主题、关注区域、时间范围"。
表写不出来,代码写得再漂亮也是白写。第 16 章的"负公摊深析"那几节看着跟 AI 无关,其实是全书最硬的部分——不懂业务,你根本填不出那张表。
七、三个保留意见
一是版本时效。 书是 2025 年 9 月清华社出的,讲的是 Qwen3。MCP 规范迭代很快,SSE 传输在较新版本里已经被 Streamable HTTP 取代。书里的代码能跑,但别把它当标准文档看,遇到协议细节还是要查官方仓库。
二是篇幅分配有点失衡。 第 2 章"开发环境配置"占了 33 屏,从 Miniconda 装到 PyCharm 建工程,截图密集。这部分对纯新手友好,但对有 Python 基础的人是纯浪费——而这批人恰恰是这本书的主要读者。
三是微调那章的例子太小。 第 3 章用 Qwen3-0.6B 做二次元角色微调,0.6B 的模型微调出来的效果,和真正能用的陪伴产品差着数量级。这一章的教学价值大于实用价值。
另外提一句:第 1 章讲 Qwen3 的 Parallel Scaling,数据挺有意思——4 路角色并行时 Loss 下降速率提升 73%,算力只增加 2.1 倍;到 16 个角色时收益就趋缓了。作者把它概括成"以空间换智慧",对应思维链的"以时间换空间"。这个对照我记得比任何架构图都牢。
八、一句话
这本书真正教的不是怎么"做"一个智能体,而是怎么把模型做不到的事,搬到模型外面去做。提示词在模型内部讲道理,协议在模型外部立规矩。前者靠悟性,后者靠约定——约定可以复用,悟性不能。
如果你手上有一个具体场景想做成 Agent,这本书的第 7 章和第 14 章值得先读:一个教你知识怎么进去,一个教你工具怎么出来。剩下的章节,等真要用到 MCP 或 A2A 时再翻。
阅读记录:微信读书网页版逐页翻阅,747 屏 / 16 章 / 18 分 07 秒。
本书知识图谱见文中配图,原图地址:https://www.jiangtian.top/zb_users/upload/kg/mcp-agent-map.png
发表评论: