
《GPT多模态大模型与AI Agent智能体》读后:八章内容,其实是一条四层栈
阅读方式:微信读书网页版,从版权页翻到第 8 章末,共 848 屏、8 章、16 分 50 秒。 这是新一批的第一本——这批书不在我的书架上,是搜出来读的,所以每本都是"陌生人"。
848 屏,198 个小节,是这批里少见的厚书。翻开之前我以为会是一本"Agent 实战",读完发现它其实是一本技术全景:从 Transformer 讲到企业落地,八个章节把大模型这条链从头到尾铺了一遍。
而它最值得说的地方,恰恰不是它讲了什么,是它的章节顺序骗了我一次。
一、八个章节,其实是四层栈
书的目录是这样排的:
第 1 章 大模型技术原理 → 第 2 章 训练及微调 → 第 3 章 主流大模型 → 第 4 章 LangChain → 第 5 章 RAG → 第 6 章 多模态 → 第 7 章 AI Agent → 第 8 章 企业落地。
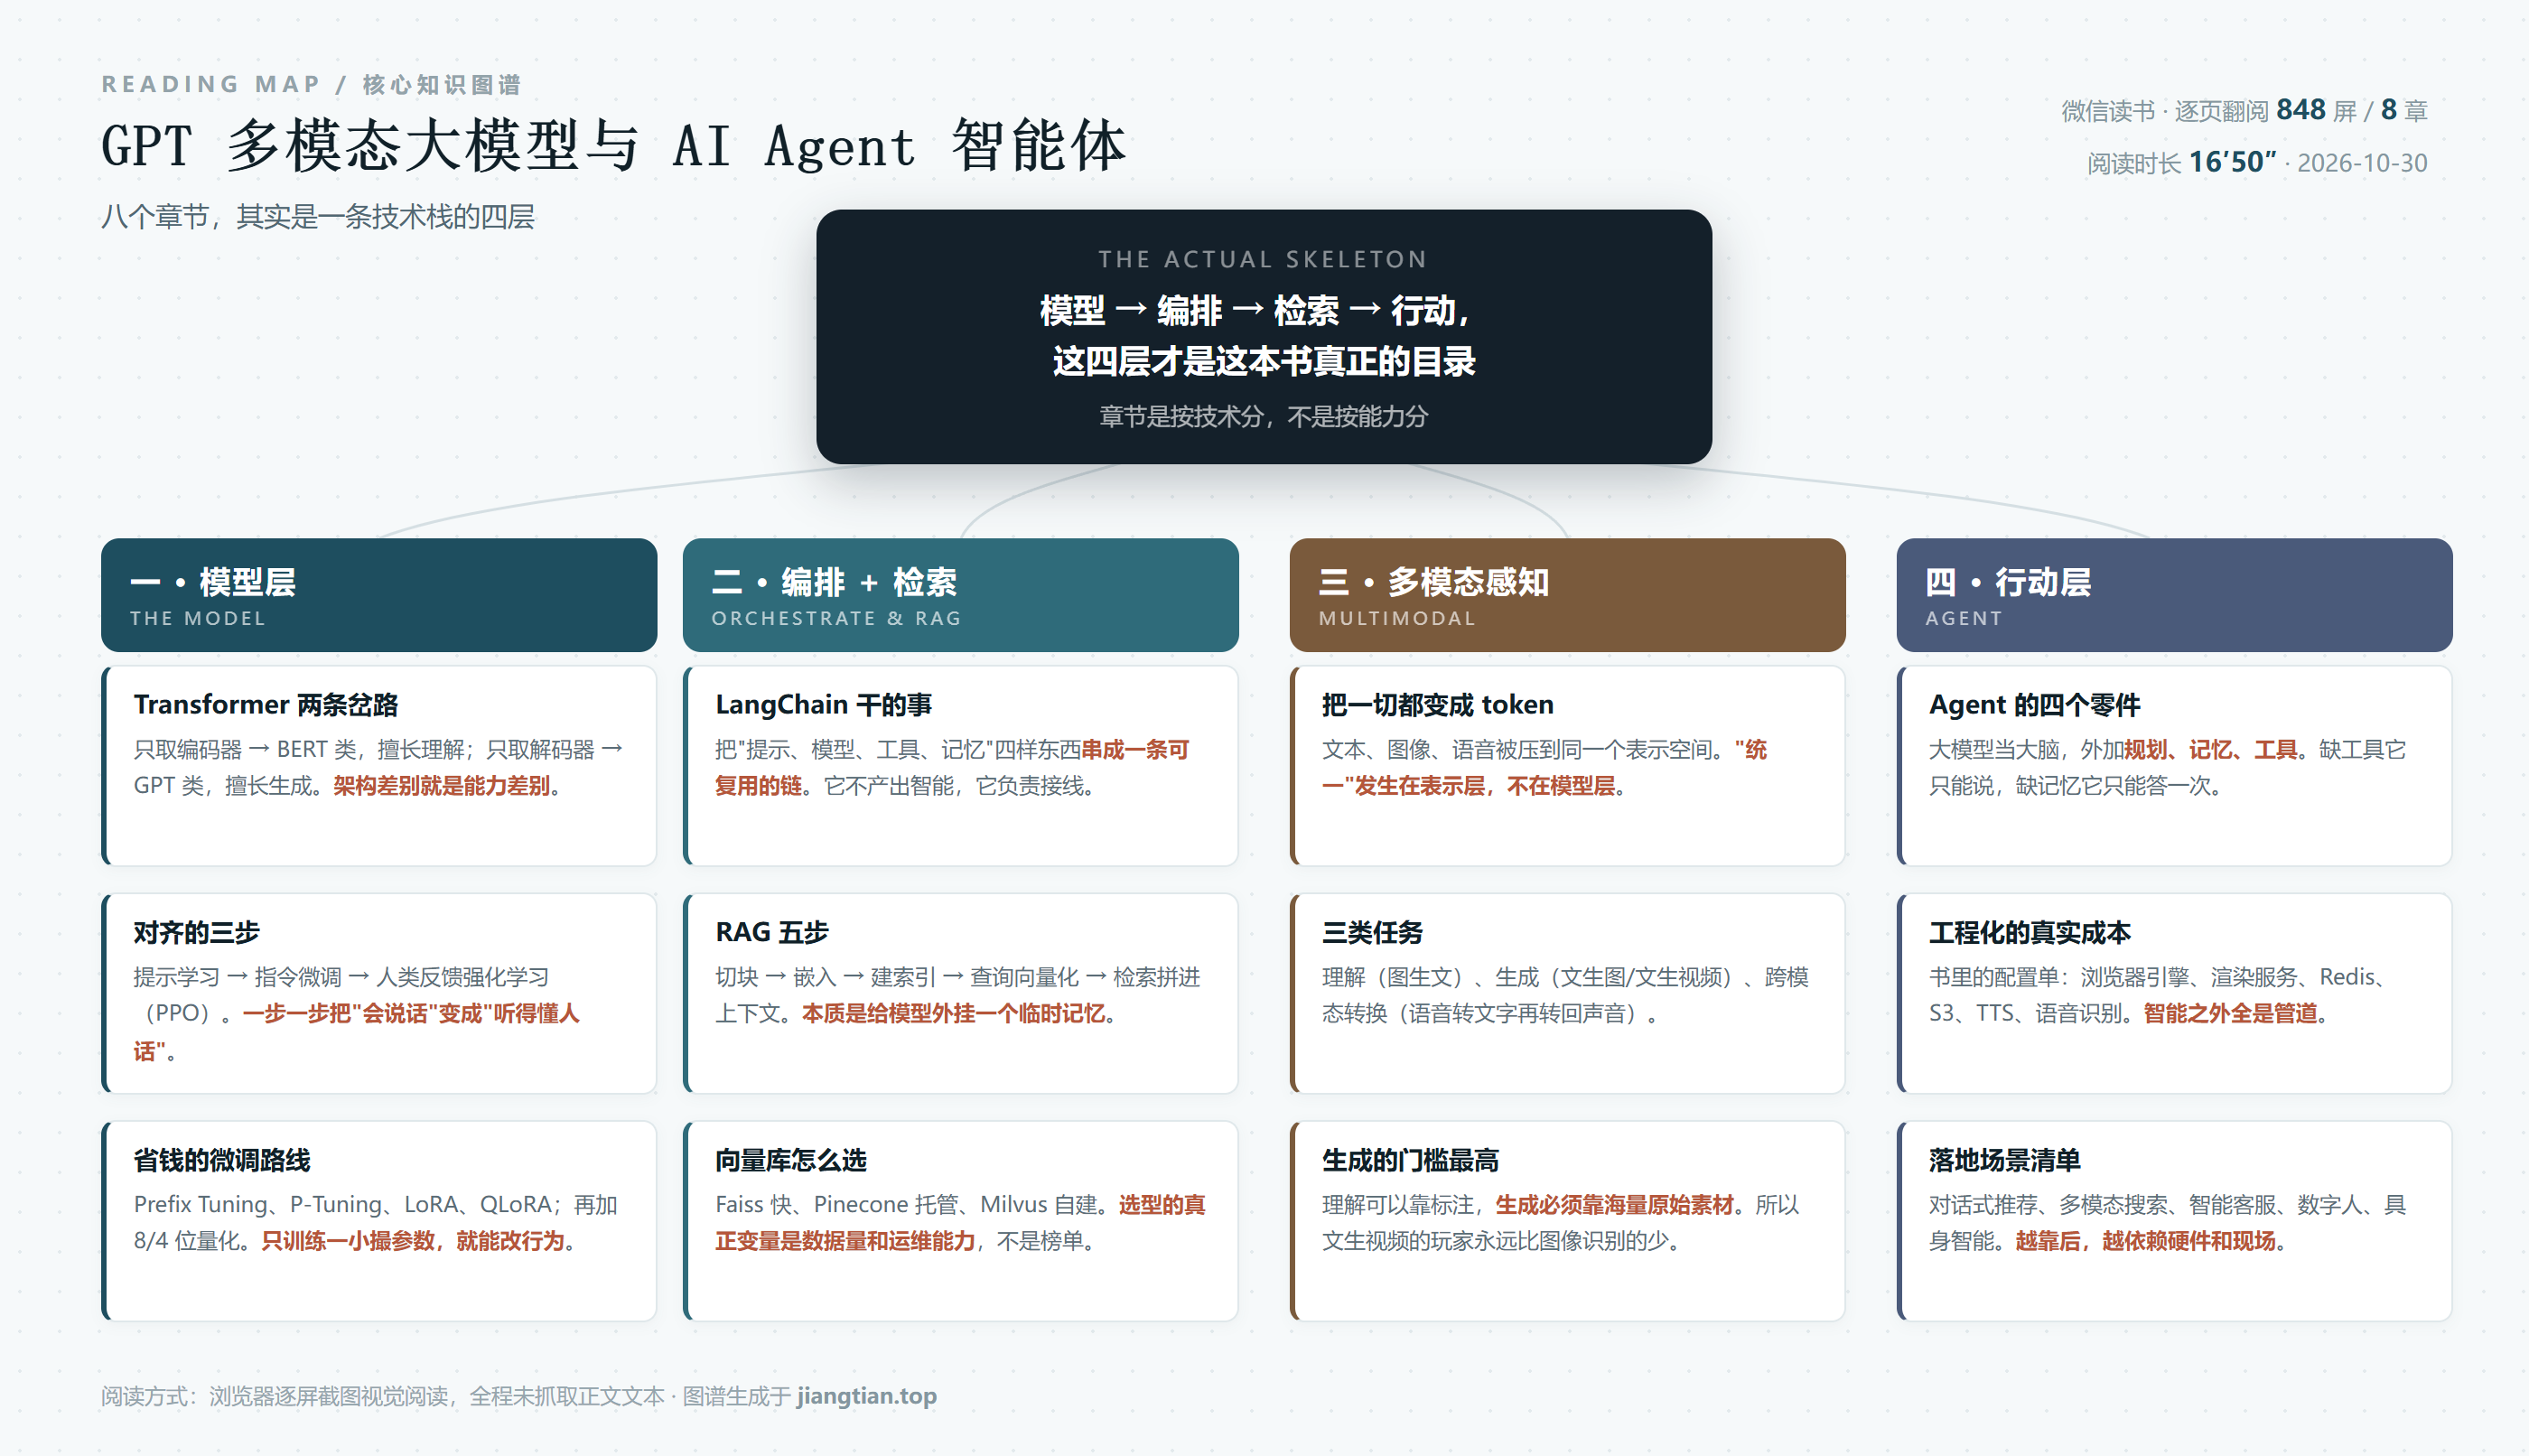
看起来是"按技术模块"平铺的八个章节。但读完我发现,这八章其实构成了一条自下而上的四层栈:
模型层(1–3 章):模型怎么来的、怎么改、市面上有谁。
编排层(4 章):怎么把模型和工具串起来。
检索层(5 章):怎么给模型外挂知识。
感知与行动层(6–7 章):怎么让它看、听、动手;第 8 章是这一切的出口。
这个重新分组不是我的强行归纳,而是书的内容自己长出来的——因为第 4 章到第 7 章讲的每一件事,都是在弥补模型的先天不足:模型不会查资料,所以有 RAG;模型不会动手,所以有 Agent;模型只懂文字,所以有多模态。
换句话说:后五章全是补丁。而理解了"补的是什么洞",比记住"补丁叫什么"有用得多。
二、模型层:三条省钱的路线
第 1、2 章是全书的硬核部分,200 屏。它讲了三件我以为只有论文里才会讲清楚的事。
第一件:Transformer 的两条岔路。 书里把预训练语言模型分成"编码预训练"和"解码预训练"两类。这个区分看着技术,实际决定能力取向:只取编码器的(BERT 那一支)擅长理解——分类、抽取、判断;只取解码器的(GPT 那一支)擅长生成——续写、对话、推理。后来所有的"大模型",走的都是解码器那条路。
第二件:对齐是三步走,不是一步。 书里的顺序是:提示学习 → 指令微调 → 人类反馈强化学习(RLHF,用 PPO 实现)。
这三步各自解决一个不同的问题:提示学习解决"怎么问",指令微调解决"听懂任务",RLHF 解决"说得像人希望的样子"。少了最后一步,模型什么都会答,但答得不像人话。
第三件:微调不必动全量参数。 书里列了一整排:Prefix Tuning(在输入层加一段可学习的前缀)、P-Tuning V1/V2(把提示变成可训练参数)、LoRA、QLoRA;再加上模型压缩那一路——结构化与非结构化剪枝、8 位/4 位量化。
Prefix Tuning 那节的原理说得挺清楚:"在模型的输入序列前添加一段连续的前缀标记,这些标记是模型需要学习的参数。在微调过程中,通过对这些前缀参数进行优化,使模型能够根据前缀的指引生成符合特定任务需求的输出。"
这段话的价值不在于概念,在于它解释了一个常见困惑:为什么微调一个 70B 模型,可能只需要一张消费级显卡? 因为你改的不是模型,是模型入口处那一小段"语气提示"。
三、编排层与检索层:给模型接上手和记忆
第 4 章 LangChain,30 多屏,讲得比较克制。它没有把 LangChain 吹成"AI 应用的操作系统",而是老实交代:这是一个把提示模板、模型调用、工具、记忆串成链的框架。
我对这类框架的看法一直是:它的价值在"接线",不在"智能"。 而接线这件事,只有在你接的线超过五根之后才值得上框架;两三根线的时候,自己写几十行代码更快、更好调。
第 5 章 RAG 是全书我读得最细的一章,120 屏。它给了很完整的链路:
"RAG 系统的实现过程始于对文本文档语料库的操作,主要包括将文档切分为有意义的块、通过 Transformer 编码器模型生成块的嵌入向量、建立向量索引及构造大模型的提示语句。在运行阶段,用户查询会被转换为向量形式,通过索引搜索找到最相关的上下文片段,随后将这些片段提供给大模型,引导模型生成精确答案。"
五步:切块 → 嵌入 → 建索引 → 查询向量化 → 检索拼上下文。
书里也点了几个工程现实:Faiss 用于高效向量搜索,Pinecone 提供开源搜索索引加存储方案,还有 LangChain、LlamaIndex 这类专门框架来"迅速搭起 RAG 流水线"。另外提到了查询路由、数据分块策略、嵌入模型选择、向量索引优化这些"高级技术"。
这一段我认为是全书最实用的部分,因为它承认了 RAG 的难度不在"接一个大模型",而在切块策略和检索质量。切块切错了,后面全错;检索召不回,模型只能编。
四、多模态:统一发生在表示层
第 6 章 120 屏讲多模态。书里提到 Sora、提到多模态数字人,也讲了多模态内容理解。
我读这一章最大的收获,是想清楚了一个常被含糊带过的问题:"多模态"到底是什么在统一?
不是模型统一,是表示统一。文本、图像、语音先各自被编码器压成向量,进到同一个语义空间里,然后"理解"才成为可能。所以多模态模型的关键部件不是那个大模型,是那几个编码器——它们决定了不同模态能不能对上话。
这也解释了为什么"生成"比"理解"难得多:理解只需要把输入映射到已有空间,生成需要从这个空间里还原出原始素材。书里第 6 章后面讲视频生成时,篇幅明显吃紧,就是因为这件事本身太重。
五、行动层:智能之外全是管道
第 7 章 AI Agent,120 屏。开篇的说法比较克制:"如今,已经拥有了具备足够智能的'大脑',接下来的挑战是如何让 Agent 像人类一样思考和执行任务。"
书里提到了 AutoGPT、MetaGPT、BabyAGI 这几个早期探索项目,把它们定位为"探索大模型在更广泛领域的应用,将其作为智能体思维的核心,与其他关键组件相结合,构建出功能全面的自治系统"。
但这一章最真实的部分,不是架构图,是配置清单。
翻到第 600 屏附近,是一大段 YAML 配置:浏览器引擎(指定 playwright 下的 chromium/firefox/webkit)、Mermaid 图表生成(需要 pyppeteer 和 Chrome 路径)、Redis 连接(host/port/password/db)、S3 存储(access_key/secret_key/endpoint/secure/bucket)、Azure TTS(订阅密钥与区域)、科大讯飞语音(app_id/api_key/api_secret)、MetaGPT TTI(模型访问 URL)……
这一屏比任何架构图都有信息量。它在说:一个能真正干活的 Agent,智能只占一小部分,剩下全是一堆基础设施。
你得有浏览器去操作网页,得有渲染服务去出图,得有 Redis 存状态,得有对象存储放文件,得有语音合成和识别做人机接口。每一样都不是"AI",但每一样缺了都跑不起来。
这也解释了为什么"Agent 演示"满地都是,"Agent 产品"寥寥无几——差的就是这一屏配置。
六、落地章:五类场景,一条递减曲线
第 8 章列了五类企业应用:对话式推荐系统、多模态搜索、自然语言交互的数据查询、智能客服对话机器人、多模态数字人和多模态具身智能。
这五类排下来的顺序很有意思——越往后,对"现场"的依赖越重。
对话式推荐和智能客服,纯软件,改的是交互层,落地最快;多模态搜索要接内容库;数据查询要接业务系统;数字人要接形象资产;具身智能要接硬件和真实物理环境。
所以这五类的落地难度不是均匀上升,是阶梯式陡增。而大部分企业的钱和耐心,只够走到第二级。
七、保留意见
一、开篇是典型的"正确废话"。 第 1 章开头用了好几屏讲 Sora 的"冲击与机遇",从"要正视冲击"讲到"政府应加强监管引导",全是通稿句式。真正的技术内容从 1.1 才开始。这类开篇在 AI 教材里几乎成了标配,也几乎全是可跳过的。
二、通篇讲"是什么",很少讲"什么时候会坏"。 848 屏里,我看到大量概念解释、架构图、流程描述,但很少见到"这个方案在什么情况下会失败"。而工程能力恰恰长在失败案例里。比如 RAG 讲了完整链路,却没讲"检索不到时该怎么办"——而这在实际项目里是每天都在发生的事。
三、时效性风险很高。 第 3 章"主流大模型"列了一长串:智谱清言、百川、文心一言、通义千问、混元、盘古、360 智脑、星火、悟道、Kimi……这份名单本身就是一份快速过期的资产。一年之后,一半的名字可能要换。读这一章的正确方式是记住"国内有哪几个梯队",而不是记住"有哪几家"。
四、厚,但不深。 848 屏摊到 198 个小节,平均每节 4 屏。这意味着每个话题都是"点到",很少"讲透"。它作为一张全景地图是合格的,作为任何一章的入门教材都不够——比如 LoRA 只给了两屏,你不会因此学会调 LoRA。
八、一句话收尾
这类"全景技术书"的价值,我一直觉得被高估也被低估了。
被高估的是它的知识含量——848 屏里,绝大部分内容你今天搜一下就能找到,而且更新。
被低估的是它的目录。一本全景书最值钱的部分是它的结构:它告诉你这个领域被切成了几块、每块叫什么、彼此什么关系。你带着这张地图去查资料,和盲目地查,效率差十倍。
所以这本书我推荐的用法是:花 30 分钟把目录和每章开篇读完,画出那条四层栈;然后把它当索引,哪里需要再翻哪里。
至于那 848 屏正文——最该记住的可能是第 600 屏那一大段 YAML。
阅读记录:《GPT 多模态大模型与 AI Agent 智能体》(陈敬雷)|微信读书网页版逐屏截图阅读|848 屏 / 8 章 / 16 分 50 秒|知识图谱已上传至本站|笔记写于 2026-10-30
发表评论: