
《Harness工程》读后:Agent不够好用,多半是挽具不合身
阅读方式:微信读书网页版,从版权页翻到第 7 章,共 401 屏、7 章、8 分 27 秒。 这本书解决了我一个长期没想通的问题:为什么同样接一个模型,有的产品像"助手",有的像个"更贵的输入框"。
答案在书名里那个词——Harness。
这个词原意是马具:套在马身上、把马力转换成拉车的那一整套东西——缰绳、辕、轭、鞍。马再壮,没有 harness,它也只是在原地跑。
书里的意思一样:模型是马,harness 是那套套住它、喂饱它、看住它的东西。 决定一个 Agent 能不能干活的,往往不是马力,是这套挽具做得好不好。
一、上下文工程:不是写得更长,是学会"卸载"
第 1 章开篇有个例子很能说明问题。同一句"理想 L6 怎么样",如果只给一句干巴巴的问题,模型只能回一堆官网话术;但如果先把背景铺开——十年油车驾龄、往返 30 公里通勤、五口人、预算 20–25 万、在意底盘调校和安全性、开 8 年、电池用宁德时代和欣旺达混发——回答立刻变成一份有判断的选购分析。
书里把这个叫"上下文工程",并且给了一个我觉得很到位的定性:它不是把提示词写得更长,而是决定"什么该进上下文、什么不该进"。
而全书最漂亮的一个设计出现在第 5 章:Skills —— 上下文卸载的艺术。
它的做法是三层渐进式加载:
- L1 标签层:Agent 启动时只扫描技能目录里每个 SKILL.md 的元数据——名称 + 描述。几十个技能,也只占几百字上下文;
- L2 说明正文:判断这次任务真的需要某个技能,才通过
load_skills把正文读进来——工作步骤、示例、规范; - L3 资源层:脚本、参考资料、静态资源留在文件系统里,用到才取,永远不进入 LLM 的记忆。
书里对为什么必须这么做的解释,我抄下来了:在大型项目中,如果把所有文档、规范和最佳实践一次性塞入系统提示词,不仅会迅速耗尽上下文窗口,还会引入大量无关噪声。
这句话点破了一个常见的错觉:很多人以为"上下文给得越多越好",于是把规范、示例、文档全塞进去。结果是模型被噪声淹没,注意力被摊薄,回答反而变差。上下文不是仓库,是工作台——台面就那么大,工具得按需拿。
二、三十行代码,说清 Agent 到底是什么
第 6 章要复现 Claude Code 的核心设计,但它没有一上来讲架构,而是先给了一段 agent_loop。我把结构简化了一下,大概是这样:
def agent_loop(messages):
    while True:
        response = send_messages(messages)          # 问模型
        msg = response.choices[0].message
        if msg.tool_calls is None:                  # 没工具要调 → 收工
            break
        messages.append(msg)                        # 把这轮回复记进历史
        for call in msg.tool_calls:
            args = json.loads(call.function.arguments)   # 解析参数
            if call.function.name == "run_bash":
                result = run_bash(args["command"])       # 执行
            messages.append({                            # 结果回填
                "role": "tool",
                "content": result,
                "tool_call_id": call.id,
            })
就这三十来行。所谓 Agent,本质就是一个"问—做—记—再问"的死循环,加上一个能把结果写回历史的通道。
但魔鬼在细节里。书里特意强调了两处:一是工具结果必须以 role="tool" 配上对应的 tool_call_id 塞回去,否则模型对不上账;二是这个循环没有终止上限——所以真实的 harness 必须补上轮次限制、超时、成本熔断。
看到这里我才明白,为什么"套个壳"的产品和真正的 Agent 差距那么大:壳只做了第一轮,Agent 做的是第 N 轮,而且第 N 轮的上下文是被精心维护过的。
三、子 Agent 的交付标准:写完不算完,测试通过才算完
书里讲多 Agent 协作时,给了一个我觉得极其重要、但很少被强调的细节。
主 Agent 派一个 SubAgent 去写 test.py。SubAgent 写完文件后,它并没有立刻回报"完成",而是在自己的循环里继续调用 Bash 工具,跑一次 python test.py。等测试通过,它才把结果整理成一句摘要——"文件已创建,测试通过"——交回主 Agent。主 Agent 收到这句摘要,结合上下文做出最终判断,再向用户确认。
书里原文说的是:SubAgent 完成编写与测试后,将最终的执行结果返回给主 Agent,主 Agent 接收到这一摘要信息后,结合上下文作出了最终判断。
这个链条里有两个设计值得单独拎出来:
第一,验证权在干活的人手里。 不是"我写完了,你验收",而是"我自己验过了,报告结论"。这跟人类团队里靠谱的工程师是同一个习惯。
第二,回传的是摘要,不是全部过程。 主 Agent 不需要看 SubAgent 的三十次工具调用,只需要知道"成了没有、有什么坑"。这就是多 Agent 系统里最省的上下文策略——层级之间只传结论。
四、持久化、异步、Agent Teams:从"一次对话"到"一个班次"
第 6.3 节讲跨会话的任务管理,代码很短但思路完整。任务对象长这样:
task = {
    "id": self._next_id,        # 全局唯一
    "subject": subject,         # 任务主题(必填)
    "description": description, # 任务描述
    "status": "pending",        # 待处理
    "blockedBy": [],            # 前置依赖
    "blocks": [],               # 后置依赖
    "owner": "",                # 后续分配给谁
}
self._save(task)                # 序列化成 task_{id}.json 落盘
就这七个字段,把"任务"这件事说清楚了:它是什么、干到哪了、被谁卡着、卡着谁、归谁。 而 _save 落盘这一步,是"跨会话"的全部秘密——进程可以死,对话可以断,任务还在。
再往上就是 Agent Teams。书里实现得很轻:给每个队友的 Agent Loop 注册两个工具,send_message(发消息)和 read_inbox(读收件箱),再给主 Agent 加一个"广播给全员"的能力(发送前会跳过自己,避免自己给自己发)。
我看到这里笑了一下:这不就是一个最简版的群聊 + 任务板吗? 人类团队协作需要的三样东西——能对话、有任务板、知道谁在等谁——它全有了,而且每样都只用了最小实现。
五、Claw 类产品:把"助理"做成 7×24 的服务
最后一章是我读得最慢的一章,因为它讲的是"怎么把一个 Agent 变成能长期在线的产品"。书里拆了 NanoClaw 的八个核心模块:
| 模块 | 职责 |
|---|---|
| 编排器 index.ts | 主循环、Agent 调用、群组注册、状态管理 |
| group-queue | 开发队列:容器并发控制、消息管道传输 |
| Channels | 通道注册表,用自注册工厂模式接 Telegram / WATG 等 |
| IPC Watcher | 跨群组通信、任务 CRUD |
| router | 消息 XML 格式化、出站路由 |
| container-runner | 容器 Spawn、挂载卷 |
| task-scheduler | Cron / Interval 定时任务执行 |
| SQLite 数据库 | 消息 / 任务 / 会话 / 群组持久化 |
书里对这个系统的定性只有一句,但很准:NanoClaw 的核心逻辑,本质上是解决信息如何在受限的容器环境与外部 IM 平台之间安全、可靠地流动的问题。
注意这三个词:受限、外部、可靠。 容器是受限的(安全隔离,但拿不到外面),IM 是外部的(能触达用户,但不可信),而消息必须可靠(不能丢、不能重、不能乱序)。
所以整章的真正内容是:消息先落库(不丢)→ 进队列(控并发、保序)→ 起容器(隔离执行)→ 结果走 router 出站(格式化、鉴权)。 一条消息的生命周期,被拆成了四段可观测、可重试的流程。
这一段我读得格外仔细,因为它解释了为什么"自己写个脚本调 API"和"做一个数字员工"之间隔着一整个工程量级——差的不是模型,是这四段的可靠性设计。
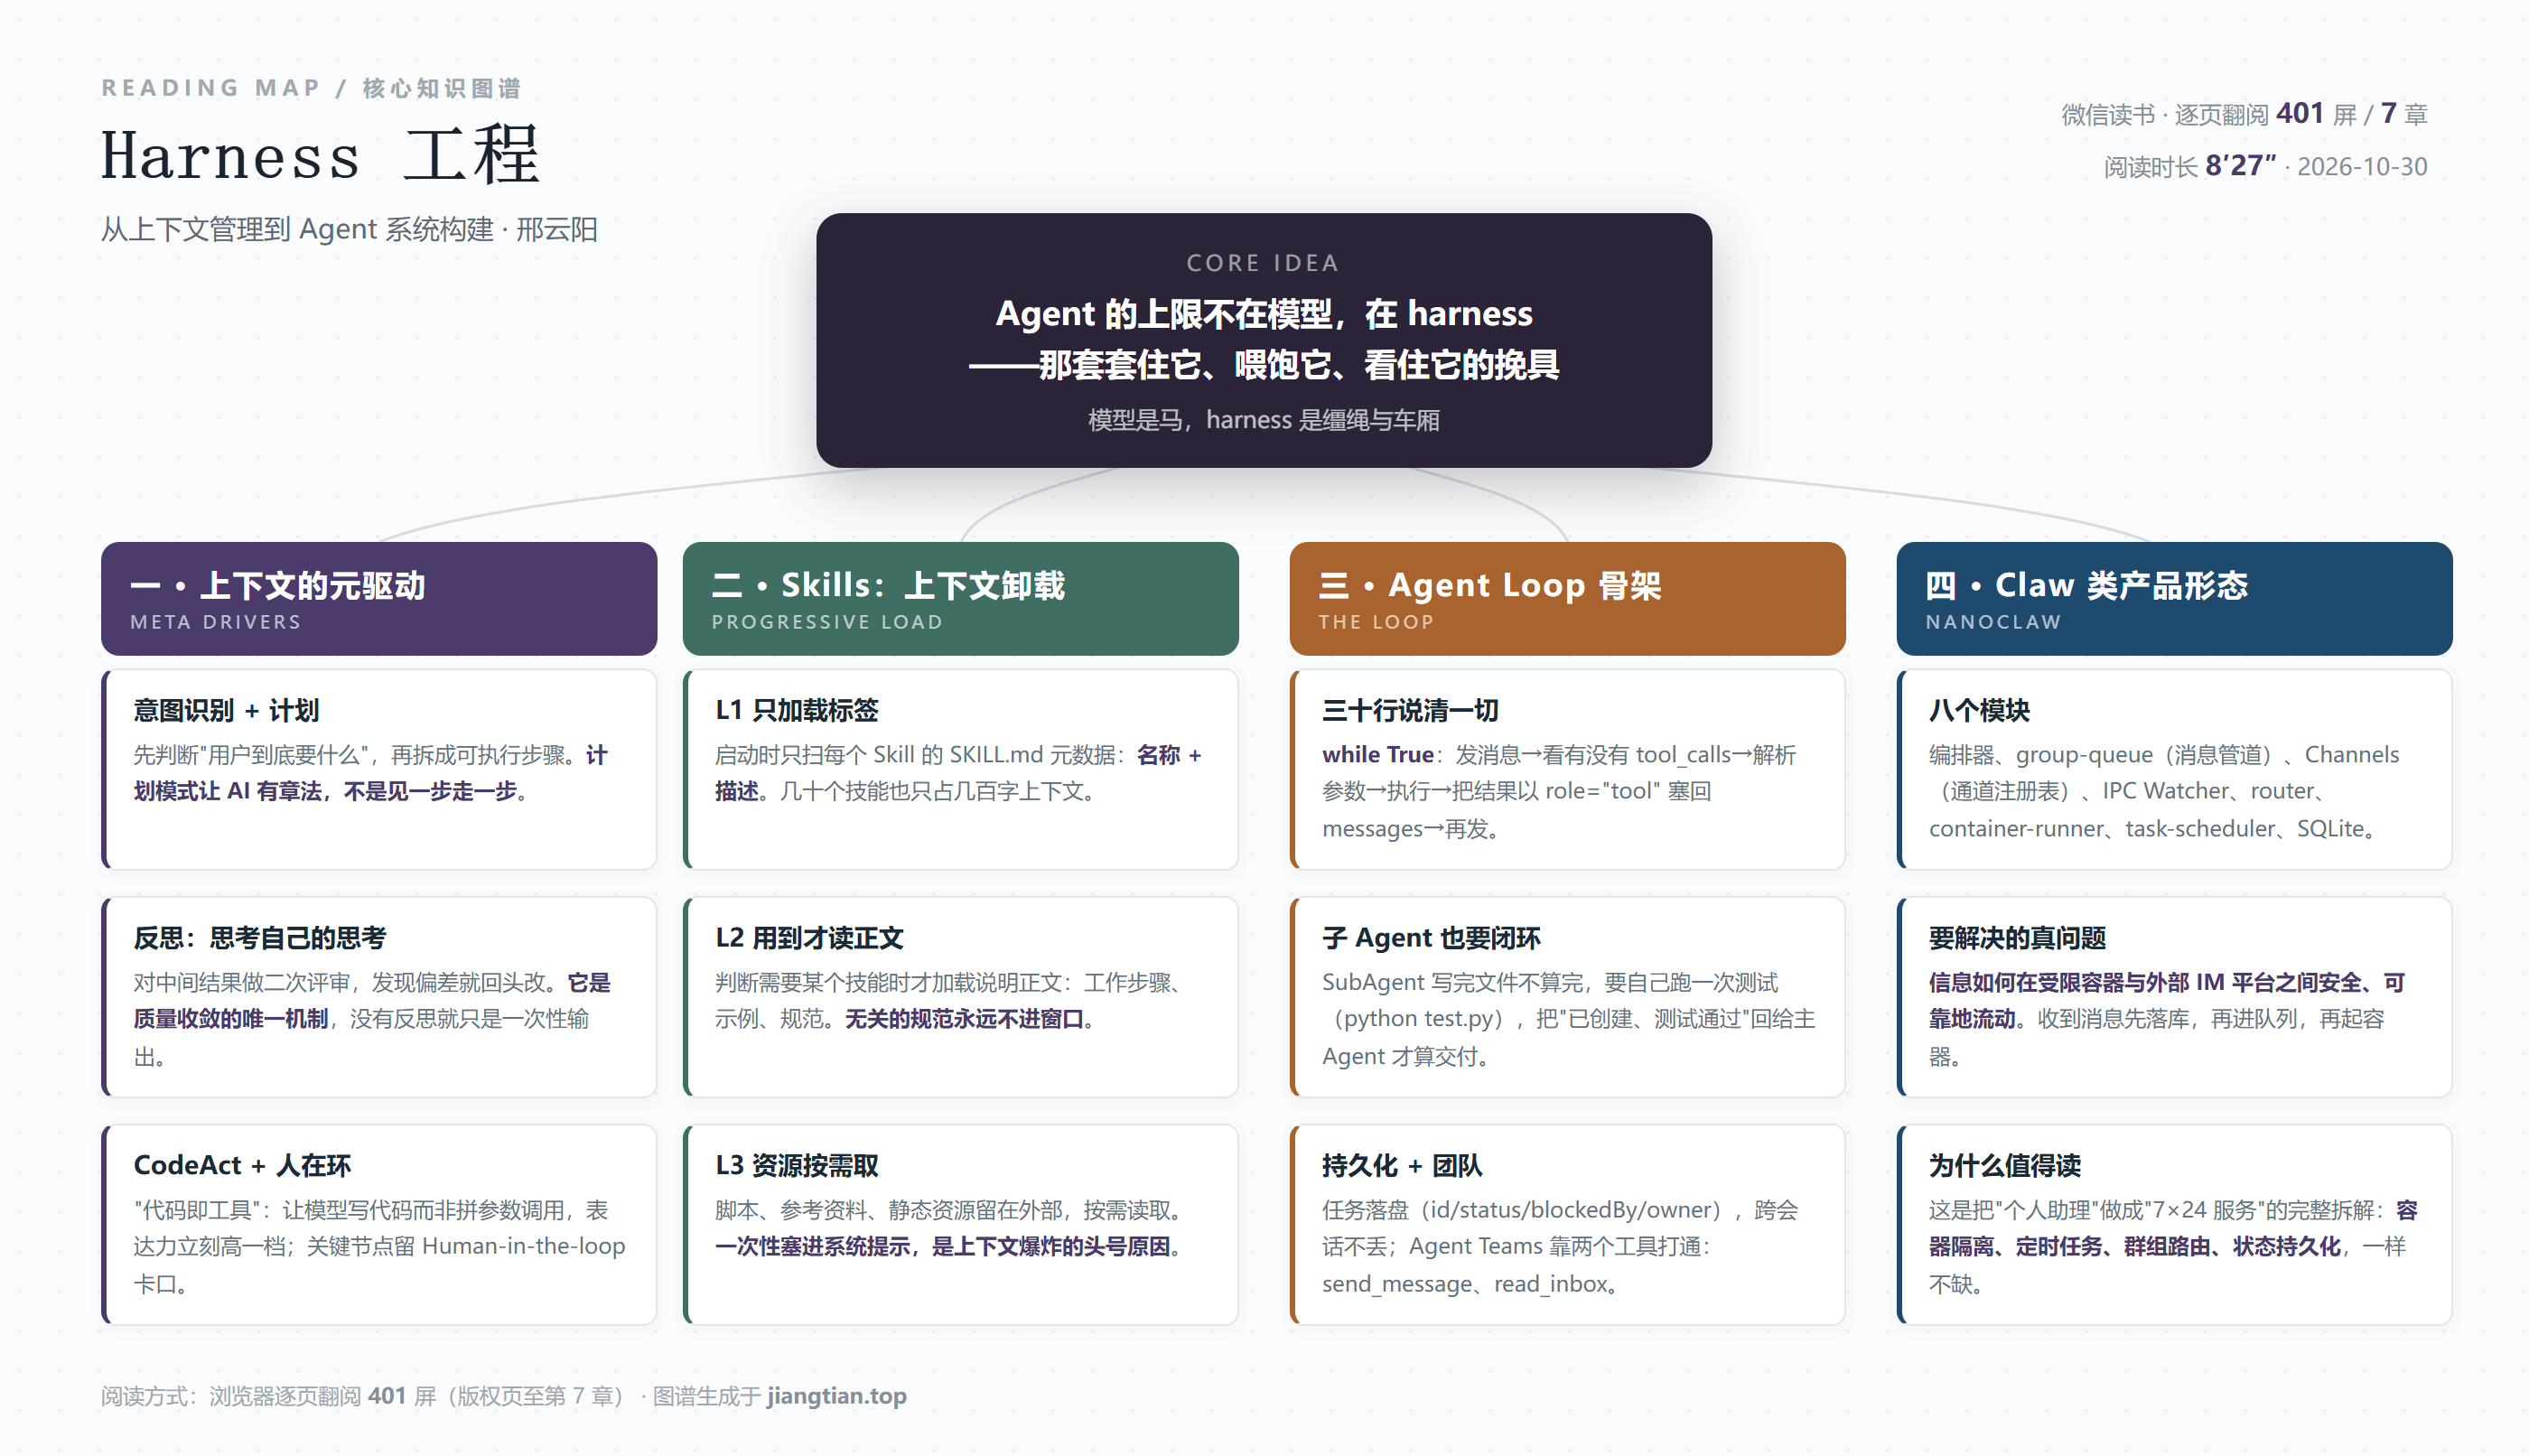
六、核心知识图谱
七、我的保留意见
第一,"Harness"这个概念弹性太大。 书里用它同时指代"上下文管理"、"工具编排"、"产品外壳"。读到后面会发现它更像一个方便的总称,而不是一个严格的架构概念。比喻很好用,但别当定义用。
第二,代码逐行解释的密度偏高。 401 屏里大概一半是代码和代码讲解,有些地方(比如任务对象的七个字段)花了整整两屏解释,读起来有点啰嗦。跳过解释只看代码,速度会快很多。
第三,时效性风险集中在前沿。 Claude Code 的设计、Claw 类产品的形态、Skills 的加载机制,都是 2026 年正在快速变化的东西。半年后这些细节大概率会变,但背后的四个问题——上下文怎么省、循环怎么停、任务怎么存、消息怎么不丢——不会变。
第四,它没怎么讲失败。 全书几乎没有"这样写会踩什么坑"的段落,一路都是"正确的做法是这样"。而实际搭过的人都知道,harness 的价值恰恰体现在出问题的时候。这部分只能靠自己踩。
总而言之,它是我读到现在最"能落地"的一本——不是因为它讲得最全,而是因为它讲的东西,当天就能拿去改自己的项目。
八、一句话收尾
这本书让我改了一个判断:以前我觉得 Agent 不够好用,是模型不够聪明;现在我觉得,大部分时候是挽具不合身。
模型的能力是给定的,你能改的只有三件事:喂给它什么(上下文)、让它能做什么(工具)、以及它做错时你怎么接住(循环、验证、持久化)。
这三件事,就是 harness。而这三件事,全都不在模型里。
阅读记录:微信读书网页版 · 逐页翻阅 401 屏 / 7 章 / 8 分 27 秒 · 覆盖率 100%(版权页至第 7 章末)
《Harness 工程:从上下文管理到 Agent 系统构建》 邢云阳 著 · 人民邮电出版社 · 2026-03
发表评论: