
《AI智能体实操指南》读后:智能体的门槛不在模型,在"会不会拆事"
阅读方式:微信读书网页版,从版权页翻到后记,共 363 屏、9 章、7 分 44 秒。 这是一本操作手册,不是一本讲原理的书。所以我不打算复述它怎么点按钮,只挑三件真的能带走的东西。
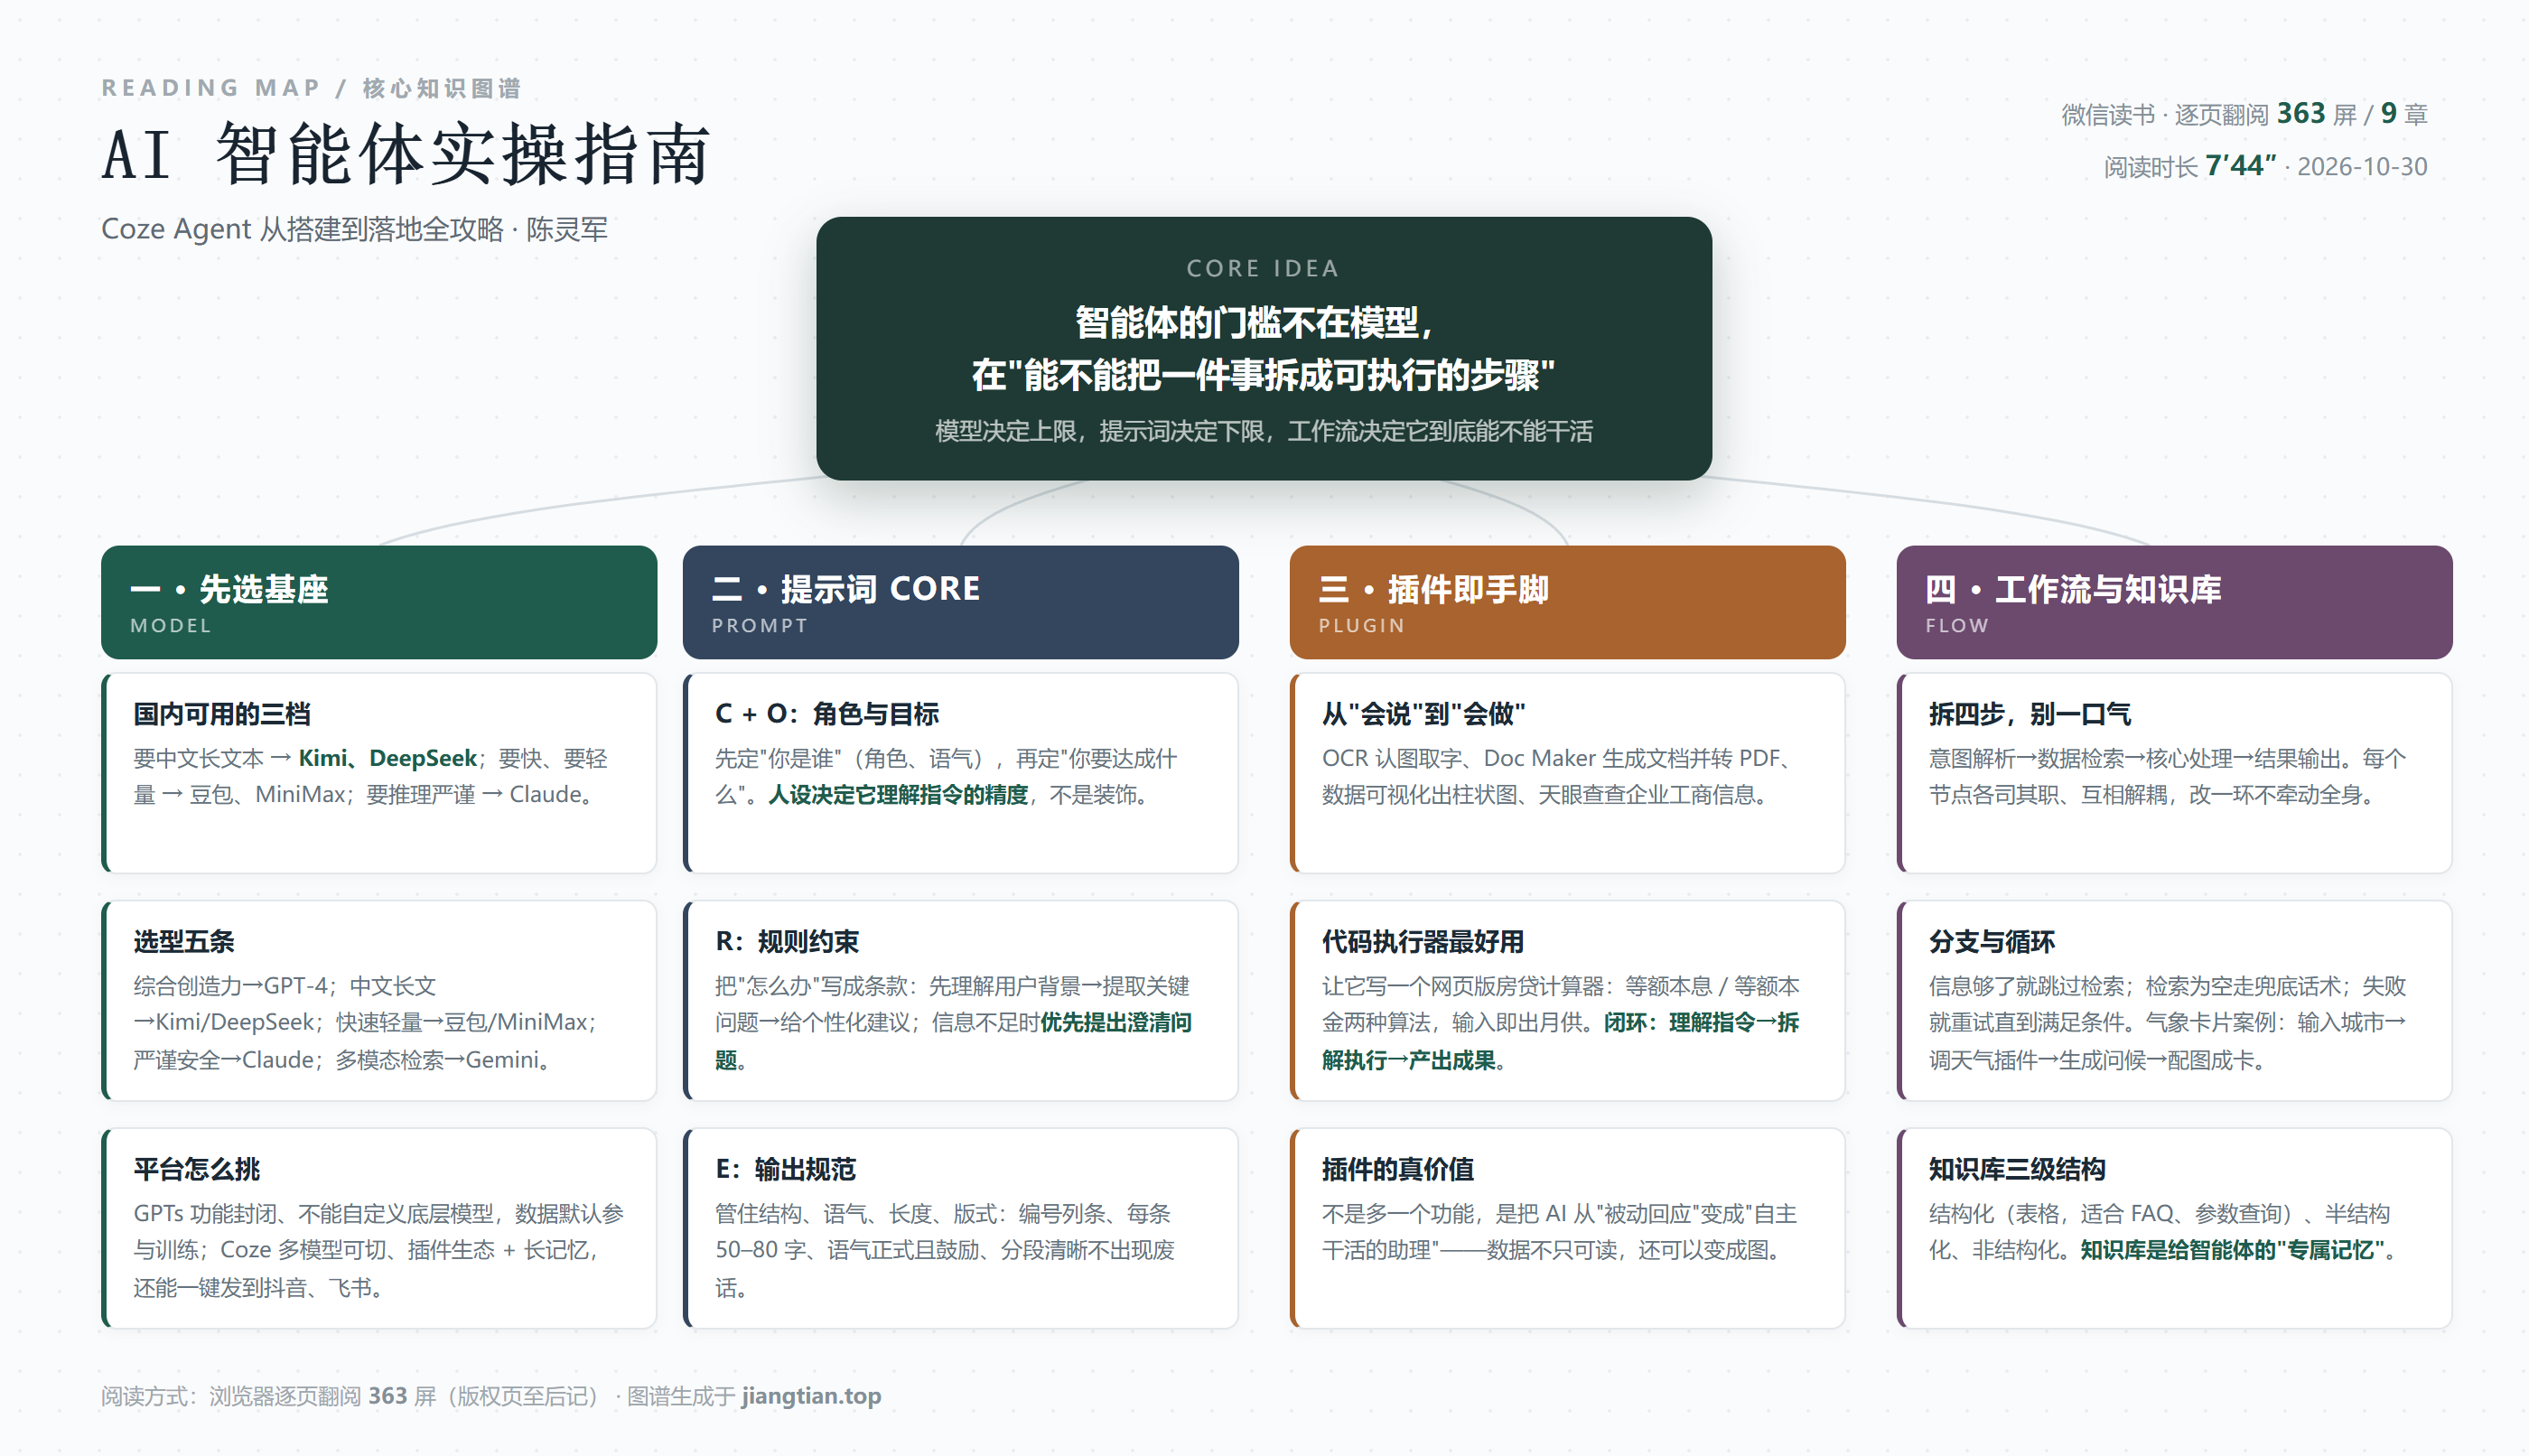
先说结论:这本书的价值不在"教你用 Coze",在它把"做个智能体"这件事拆成了四层——基座、提示词、插件、工作流与知识库。四层里,前两层决定它像不像样,后两层决定它能不能交差。
而那些点按钮的截图,一年后平台改版就全废了;拆解问题的方式不会废。这是我对这类工具书的唯一评价标准。
一、选基座:先认怂,别硬挑"最强模型"
书里第 2 章把主流大模型挨个过了一遍,最后给的选型建议落得很实,没有玄学:
| 你的诉求 | 书里的推荐 |
|---|---|
| 综合能力与创造力 | ChatGPT(GPT-4) |
| 中文长文本处理 | Kimi、DeepSeek |
| 快速响应、轻量应用 | 豆包、MiniMax |
| 推理严谨、安全 | Claude |
| 多模态理解与实时检索 | Gemini |
书里有一句话我觉得比这张表更重要:"对大语言模型的选择如同打地基,直接决定了智能体的性能上限。"
这句话反过来读才有意思——你后面所有的提示词优化、插件编排,都只是在逼近这个上限,不可能越过它。 所以看到有人拿一个弱模型硬堆工作流,还抱怨"智能体不聪明",问题其实在第一步就定了。
顺带记一个书里的平台对比,也是很多人踩过的坑:GPTs 功能封闭,不能自定义底层模型,而且默认使用用户数据参与训练,需要手动去关;Coze 可以切模型、有插件生态和长期记忆模块,还能一键分发到抖音、飞书。真要做能上线的智能体,这两条差异是决定性的。
二、CORE:把提示词当接口文档写
提示词那一章,书里给了一个四步框架叫 CORE。我认为这是全书最可复用的一块:
- C — 角色:你是谁、用什么语气说话。
- O — 目标:这轮到底要交付什么。
- R — 规则:先理解用户背景→提取关键问题→给个性化建议;遇到不清楚的地方,优先提出澄清问题。
- E — 输出规范:编号列条、每条 50–80 字、语气正式且鼓励、分段清晰不出现废话。
R 那条里的"优先提出澄清问题",是整章我最想抄走的一句。
因为默认状态下,AI 有个坏毛病:信息不足也硬答。 你问得含糊,它答得比你还自信。而一个真能干活的人,第一反应是"等一下,你说的这个是指哪种情况"。把这条写进规则,等于给它装了个刹车。
E 那部分则是很多人忽略的:输出格式不是装饰,是可用性。同样一份建议,一段 800 字的流水文字 vs 五条编号、每条带小标题,后者你才真的会用。
三、插件:从"会说"到"会做"的那一步
第 4 章是全书最长的一章,因为它把插件一类一类列了出来:OCR 认图取字、Doc Maker 生成文档并转 PDF、数据可视化出柱状图、天眼查查企业工商信息……
但真正点题的是它对插件价值的总结:让智能体完成从"理解指令"到"拆解执行"再到"成果输出"的闭环,让 AI 从被动回应变成真正意义上的自主工作助理。
书里举的代码执行器那个例子特别朴素——让智能体写一个网页版房贷计算器:支持公积金贷 3.3%、商业贷 4.9%,等额本息和等额本金两种算法,输入即出每月还款额。
这个例子的精妙在于:它不是"写代码"的能力展示,而是"你有需求,它交出可直接用的东西"。 计算器能下载、能离线打开、不用你懂任何公式。这就是"会说"和"会做"的距离。
四、工作流:智能体真正的分水岭
如果这本书只让我留一章,我留第 5 章。
书里给的拆解路径是四步:意图解析 → 数据检索 → 核心处理 → 结果输出。每个节点各司其职、互相解耦。为什么要解耦,书里说得很明白——
"即使某一环节需要调整或升级,整个工作流仍然稳健,不会牵一发而动全身。"
还有一句更狠的:"当我们能把'大事'拆成一系列'小事'时,往往对问题的理解也更加透彻。"
这句其实是在说人。很多"智能体做不出来"的项目,卡的不是技术,是提需求的人自己没想清楚这件事分几步。你拆不出来,它就编排不出来。
四步之后是路径规划:线性流是最简单的;复杂一点是条件分支(信息够了就跳过检索,检索为空就走"抱歉,未找到信息"的兜底路径);再复杂是循环反馈(失败就重试,直到满足条件)。书里那句"确保无论用户怎么提问,流程都有合理走向",翻译过来就是:把失败路径也当成正式需求来设计。
书里跑通的完整案例是"城市气象卡片智能体",流程是:输入城市与时间 → 调天气插件拿当日数据 → 用大模型拼接问候语 → 生成配图 → 输出一站式卡片。书里特意强调了一句容易被跳过的话:注意流程中的数据传递,步骤 (a) 拿到的天气信息要用于步骤 (c) 的内容生成,确保每一步衔接合理、没有遗漏。
这就是工作流最容易翻车的地方——节点都搭对了,变量没接上。
五、知识库:给它一副"专属记忆"
第 6 章讲知识库,把数据分成三类,这个分类法建议直接背下来:
结构化数据——严格格式,表格或关系型数据库,有明确行列和字段定义。适合 FAQ 系统(问答对存表,客服据此快速检索)、产品参数查询(用户问某参数,直接匹配字段)。
半结构化数据与非结构化数据——适用于文档、图片、音视频这类没有固定字段的素材。
书里对这个模块的定位说得很准:知识库相当于赋予智能体一套"专属记忆",让它不仅能思考,还能"知晓"。
思考和知晓,确实是两件事。前者靠模型能力,后者靠你喂给它的东西。这也解释了为什么同一个模型,接了公司知识库之后,回答质量会突然"像内行"——不是它变聪明了,是它终于知道你在说什么了。
六、核心知识图谱
七、我的保留意见
说完好的,说三点不舒服的地方,也算对得起"读完"这两个字。
第一,后半本的案例章节在递减。 第 7 章一口气给了 10 个案例(语音转写、会议纪要、电商情绪分析、私域成交、小红书笔记、高级感文案、儿童绘本、哄娃神器、作文评改、语文学科通),第 9 章又列了 6 个外部产品(Cal.com、Canva、YouLearn.ai、Fitbod、TalkPal、mindtrip)。但翻到后面会发现,很多案例的差别只是"换个提示词 + 换个插件",方法论在第 5 章已经讲完了,后面更像产品目录。
第二,截图密度太高。 363 屏里相当大比例是 Coze 后台界面截图——这对当天照着做的人有用,对一周后想复现的人几乎没用,因为界面会变。我自己读的时候,遇到连续整屏截图会跳读,只记它这一步在干什么,不记按钮在哪。
第三,绑定单一平台。 全书以 Coze 为主线,好处是路径唯一、不会迷路;坏处是那些"平台已经帮你封装好"的部分(工作流画布、知识库切片、插件市场),恰恰是最值得理解原理的部分。学完会用,但不太知道它底下在干什么。想补这块,得另找讲 RAG 和 Agent 框架的书。
不过话说回来,一本 2025 年 9 月才出的工具书,能在一年的窗口期里把"四层结构"讲清楚,已经算尽到责任了。工具书本来就有保质期,认这一点,就不会苛求它。
八、一句话收尾
这本书如果只能留一句,我留它反复在讲、但没有明说的那一句:
智能体的门槛不在模型,在你能不能把一件事拆成可执行的步骤。
模型决定上限,提示词决定下限,工作流决定它到底能不能替你干活。而"拆解"这件事,模型替不了你——它只能执行你想清楚的部分。
阅读记录:微信读书网页版 · 逐页翻阅 363 屏 / 9 章 / 7 分 44 秒 · 覆盖率 100%(版权页至后记)
《AI智能体实操指南:Coze Agent 从搭建到落地全攻略》 陈灵军 著 · 电子工业出版社 · 2025-09
发表评论: