
EdgeOne Makers 朱雀检测:50 万免费 token 能测几篇?单篇成本与官方报价拆解
2026-10-14
一句话结论:按腾讯云官方文档加真实调用返回反推,一篇 2000 字的文章大约消耗 3300~3400 个 token;每月 50 万的免费额度,大约能检测 145~150 篇。至于付费,官方公开的是按量单价 —— 0.001 元/EIU,文本检测 40 EIU/次(每 1000 字符算 1 次,向上取整),折合 0.04 元/千字符、一篇 2000 字文章 0.08 元;而企业版套餐本身不公开标价,需要走"联系我们"的商务申请表单询价。
下面把调查过程、数据出处和几个容易踩的坑完整记下来。
一、先说清楚:这个"朱雀检测"是什么
名字叫朱雀(Zhuque)AIGC 检测模型,是腾讯判断文本/图片是否由 AI 生成的能力。对开发者开放的入口是腾讯云 EdgeOne Makers 的内置模型 @makers/zhuque-text。
接口就一个,同步调用:
POST https://ai-gateway.edgeone.link/v1/providers/zhuque-text/classify
Authorization: Bearer $MAKERS_MODELS_KEY
Content-Type: application/json

{ "text": "待检测的文本", "is_merge": true }参数只有两个:text(必填)和 is_merge(是否合并段落,默认 true)。is_merge=false 时每个段落独立输出置信度。
返回里跟"钱"有关的是两个字段,官方文档特意用了加粗强调区分:
| 字段 | 含义 |
|---|---|
usage.total_tokens |
朱雀模型自身的用量统计,与免费额度核算无关 |
makers_models_usage.total_tokens |
本次调用实际扣减的 Makers 免费额度 token 数,核算免费额度以此字段为准 |
⚠️ 这两个数不一样,而且差得不小。只看第一个数去估额度,会低估约 40%,很容易在月底突然发现额度提前烧完。
二、一篇 2000 字的文章,到底烧多少 token
官方文档没有给出"每字折算多少 token"的公式,只能用两组真实数据反推。
证据 A —— 官方文档示例(11 字符):
"segment_labels": [ {"text": "hello world", "label": 0, "order": 1, "position": [0, 11]} ],
"usage": {"total_tokens": 50},
"makers_models_usage": {"total_tokens": 30}
证据 B —— 腾讯云开发者社区的真实调用提问(2026-10-09):网友贴出的实际返回中,输入文本长度约 494 个字符,返回里是
"usage": {"total_tokens": 494},
"makers_models_usage": {"total_tokens": 824}
把两组数据放一起,规律就很清楚了:
| 字符数 | usage.total_tokens | makers_models_usage(计费) | 计费/字符 |
|---|---|---|---|
| 11 | 50(≈字符数) | 30 | 2.7×(含固定开销) |
| 494 | 494 | 824 | 1.668× |
可以得出三条结论:
usage.total_tokens基本等于字符数(11→50 那条是旧样例,494→494 这条对得很准)。makers_models_usage(真正计费的那个)≈ 1.67 × 字符数,短文本里还含一点点固定开销。- 按 1.67 倍线性外推,2000 字 ≈ 3340 token。取整说,一篇 2000 字文章约 3300~3400 token。
按 1.7 倍的经验值粗算也一致:2000 × 1.7 = 3400。所以"token ≈ 1.7 × 字数"可以直接当日常估算公式用。
三、50 万免费额度能检测几篇
500000 ÷ 3400 ≈ 147;500000 ÷ 3300 ≈ 151。
所以答案很实在:每月大约 145~150 篇 2000 字的文章。取中位数说 ≈150 篇/月,平均一天不到 5 篇。
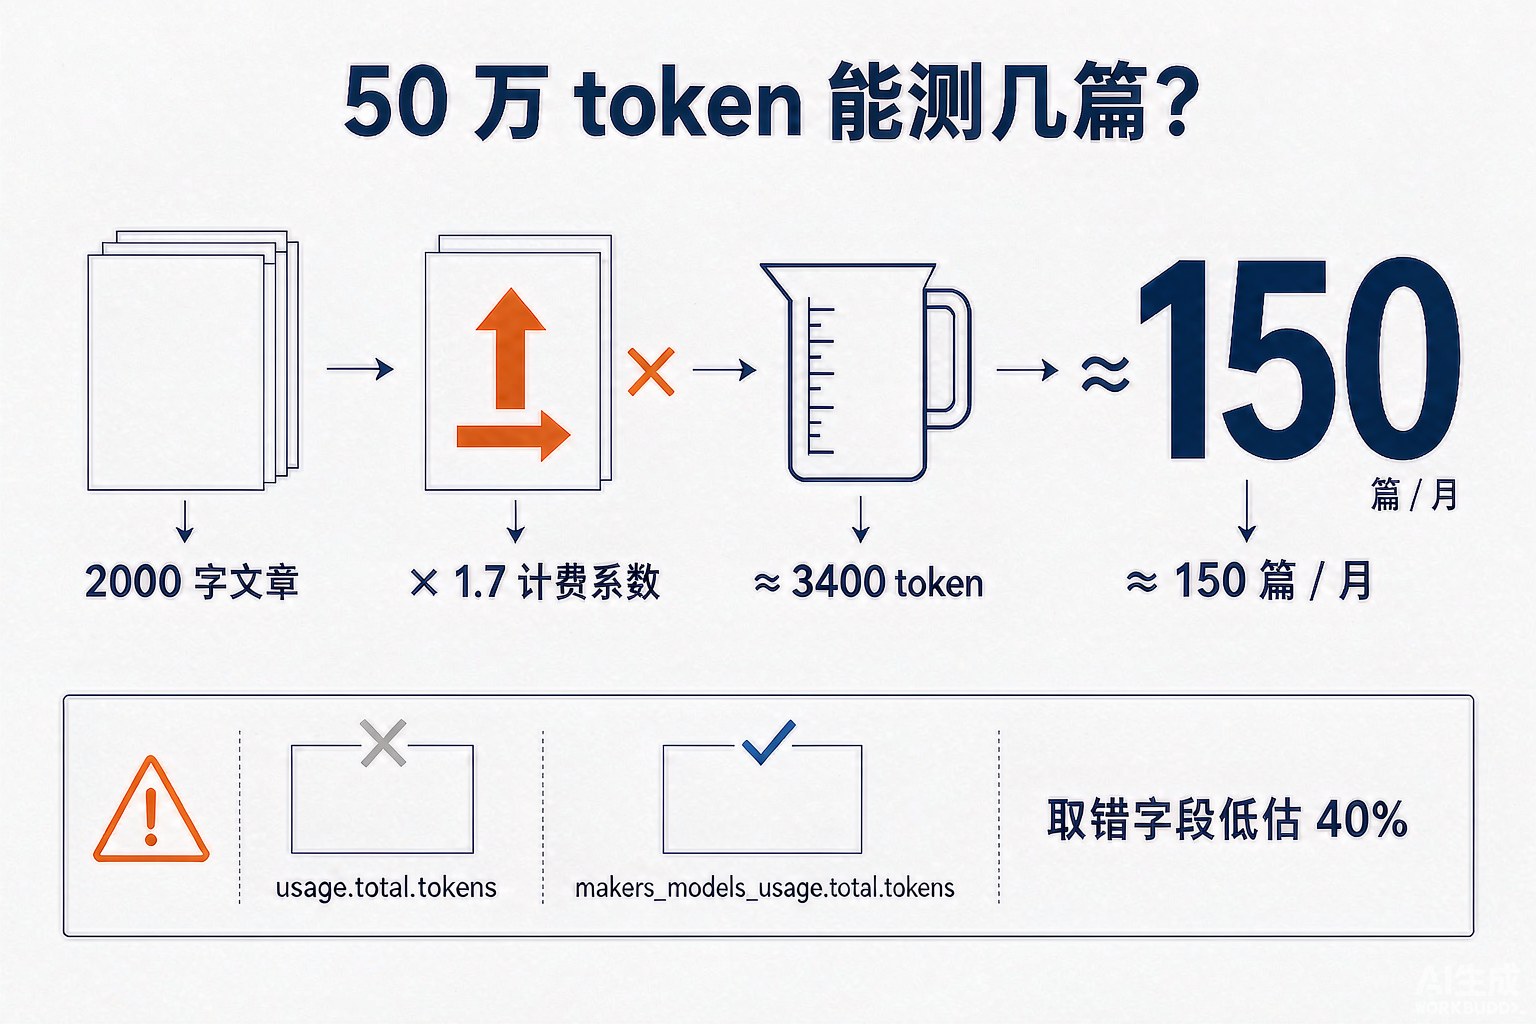
▲ 一条换算链:2000 字 × 1.7 计费系数 ≈ 3400 token,50 万额度 ÷ 3400 ≈ 每月 150 篇。底部两个字段别取错,只认 makers_models_usage。
换算成别的篇幅:
| 文章篇幅 | 单篇 token(估算) | 50 万额度可测篇数 |
|---|---|---|
| 800 字(短评/快讯) | ≈1,360 | ≈367 篇 |
| 1000 字 | ≈1,700 | ≈294 篇 |
| 2000 字 | ≈3,300~3,400 | ≈147~151 篇 |
| 3000 字(长文/论文段落) | ≈5,100 | ≈98 篇 |
下面这张图是按"每天测几篇 2000 字文章"算的月度消耗,虚线是 50 万免费额度的天花板:
月度 token 消耗 vs. 50 万免费额度
结论:每天 3 篇以内很宽裕;一旦到每天 5 篇左右,就基本贴着 50 万的线跑,没有余量。
补充一句:官方页面上写的是"每月免费额度为 50 万 token",配额文档里还注明这是按账号维度计算、所有项目共享的免费版配额,周期从开通 Makers 服务那天起算。所以不是每个 Key 各一份 —— Key 只是同一份额度下的不同凭证。
四、付费怎么买、什么价
免费额度不够时,官方原文是"请联系我们申请开通企业版专属方案"。点进去是腾讯云的商务申请表单,没有公开标价,需要留资询价。
但单价其实是公开的,藏在另一篇计费文档《边缘推理用量单元》里。付费侧走的不是 token,而是另一种计量单位 EIU(Edge Inference Unit,边缘推理用量单元):
| 项目 | 官方价格 |
|---|---|
| EIU 单价(中国大陆站) | 0.001 元 / EIU(1 元 = 1000 EIU) |
| EIU 单价(国际站) | USD 0.000143 / EIU |
| 文本检测 zhuque-text | 40 EIU / 次 —— 单次最多 1000 字符;不足 1000 字符按 1 次;超过则每 1000 字符算 1 次,向上取整 |
| 图片检测 zhuque-image | 30 EIU / 张 |
折算成人话:
- 0.04 元 / 千字符;
- 一篇 2000 字文章 = 2 次 = 80 EIU = 0.08 元;
- 1 万篇 2000 字的文章 = 80 万 EIU = 800 元;
- 图片检测 0.03 元 / 张。
官方文档里还给了个可对照的例子:单次检测 22000 字符 → 按每 1000 字符 1 次向上取整 = 22 次 → 22 × 40 = 880 EIU → 0.88 元。算法和我们上面的口径完全一致。
两个必须注意的点:
- 这套 EIU 计费仅对企业版套餐开放。官方文档原话是"该功能仅对企业版套餐开放。如需使用,请联系我们开通"——个人版/免费版拿不到这个按量通道。
- 免费额度和付费是两套计量口径。免费的内置模型按 token 扣(≈1.7×字数);付费的 Makers Model Pro 按 EIU 扣(按次/每千字符)。两边数字不能直接换算对比,做预算时别串了。
五、顺带算一笔:不花钱的路子
如果只是想偶尔验几篇文章,其实还有两个零成本入口:
| 入口 | 免费额度 | 适合 |
|---|---|---|
| 朱雀官网网页版 matrix.tencent.com/ai-detect |
登录后每日 20 次文本检测,单次 ≤2000 字 | 手动零星检测 |
| EdgeOne Makers 内置模型 @makers/zhuque-text |
每月 50 万 token(≈150 篇 2000 字) | 接入自己的流水线批量跑 |
按 2000 字一篇算,官网网页版每天 20 次、天天用满,一个月理论上有 600 次;但如果要自动化、批量、接进自己的内容流水线,还是 Makers 的 API 更实际 —— 50 万 token 对应的 ≈150 篇/月,对个人站长的日常发文量是够的。
六、几条实操提醒
- 日志里存的额度字段别存错。落库、做看板、写告警,一律取
makers_models_usage.total_tokens;取usage.total_tokens会系统性地低估约 40%。 - 2000 字是个敏感边界。付费侧按"每 1000 字符一次、向上取整",1001 字和 2000 字都是 2 次计费 —— 换句话说,刚过 1000 字就白送一半。要控成本,把单篇拆到刚好卡在 1000 字整会更划算。
- 免费额度按账号共享,不是按 Key。多建几个 Key 不会多出额度。
- 接口会重新切段。返回的
segment_labels段落划分跟原文自然段并不一一对应(官方社区已有确认),别按索引硬对齐,要用片段文本回原文做匹配。 - 检测结果是参考值。官方明确写了"AIGC 检测结果仅供辅助参考,不构成确定性结论"。
七、数据来源
- 腾讯云文档《边缘安全加速平台 EO · 使用朱雀模型》—— cloud.tencent.com/document/product/1552/137539(最近更新 2026-10-09)
- 腾讯云文档《边缘安全加速平台 EO · 边缘推理用量单元》—— cloud.tencent.com/document/product/1552/136025(最近更新 2026-08-19)
- 腾讯云开发者社区提问《调用朱雀返回按段落返回置信度时…》—— 真实调用返回样本(2026-10-09)
- EdgeOne 文档《Limits》—— 免费版内置模型配额 500,000 tokens/month
说明:官方并未公布"每字折算多少 token"的精确公式,本文的 1.67~1.7 倍系数是从两组真实返回数据反推得出,2000 字 ≈3300~3400 token、50 万 ≈150 篇均为估算值,用于预算参考。要精确对账,请以控制台「Makers → 模型用量数据总览 → 内置模型」的官方统计为准。
发表评论: